ひとことで言うと
NVIDIAがドイツのベルリンで開催されたイベントで、手元のパソコンや専用マシンだけで本格的なAIエージェントを動かすためのハードウェアとソフトウェアの最新ラインアップを公開しました。クラウドに頼らずプライベートな環境で高速にAIを動かせるのが特徴です。
何が発表されたのか
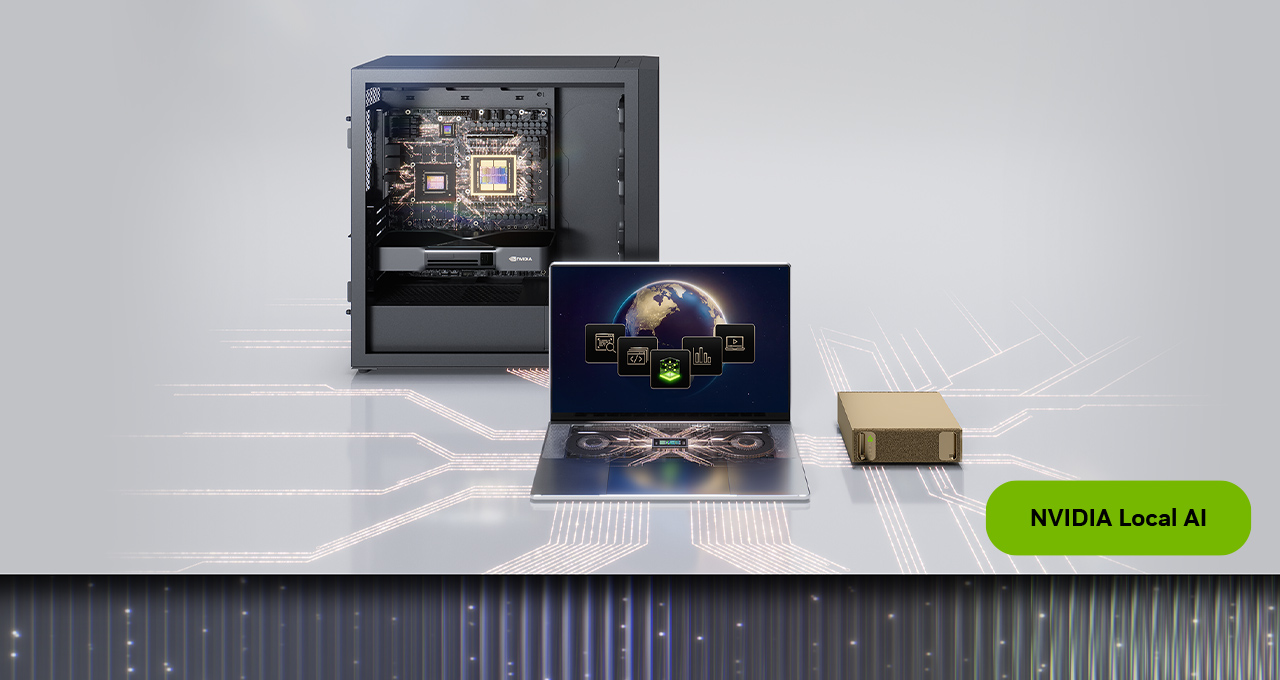
NVIDIA日本版ブログによると、GTC BerlinにおいてローカルAI向けのフルラインアップが紹介されました。パーソナルエージェント向けの「RTX Spark」や、開発者向けの「DGX Spark」、そして企業のチームに対応する「DGX Station」など、ハードウェアの展開がさらに加速しています。今回はハードウェアの発売に加え、専用のエージェントアプリ、新しいコーディングモデル、推論の高速化といったソフトウェア側のアップデートも同時に発表されました。
発表された機能・アップデートの全容
RTX Sparkによるパーソナルエージェントの強化
RTX SparkはWindows PC向けの新しいプラットフォームで、最大128GBの統合メモリと1ペタフロップスのAI演算能力を備えています。完全にローカルで動作するプライベートなAI向けのエージェントアプリ「Underdog」の提供が開始されており、専用の推論エンジン「Husky」によってユーザーのデータを外部に送信せずにエージェント作業を進められます。
DGX Spark 64GBの発売と複数台のクラスター連携
開発者向けの「DGX Spark 64GB」システムが10月23日に発売されました。内蔵のネットワーク機能と「NVIDIA Sync Cluster Assistant」を利用することで、手動構成による最大8台のDGX Sparkを接続し、1TBの統合メモリを持つクラスターを構築できます。これにより、より大きなモデルや複数のエージェントの同時実行が可能になります。
DGX Stationの企業向け管理機能とWindows版の予告
大規模なチーム向けのDGX Stationには、新しいセキュリティ統合が追加され、ITチームによる管理性が向上しています。また、12月にはWindows版の「DGX Station for Windows」が登場し、製造業向けの様々なプロフェッショナルアプリケーションやエージェントハーネスをサポートする予定です。
コーディング特化モデル「Recursive Flint」の提供
フロンティアAI研究所のRecursive Superintelligenceが開発した、高速かつ正確なコーディング向けローカルLLM「Recursive Flint」が提供開始されました。総パラメータ数400億、アクティブパラメータ数2.5億のMixture of Expertsモデルであり、専用カーネルによってRTX Spark上での生成速度が向上しています。
公開初日からの新しいAIモデルのサポートと推論の高速化
NVIDIAは、Nemotron Bolt E4BやBlack Forest LabsのFLUX 3 Image Kleinなど、新しいモデルの公開初日からのサポートを追加しました。さらに、llama.cppやvLLMといったオープンソース推論エンジンの最適化を進め、エージェント型タスクの処理速度を最大1.4倍に引き上げています。
性能・ベンチマーク
元記事では、特定のベンチマークスコアの具体的な数値一覧表などは掲載されていませんが、コーディングモデル「Recursive Flint」がSWE-Bench Pro v2やTerminal-Bench 2.1などのエージェント型コーディングベンチマークで優れた性能を発揮することが言及されています。また、最適化された環境下での生成速度の向上(RTX Spark上で最大55%向上など)が示されています。
競合サービスとの比較
(編集部注:OpenAIやAnthropicなどのクラウド型AIサービスと比較した場合)クラウド型AIがインターネット上の大規模サーバーで処理を行うのに対し、NVIDIAのローカルAI環境はユーザーの手元のハードウェア上で直接モデルを実行します。データが外部に出ないセキュリティの高さや、ネットワーク遅延のない応答速度において優位性がありますが、実行できるモデルの規模は手元のハードウェアのメモリ容量に依存するという制約があります。
料金・提供プラン
元記事では具体的な製品価格やAPIの従量課金についての言及はありません。ハードウェアはパートナー企業各社からの販売となり、オープンウェイトモデルについてはHugging Face等からダウンロードして利用する形式となっています。
日本から使う方法
- ASUS、Dell Technologies、HP、Lenovo、MSIなどのパートナー企業から、RTX SparkやDGX Spark、DGX Stationの各システムを購入する。
- Hugging Faceなどのプラットフォームから、公開されているオープンウェイトモデルやチェックポイントをダウンロードする。
- NeMo AutoModelや各種推論エンジン(llama.cpp、vLLM)を活用してローカル環境にセットアップする。
- 日本語対応やリージョン制限についての特段の記載は元記事にありませんが、オープンモデルの利用やハードウェアの国内調達状況に準じます。
誰にどう効くのか
エンジニアにとっては、手元のマシンやクラスター環境で大規模なオープンモデルやエージェントを自由にカスタマイズして検証できる点が大きなメリットです。企業の情報システム部門や経営層にとっては、社外にデータを漏らすことなくセキュアなAI環境をオンプレミスで構築・管理できる体制が整います。
まとめ
NVIDIAによる今回の発表は、ローカル環境でのAIエージェント運用をハードウェアとソフトウェアの両面から強力に後押しするものです。読者は、自社の開発規模や用途に合わせて最新のハードウェアやオープンモデルの導入検討を進めるとよいでしょう。