概要
NVIDIAが、AIの学習が途中で止まったときに自動で直すツール「NVIDIA Recovery」を紹介しました。
異常を見つけ、原因の機械を外し、保存した地点から再開させます。これを人の代わりに24時間続けます。
GPUをたくさん使ってAIを育てる、インフラ担当の人にうれしい仕組みです。
続報(11月3日):連携するオープンソース診断ツールの詳細が判明
NVIDIA Developer Blogは2026年11月3日、既に公開されている「NVIDIA Recovery」と連携するオープンソースの診断ツール「NVIDIA Attribution」の詳細を発表しました。分散AIワークロードの失敗原因を特定する仕組みが明らかにされています。
2つのコンポーネントと対応環境の拡大
NVIDIA Attributionは、REST APIを提供する「Attribution Service」と、スケジューラーやテレメトリーを接続するPython製の「Attribution Blueprint」の2つのコンポーネントで構成されます。従来のSlurmに加え、KueueやKubernetesなどにも対応している点が特徴です。ログやメトリックのコネクターとして、Loki、ローカルファイル、Kubernetesのポッドログ、PromQLなどをサポートしています。
4段階の診断プロセスと実績
システムは、ワークロードの範囲特定、観測データの収集、決定論的ルールによるイベントの抽出と相関付け、構造化された結果の返却という4段階で動作します。例えば、1つのGPUで発生したハード障害を根本原因とし、他ランクのNCCLエラーを支援症状として保持することで、独立した通信エラーではなくハードウェア故障として判断します。NVIDIAのAIインフラストラクチャでは数年前から本番稼働しており、数十万基のGPUを対象に週数百万件のワークロードを解析し、ホストやスイッチポート周辺のファブリック障害パターンの特定に活用されています。
出典: NVIDIA Developer Blog「Diagnose Distributed AI Workload Failures with NVIDIA Attrib」
何が発表された?
読者の疑問:誰が何を出したの?
NVIDIAの開発者ブログ(11月2日付)で、「NVIDIA Recovery」が紹介されました。NVIDIA DSX OSというソフト群の一部で、オープンソースです。
クラスター(GPUをまとめたシステム)の学習ジョブ全体を対象に、中断からの復旧を自動化します。使う手がかりは、アプリのログ、GPUの指標、スケジューラー(仕事の割り振り役)の信号です。
位置づけは、すでにソースコードが公開された提供中のツールです。対応するスケジューラーはSlurmです。Kubernetesは「ロードマップ上」とされ、まだ対応していません。
前と何が違う?
読者の疑問:従来のやり方と何が変わるの?
人手の復旧を、4段階の自動ループにした
従来は中断のたびに、人がログを調べ、故障箇所を切り分け、保存地点から再開していました。その間GPUは遊びます。
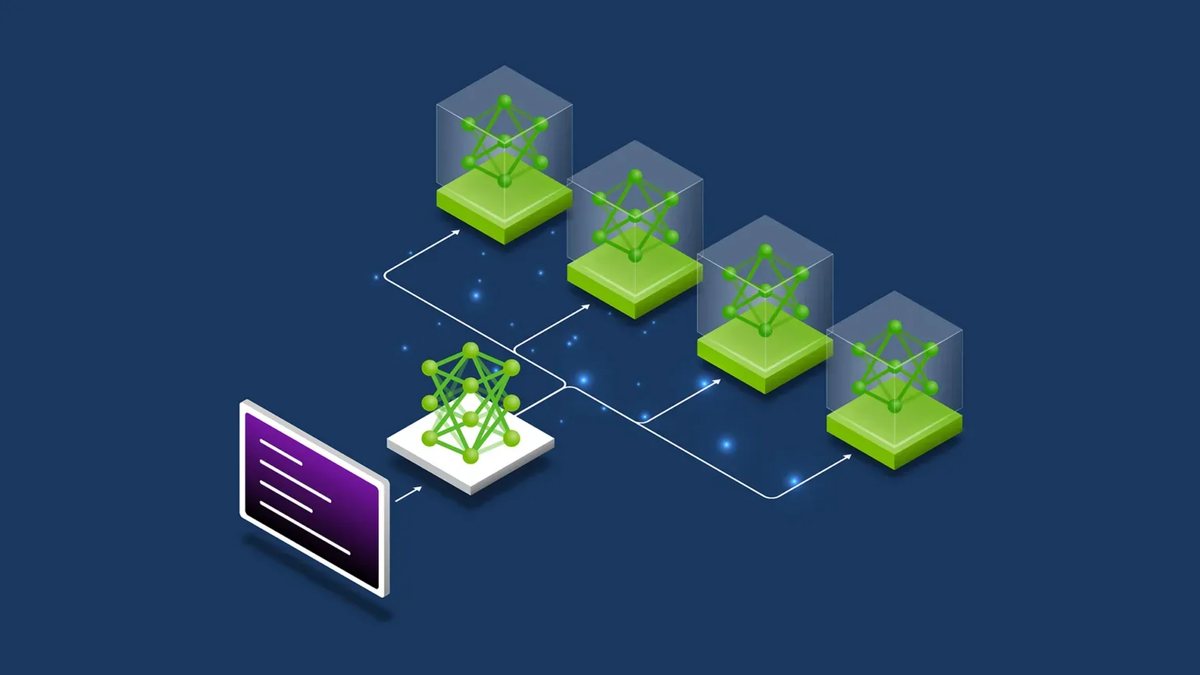
NVIDIA Recoveryは、これを次の4段階にまとめています。
- 検知(Detect):クラッシュ、停止(ハング)、遅れ(ストラグラー)を見つけます。PyTorchやNCCLの失敗、CUDAエラーなどを認識します。
- 原因の分類(Attribute):ログと信号から中断の種類を分けます。NVIDIA Attributionを組み合わせると、ハード故障、システムソフトの問題、アプリのバグまで見分けられます。
- 隔離(Isolate):問題のあるノード(マシン)を再開の対象から外します。判断に時間がかかっても、通常の割り振りが進む安全装置もあります。
- 再開か停止(Restart or Stop):保存済みのチェックポイントから再開します。新しい保存が設定回数だけ続かなければ、再試行をやめられます。
既存の部品の「すき間」を埋める位置づけ
NVSentinelはKubernetes上でGPUの異常を監視し、問題ノードを切り離します。NVRxは個々の学習ジョブの中での回復や停止検知を担います。
NVIDIA Recoveryは、複数のジョブをまたぐ再開と、ノード除外の管理を担当します。各部品は独立しており、自前の部品に置き換えられます。
Slurmとのつなぎ方はアプリを変えない
Recoveryは、制御側のサービスとして動きます。HTTPまたはgRPCのAPIで、スケジューラー側の部品と話します。
Slurm向けには、参考実装の「Advisor Controller」があります。Helmチャートで導入でき、2つの方式があります。
- クラスター内で動かす方式
- SSHで遠隔からSlurmにつなぐ方式(クラスター内に新しいサービスを足さない)
SSH方式は、変更の申請やセキュリティ審査が必要な現場向けです。アプリのコードは変えません。
まず見るだけの「監視モード」で始まる
新規導入は、標準で監視モードです。助言を出して、やるはずだった内容を記録しますが、スケジューラーには何もしません。
助言を自社の判断と比べ、納得できたらクラスターごとに実行モードへ切り替えます。IBM Researchも自社のSlurmクラスターで同じ順で進めたと、元記事は述べています。
すべてを記録する監査証跡
検知パターン、取った行動、時刻、ジョブの識別子、原因の判定が、残る記録になります。Recovery Consoleという画面で、スケジューラーの種類をまたいだ状況を見られます。
数字で見るとどう変わった?
読者の疑問:効果は数字で出ているの?
前の版との比較数値は示されていません。示されたのは次の運用実績です。
- 期間:7月9日〜10月9日、1つの学習クラスター
- 対象:1日あたり200件近いジョブ
- 異常の検知:約8,550件
- 平均の検知までの時間:69秒
- 平均の復旧動作までの時間:94秒
復旧動作の時間は、自動の操作が終わるまでです。実際に学習が進み出す時刻は、割り振りとチェックポイントの読み込みで決まります。
また元記事は、GPUが1日壊れない確率が99.9%でも、10,000個を使うジョブが無事に1日終える確率は約0.005%と説明しています。Metaの24,000個のA100を11カ月調べた研究では、ハード故障で止まったジョブは1%未満でした。ただしそのジョブがGPU稼働時間の19%を占めました。
ライバルと比べてどう?
読者の疑問:他社の似た仕組みは?
元記事に他社比較はありません。ここは編集部の見方で、元記事の範囲に絞ります。
- 優位な点:NVIDIAのGPU基盤の部品と組み合わせやすく、オープンソースで、自前の部品にも置き換えられます。
- 弱い点:対応はSlurmだけです。Kubernetes対応は予定にとどまります。
クラウド各社にも障害時の自動復旧機能はあります(編集部注)。ただし具体的な機能差は、確認できていません。
料金は?
読者の疑問:お金はかかる?
オープンソースで、元記事に料金の記載はありません。ソースコードはdsx-ai-factory/NVIDIA-Recoveryのリポジトリで公開されています。GPUなしでローカルに試せるクイックスタートがあります。
運用に使うGPUクラスターやSlurmの費用は別です。その金額は、元記事に書かれていません。
日本で使える?
読者の疑問:日本でも使える?
日本での提供条件は、元記事に記載がなく、まだ分かりません。公開されたオープンソースなので、国を限定する説明はありません。
- 元記事が案内する入口は、リポジトリのクローンです。
- 次にクイックスタートで、GPUなしのローカル環境に導入します。
- Slurmへの導入は、運用者向けデプロイ手順書を見ます。
- 資料は英語です。日本語対応は確認できていません。
- 最初は監視モードで試す設計です。
自分にはどう関係する?
読者の疑問:自分の仕事やお金には関係ある?
会社員として
GPUクラスターで学習ジョブを動かす基盤担当には、直接関係します。夜間の中断対応や、ジョブごとの復旧の取り決めを減らせる可能性があります。
そうでない人には、直接の影響は小さいです。
副業・独立を考えている人
この立場への直接の影響は小さいです。大規模なGPUクラスターを前提としたツールだからです。
お金・資産づくりの面で
この立場への直接の影響は小さいです。元記事は、止まるとGPUが遊んで計算コストと学習時間が増える、という構図を述べています。ただし、金額の数字は示されていません。
これまでの流れ
- 10月23日:NVIDIAがGTC Berlin 2026で、次世代Vera RubinやAI工場DSX PODを発表(GTC 2026の発表記事)
- 11月3日:NVIDIAが分散AIワークロードの共通定義「Workload Map」を公開(Workload Mapの解説)
- 11月2日付の元記事:学習の中断を自動復旧するNVIDIA Recoveryを紹介
AI工場全体の設計から、運用の自動化へと発表が広がっています。
まとめ
NVIDIA Recoveryは、GPUクラスターの学習を止めずに保つための運用ツールです。Slurm対応で、Kubernetes対応はこれからです。
導入に関心がある人は、クイックスタートを試し、最初は監視モードで自社の判断と比べてください。