速報ElevenLabsが音響効果モデル「SFX v3」公開 複数指示への追従性が向上
NVIDIA公開情報(2026/11/03)掲載: 読了 3分

AI半導体のNVIDIAが公開、複雑なAIフレームワークを効率管理する『Workload Map』とは

制作:編集方針・AI利用と事実確認

3秒でわかる要点

  1. 1NVIDIAが分散AIワークロードの共通定義を提供するWorkload Mapを発表しました。
  2. 2JobSetやPyTorchJobなどの定義をあらかじめ備えたカタログが付属します。
  3. 3CLIやRun:aiなどのツールで同じ定義を再利用し、構成やGPU要求量を簡単に把握できます。
今すぐ使える

サイソクの判断

リポジトリからカタログを確認し、手元のKubernetes環境やCLIでの検証を始めてみましょう。

日本から使える?
利用できる
料金は?
オープンソース・無料
無料で試せる?
無料で試せる
誰に向いている?
インフラエンジニア

11/3時点の判定。発表内容から編集部AIが判定しています。最新の提供状況は公式情報をご確認ください。

仕事・お金にどう活かせる?

関係:一部の人に
  • Kubernetes環境でAIインフラを管理するインフラエンジニアやプラットフォーム担当者に直接関係します。
  • フレームワークごとの個別のアダプター開発やメンテナンスの負担を軽減できます。

発表内容をもとにした一般的な情報です。投資や契約の判断は、公式情報を確かめたうえでご自身で行ってください。

NVIDIA Developer Blogの公式発表によると、同社は分散AIワークロードの定義を共通化し、フレームワークごとの管理を効率化する「NVIDIA Workload Map」を公開しました。専用の解析コードを減らし、様々なツールで共通の定義を再利用できるようになります。

本ページはプロモーションを含みます

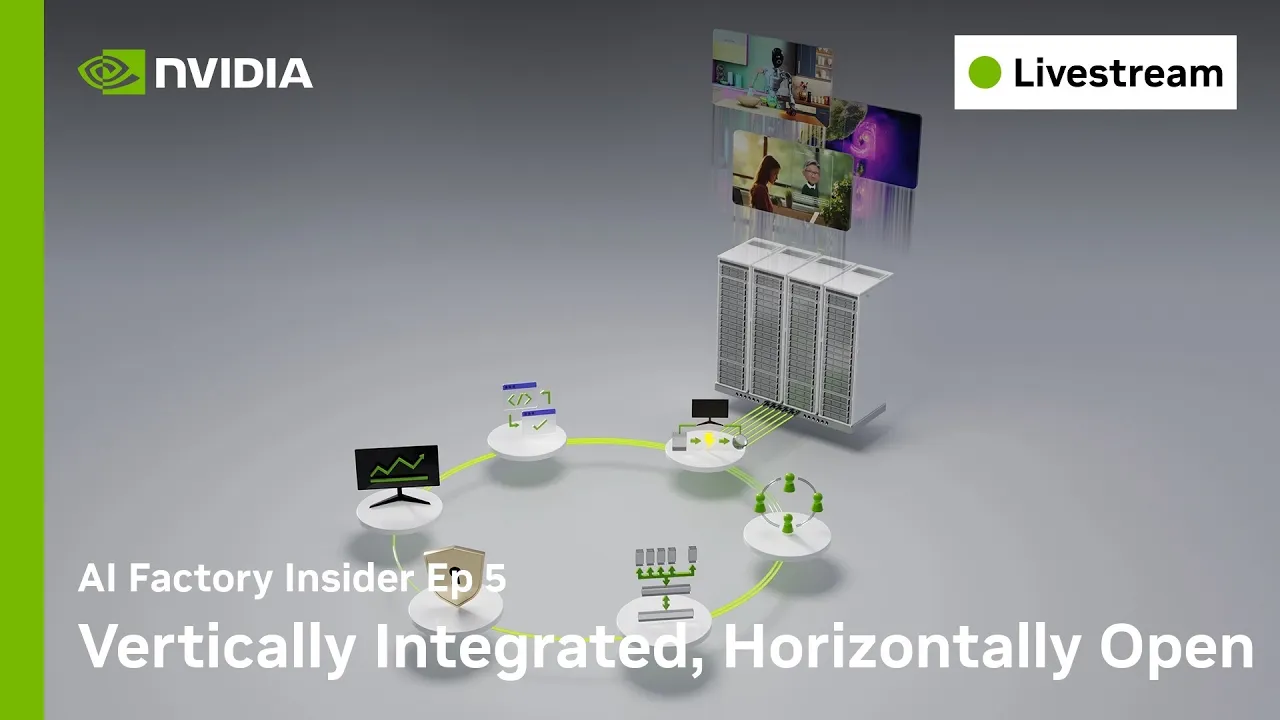
画像:NVIDIA(公式発表より)

N出典: NVIDIA Developer Blog「Support New AI Frameworks Faster Using NVIDIA Workload Map」

かんたん版:専門用語を使わずに説明しています

ひとことで言うと

NVIDIA Workload Mapは、バラバラになりがちなAIの仕事の仕組みを、共通のルールでまとめて管理しやすくする仕組み(=AIインフラの共通辞書)です。

何がすごいの?

Kubernetes(クーベネティクス:コンテナを効率よく動かす仕組み)では、使うAIフレームワークごとに設定方法が違います。そのため、ツールごとに専用のプログラムが必要でした。 NVIDIA Workload Mapを使うと、ひとつの定義を書き直すだけで、専用のツールやCLI(黒い画面で文字を打って操作する仕組み)から同じように状態を読み取れるようになります。

自分に関係ある?

会社でAIのインフラを管理するエンジニアなら、バラバラの設定に合わせたプログラムを作る手間を減らせます。企画や経営の立場では、AI開発の基盤を整える際の効率化につながります。

使ってみるには

公式のリポジトリから定義のカタログやCLIを手に入れて試すことができます。Homebrewを使って手元のパソコンにCLIをインストールし、動作を確認することが可能です。

概要

NVIDIA Developer Blogによると、同社はAIフレームワークの管理を効率化する「NVIDIA Workload Map」を公開しました。 バラバラになりがちな分散AIワークロードの設定を共通化する仕組みです。 専用の解析コードを何度も書く必要をなくします。 インフラを管理するエンジニアの負担を大きく減らします。

何が発表された?

今回の発表は、NVIDIA DSX AI Factoryプラットフォームの一部として提供されます。 これはオープンソースのオープンなコンポーネントです。 Kubernetes環境で動く様々なAIフレームワークの構造を共通で定義します。 スケジューラーや管理プラットフォームから直接解釈できるようにします。

提供されている主な要素や対応する仕組みには、次のようなものがあります。

  • JobSetやPyTorchJobなどの定義済みカタログ
  • ライブオブジェクトを構造化して解決するGoライブラリ
  • ワークロードの構造を可視化するCLI(kli)
  • KAI Schedulerによるギャングスケジューリングの連携
  • NVIDIA Run:aiでの統合管理
あわせて読みたいNVIDIA PAIRとは:複数PCでローカルAIを分散処理する無料ソフト

フレームワークごとのアダプターがなぜ必要だったのか?

Kubernetes上で動く実際のAIワークロードは単一のポッドではありません。 役割を持つ複数のポッドやレプリカ数を含む小さなツリー構造になっています。

ダッシュボードやコスト管理ツールなどを作る開発者は大きな課題を抱えていました。 カスタム資源(CRD)ごとに構造を解釈する専用のアダプターを個別に用意しなければなりませんでした。 そのため新しいフレームワークに対応するたびに開発のロードマップに項目の追加が必要になりました。 これがサポートが遅れる原因になっていました。

共通のワークロード定義はどう機能するのか?

Workload Mapは複数の要素で構成されています。 Kubernetesのカスタム資源(CRD)とそれを解釈するGoライブラリです。

定義ファイルには重要な情報が記述されます。 ポッドのテンプレート、レプリカ数、ステータスフィールドの場所です。 たとえばJobSetの設定ではjq式を使います。 独自の条件から「Running」や「Completed」といった共通の語彙にマッピングします。 これによりフレームワーク特有の複雑なスキーマを共通のツリー構造に解決できます。

ツール間でどう再利用されるのか?

作成した一つのワークロード定義は複数のワークフローでそのまま再利用できます。

CLIを使ったワークロードの確認では定義を読み込みます。 これでツリー表示やリソースの合計を把握できます。 またKAI SchedulerやNVIDIA Run:aiなどのプラットフォーム側でも利用できます。 追加の個別コードなしで同じ定義を直接利用して管理や可視化を行います。

日本で使える?

日本からでも今日から内容を確認して利用できます。 GitHub上のオープンソースとして公開されているリポジトリや開発者向けSlackが使えます。

今日から試すための主な手順は次のとおりです。

  • macOSやLinux環境でHomebrewを使い、リポジトリからCLI(kli)をインストールする
  • クラスターのコンテキストを設定し、対応するネームスペースでコマンドを実行する
  • カタログから既存のフレームワーク定義を自分の環境に適用する

自分にはどう関係する?

エンジニアなら

フレームワークごとに異なる設定の仕組みを個別に実装する手間が減ります。 管理ツールの開発や運用を効率化できます。

企画・マーケティングなら

直接的な影響は大きくありませんが理解しておくと便利です。 社内のAI基盤の構築や運用コストの削減につながる基盤技術として把握しておくと役立ちます。

経営者・管理者なら

AI開発を支えるインフラの運用効率が向上します。 新しいフレームワークの導入にかかるリードタイムを短縮できる可能性があります。

まとめ

NVIDIA Workload Mapは複雑なAIフレームワークの管理負担を減らす実用的なアプローチです。 まずは提供されているカタログやリポジトリを確認してみましょう。 手元の環境での検証を進めてみましょう。
出典と更新履歴

出典(公式)
NVIDIA Developer Blog「Support New AI Frameworks Faster Using NVIDIA Workload Map」
日時
公式発表 サイソク掲載
確認方法
公開前に、本文を出典と自動で照合しています(事実確認 100点/100点、70点未満は非公開)。制作と確認の方法
誤りの報告
お問い合わせから受け付けています。直した記事は訂正履歴に残します。

次に読むならこれ

同じ話題の記事使えるAI半導体のNVIDIAが公開、大規模AI向けのKubernetes実行基盤『AICR』とはNVIDIA Dynamoの実行環境をレシピ化するAICRを発表続きを読む

NEWSLETTER

毎朝7時、昨日のAIニュースの要点を5本

前日に出た記事から大きな発表を選び、1本2行でまとめてメールで届けます。無料・いつでも解除できます。

確認メールのリンクを開いた時点で登録完了です。アドレスは配信にだけ使います(プライバシーポリシー)。 配信の内容

大きな速報を、通知ですぐに

主要企業の大きな発表だけ、1日4回まで。夜22時〜朝7時は鳴らしません。いつでも解除できます。

本記事は公式発表の文章をもとにAIが要約・解説して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元記事を読む(解析モデル: gemini-3.5-flash-lite)制作方法と事実確認の手順は編集方針をご覧ください。誤りのご指摘はお問い合わせから受け付けています。