この記事の章立て 概要 何が発表された? 前と何が違う? 数字で見るとどう変わった? ライバルと比べてどう? 料金は? 日本で使える? 自分にはどう関係する? これまでの流れ まとめ 概要
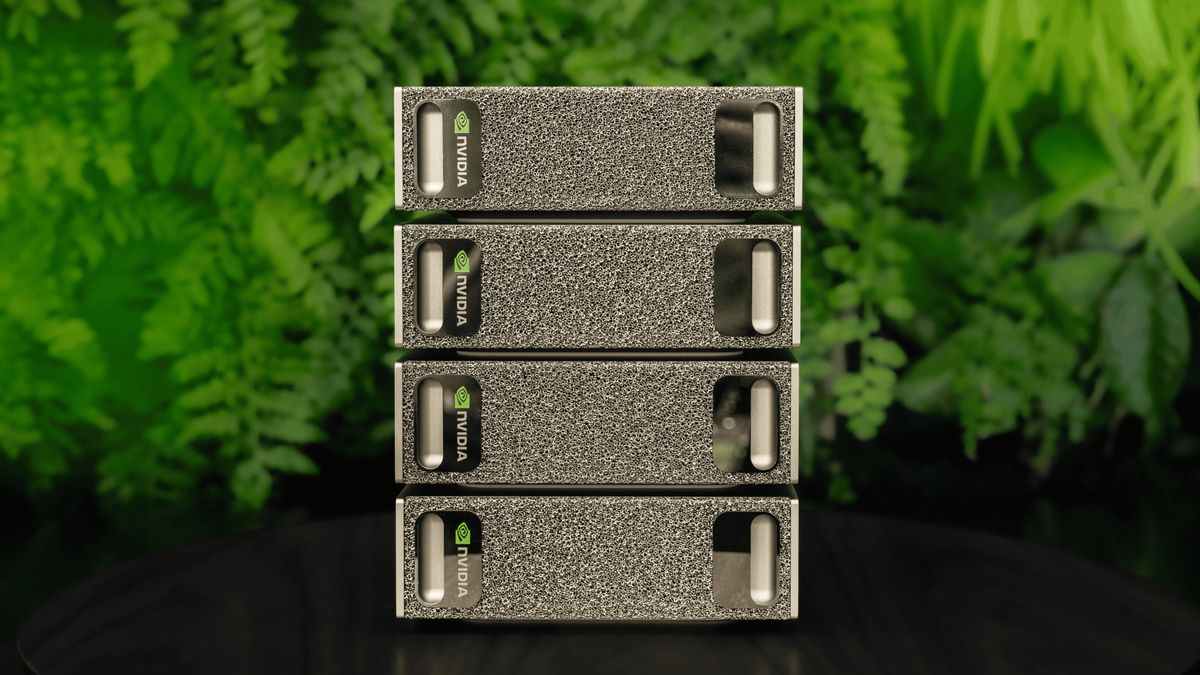
米NVIDIAは公式開発者ブログにて、エッジデバイス向けのAI開発を簡素化する「NVIDIA TensorRT Edge-LLM」を発表しました。DGX Spark 64GB環境をベースとしています。軽量なC++推論ランタイムやCLIツールを提供します。これにより、開発者は数コマンドでAIモデルのダウンロードや最適化を行えるようになります。
物理AIアプリケーションの開発では、限られたメモリや電力の中でモデルを動かすための初期設定が大きな負担となっていました。今回のツールは、そのセットアップの手間を大幅に軽減することを目的としています。
何が発表された?
NVIDIAは2026年10月31日、エッジアプリケーション開発を効率化するためのソフトウェア群を発表しました。対象となるプラットフォームは、64GB構成のNVIDIA DGX Sparkをはじめ、将来的なデプロイ先となる各種ハードウェアが含まれます。
主な構成要素は以下の通りです。
NVIDIA DGX Spark 64GB:プロトタイプ作成、ファインチューニング、テストのためのプラットフォーム
NVIDIA TensorRT Edge-LLM:エッジ向けの軽量C++推論ランタイム
trtedge CLI:モデルのダウンロードやTensorRTエンジンのビルドを行うコマンドラインインターフェイス
OpenAI互換APIサーバー:ローカル環境でのアプリケーション試作を支援するサーバー機能
あわせて読みたい Copilot Fusionとは?料金・使い方と表示されない場合の確認 → 前と何が違う?
CLIによる迅速なセットアップ
これまでのエッジ向けAI開発では、モデルの変換や最適化エンジンを手動で構築する複雑な手順が必要でした。今回の「trtedge」CLIを用います。選んだモデルのダウンロードと最適化されたTensorRTエンジンのビルドが数コマンドで完了します。
共通のランタイムによる開発と展開の一体化
DGX Sparkでの開発から、実際の製品展開先となるターゲットプラットフォームまで同一の推論フレームワークを利用できます。これにより、開発環境と実機環境の差異によるトラブルを抑えられます。
DSparkによる投機的デコーディングのサポート
ドラフトモデルを用いて複数のトークンを同時に提案・検証する「DSpark speculative decoding」をサポートします。これにより、品質を保ったままトークン生成速度を大きく引き上げることが可能になりました。
数字で見るとどう変わった?
TensorRT Edge-LLMとNVIDIA Nemotron-3.5 Lightning(30Bモデル)をDGX Spark 64GB上で実行した際のパフォーマンスが公開されています。DSpark speculative decodingの有無による違いは以下の通りです。
比べること
DSpark OFF
DSpark ON
変化
SpeedBench 1K 生成速度
73.3 tokens/s
108.5 tokens/s
約1.5倍に向上
SpeedBench 2K 生成速度
72.8 tokens/s
105.3 tokens/s
約1.4倍に向上 イ
HumanEval 生成速度
73.4 tokens/s
126.9 tokens/s
約1.7倍に向上
なお、DSpark有効時のピークシステムメモリ使用量はOSを含めて27.9GBに収まっています。また、HumanEvalプロンプトにおける中央値のTTFT(Time to First Token:最初のトークンが出力されるまでの時間)は、DSparkのON/OFFでそれぞれ98.7ms、98.1msとほぼ同等レベルを維持しています。
ライバルと比べてどう?
(編集部注:競合他社のエッジ向け軽量推論フレームワークと比較して、NVIDIAのエッジ・車載向けハードウェアエコシステムと直接連携する点が最大の特徴です。Jetson ThorやDRIVE AGX Thorといった具体的な展開先を見据えた一貫したツールチェーンを提供します。組み込み開発者に対して高い利便性を持っています。)
料金は?
NVIDIA Developer Blogにおける今回の発表およびTensorRT Edge-LLMの利用に関する直接的なライセンス費用や価格の言及はありません。対応するハードウェア環境を用意すれば、開発者向けツールとして利用可能となっています。
日本で使える?
日本国内のユーザーも、公式開発者ブログや関連ドキュメントにアクセスして今日から試すことができます。
今日から試すための具体的な手順は以下の通りです。
対応するNVIDIA DGX Spark環境(CUDA 13、TensorRT 10.16.1.11以降、Python 3.10〜3.12)を準備する
端末で仮想環境を作成し有効化する
python -m pip install "tensorrt-edgellm[server]==0.11.1"を実行してインストールするtrtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4などのコマンドでモデルのダウンロードとチャットを開始する
自分にはどう関係する?
エンジニアなら
車載やロボティクス向けのエッジAI開発において、モデルの最適化やAPIサーバーの構築にかかる手間を大幅に削減できます。ローカル環境でのプロトタイピングが迅速に行えるため、検証サイクルを早められます。
企画・マーケティングなら
エッジデバイス上で高速かつ低遅延に動作する生成AI機能を、自社製品やサービスにどのように組み込めるか検討を進められます。具体的な性能ベンチマークを参考にできます。
経営者・管理者なら
データセンターに依存しないエッジAIの展開を加速するための基盤技術として評価できます。開発効率の向上やハードウェア投資の最適化を見据えることが可能です。
これまでの流れ
次世代ハードウェアの発表に続き、今回はエッジデバイスでのAIモデル実用化を支える具体的な開発者向けソフトウェアツールが一般に公開された形となります。
まとめ
TensorRT Edge-LLMを活用することで、エッジ向けAIモデルの導入と最適化が手元で容易に行えるようになります。
読者は公式ブログのチュートリアルを参照してください。手元のDGX Spark環境でモデルの実行やAPIサーバーの構築を試してみるとよいでしょう。