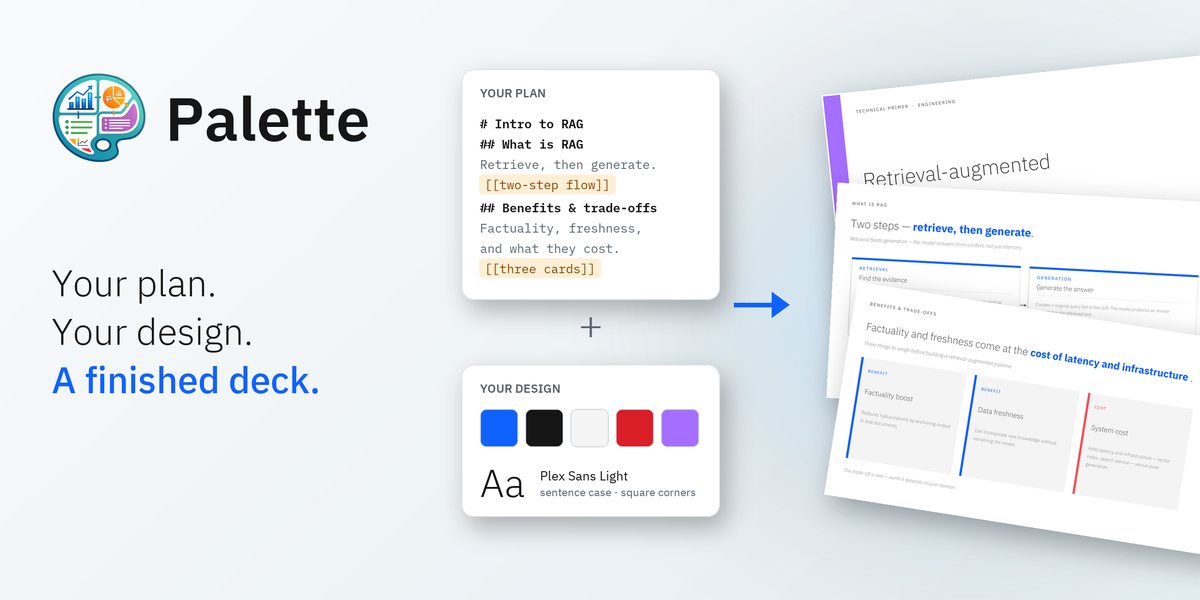
Paletteは、資料を自社のデザインに沿って作るための小型AIモデルです。
大きな生成AIにスライドを頼むと良い資料ができますが、何度頼んでも似た見た目になりがちです。自社のテンプレートに寄せたいときや、資料の内容を社外に出せないときには、このやり方では足りません。
そこでIBM Researchは、自社で持てるモデルを使う方向を選びました。Hugging Faceの公式ブログに掲載された発表によると、重みを公開したモデル(オープンウェイト)を、自社の環境で動かす前提です。
対象は200億パラメーター(AIの規模を表す数)のモデルです。学習データは IBM Design Language に沿って作られています。
ただ、こうした小型モデルは、そのままでは資料が崩れやすいとされています。文字が背景に埋もれたり、本文がスライドからはみ出したり、図形が重なったりします。
理由は、モデルが完成した画面を見ずにコードを書くことにあります。たとえば、75文字のタイトルが56pt(文字の大きさの単位)で2行に収まるかは、頭の中で計算するしかありません。
Paletteは、人が資料を作る流れをまねています。まず「設計者」の役が、資料全体の構成と、各スライドの内容・レイアウト・配色・書体をまとめた設計書(JSON)を作ります。
次に「コーダー」の役が、1枚ずつのスライドを、pptxgenjsというJavaScriptのコードに書き起こします。両方の役は、1つのLoRA(既存のモデルに小さな追加学習を重ねる方法)で動きます。
役割を分けた効果は速さにも出ています。スライドごとの前提が先に決まるので、コーダーは各スライドを並列に書けます。
発表では、コーディングの段階が約6〜7倍速くなったとしています。設計書は人が読んで直せるため、1枚だけ配置を変えたいときに、資料全体を作り直さずに済みます。
学習データは、もともと公開されたものがなかったため、Palette側で作りました。
大きな教師モデル(学習データを作るための大きなAI)に、ジャンル・枚数・レイアウト・指示文を決めた「レシピ」を与えます。このレシピから、約1,000本・約1万枚分の資料を生成しています。
生成した資料はすべて描画し、重なりやはみ出しを検査しました。判断の理由も学習に入れています。たとえば、四半期の売上を表ではなく棒グラフにした理由を、傾向を伝えるためだと説明文として残します。
利用者は、資料の中に[[make this a timeline]](タイムラインにする)のような指示を書けます。学習データには、レイアウト・トーン・読み手・順番・省く内容など12分類の指示が入っています。言い回しも変えてあるため、同じ意味の別の書き方にも反応しやすくなっています。
検査で壊れたスライドを直す仕組み
モデルの出力は、そのまま返しません。まず、色コードの形式の崩れなど既知のミスを、単純なルールで直します。
次に、各スライドを描画し、文字の重なり・切れ・はみ出しを数えます。問題のあるスライドだけ、別の編集用モデルがコードを書き直します。
大事なのは、書き直しが改善したと確認できたときだけ採用される点です。改善しなければ、元のスライドが残ります。発表では、PresentBenchの131本の資料で、この仕組みにより平均3.5点上がったとしています。
評価はPresentBenchという評価テストで行われました。資料を、基本・見た目・網羅性・正確さ・忠実さの5つの観点で採点します。
今回は元の文書から、別の大手AIモデルが設計書を作り、Paletteがそこから資料を作る条件です。結果は次のとおりです。
- 経済: 1位
- 教育: 1位
- Talk(語りが中心の資料): 3位
- 3分野の平均: 59.7点で2位。首位のNotebookLMは60.8点
数字の正確さと構成が効く分野では強く、語りが中心の資料では順位が下がりました。ほかにはManus 1.6など5つのシステムと比べられています。他社の数値はPresentBenchの論文の値です。
日本の企業が使うなら、確認したいこと
自社の環境で動かす設計なので、資料の内容を外部のサービスに預けずに済みます。
一方で、自社テンプレートをそのまま使う仕組みは、まだ確定していません。発表では、既存の.pptxファイル1〜2本から見た目を移す方法を検討中とされています。学習し直さずに済ませる狙いです。
日本語の資料で同じ精度が出るかは、今回の発表から分かりません。今回の発表は研究としての検証の内容です。
配布の時期が決まるまでは、公式ブログの続報を確認するとよいでしょう。資料の型(色・フォント・配置のルール)を社内でまとめておくと、後で試しやすくなります。