AIコーディングエージェントを使う開発チームには、古いTODOメモの整理が作業時間と費用に直結します。AIを使っていないチームには、今回の分析で何かが変わることはありません。
エージェントとは、コードの調査から修正まで、自分で手順を進めるAIです。GoogleのDevelopers Blogは、その動きを大規模な作業記録から測りました。
 画像:Google Developers(公式発表)
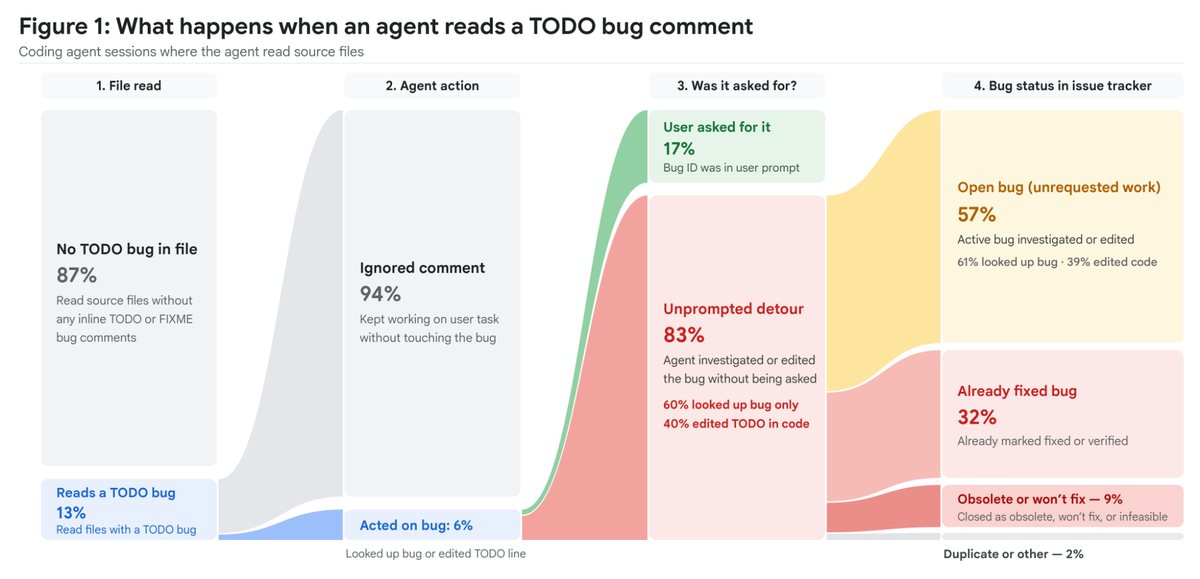
13%の作業が古いメモに出会う
Googleのブログによると、分析の対象は数千人のエンジニアによる、数億ステップ規模のエージェントの作業記録です。ファイルを読む作業のうち13%で、「TODO(bug/...)」や「FIXME(bug/...)」のように不具合番号つきのメモに出会っていました。約7件に1件の割合です。
TODOは、不具合が直ったり放棄されたりした後も残りやすいとGoogleは指摘します。不具合管理の記録が正式な記録になるため、メモと記録を突き合わせれば、無駄な脱線かどうかを自動で判定できるそうです。
エージェントは出会ったメモの94%を無視しました。残る6%では、その不具合番号を対象に追加の動きをしています。
その追加の動きの83%は、開発者が頼んでいないものでした。人が読み流す古いメモを、エージェントは「やるべきこと」と受け取ってしまいます。
脱線の41%は、すでに閉じた不具合
頼まれていない脱線を不具合の状態と照らすと、2つの失敗の型が見えました。
- 41%超は、すでに閉じた不具合を追っていました。修正・確認済みが32%、陳腐化または対応しない決定が9%です。
- 重複や閲覧制限つきの記録に当たったものも2%ありました。
- 半数超は、まだ開いている不具合でした。そこで調べただけが61%、コードを書き換えたものが39%です。
後者は、開発者が触るように頼んでいない問題にまで作業を広げる「スコープクリープ(作業範囲の膨張)」です。
手順70%増、トークン77%増、待ち時間105%増
Googleは、開発者、コードの複雑さ、作業の種類、モデルの段階、読んだファイル数、最初の指示の長さなどの影響を統計的に除きました。その結果、頼まれていない不具合への脱線は、1作業あたり次の負担を足します。いずれもp<0.0001でした。
- 手順(ステップ)は70%増
- トークン(AIが文字を数える単位)は77%増
- 待ち時間は105%増
Googleは、最良の場合でもトークンと時間の浪費で、最悪の場合は誤った前提に基づく修正につながると説明しています。
実例は2つ
1つ目は「古い脱線」です。無関係な不具合を調べていたエージェントが、SurfaceControlTest.javaで不具合番号つきのTODOを見つけました。その不具合は2023年に直っていましたが、エージェントは複数の手順をかけて調べ込みました。
2つ目は「張り切りすぎ」です。調査中の不具合のTODOを見つけたエージェントが、頼まれていないのにコードの「修正」を決めました。コード検索や社内の知識検索を重ね、ModelDownloaderV1のコードを書き換えています。後で人間が範囲の逸脱を指摘し、モデルも誤りを認めました。
Googleは、2件とも軽い脱線だったとしています。それでも時間とトークン、人の介入を要しました。
Googleは掃除用エージェントを作った
対策として、Googleはコード全体を調べるエージェントを作りました。修正済みや陳腐化と記録された不具合番号の参照を探し、削除候補にします。
そこで不具合の履歴、ファイルの履歴、コードの変更を、ときに数年分さかのぼって確かめます。TODOとその意図が古いと確認できた場合にだけ、削除の変更案をレビューに出します。
この掃除用エージェントは、過去6か月で実際に古い参照を数千件削除しました。人間のレビュアーの承認率は95%を超えています。
Googleは、提出前に走る解析ツールやコード全体の走査ツールも、同じ負担を減らす手段になるとしています。後回しにされてきた負債の整理は、エージェントが大規模に動く時代には優先度を見直すべきだ、というのが主張です。
 画像:Google Developers(公式発表)