ホーム / AI・テクノロジー / Google for Developers Google for Developers 2026/09/02
Google、エージェント型動画理解 」を Googleは、Gemini APIを活用して長尺動画を効率的に処理する新手法「エージェント型動画理解(Agentic Video Understanding)」を提案しました。従来の動画全体をモデルに入力する手法では、20分以上の動画で10万トークン以上を消費し、コストと精度の両面で課題がありました。本手法では、モデル自身が自律的に必要な音声やフレームをツール経由で動的に取得することで、トークン消費を大幅に削減しつつ、特定のクエリに対する処理精度を向上させます。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: Agentic approaches to processing long videos with Gemini
3秒でわかる要点 1 動画全体をGeminiに入力する従来手法に対し、参照のみを渡して必要な部分を自律取得する新アプローチを提案2 get_transcriptやget_framesなどの専用ツールをモデルが自律選択し、Think-Act-Observeのループを回す3 20分以上の動画で10万トークンを超える消費を劇的に抑制し、クエリに関連する部分へのフォーカスで精度も向上この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
Google for Developersの技術解説動画において、エージェント(Agentic)アプローチを用いた長尺動画の効率的な処理手法「Agentic Video Understanding(エージェント型動画理解)」が解説されました。解説者はMaarten Grootendorst氏です。
本発表は、特定の単一製品のリリースではなく、GeminiのAPI(Function Calling機能など)を活用した高度なデザインパターン(設計手法)の提案です。すでに一般提供(GA)されているGemini APIの機能を組み合わせることで、今日から開発者が実装可能な実践的なアプローチとして紹介されています。
発表された機能・アップデートの全容
1. 従来手法における「トークン爆発」の課題
動画開始直後(0:00〜)、Grootendorst氏は20分以上の長尺動画をGeminiにそのまま入力する場合の課題を挙げました。動画全体をマルチモーダルモデルに直接流し込むと、1回の処理だけで10万トークン(動画内スライドでは「~121,943 tokens」と具体的な数値を提示)を容易に超えてしまいます。これはAPI利用料金の増大を招くだけでなく、コンテキスト内に不要な情報が大量に含まれることで、モデルの応答精度が低下する原因にもなります。
2. エージェント型動画理解(Agentic Video Understanding)の基本概念
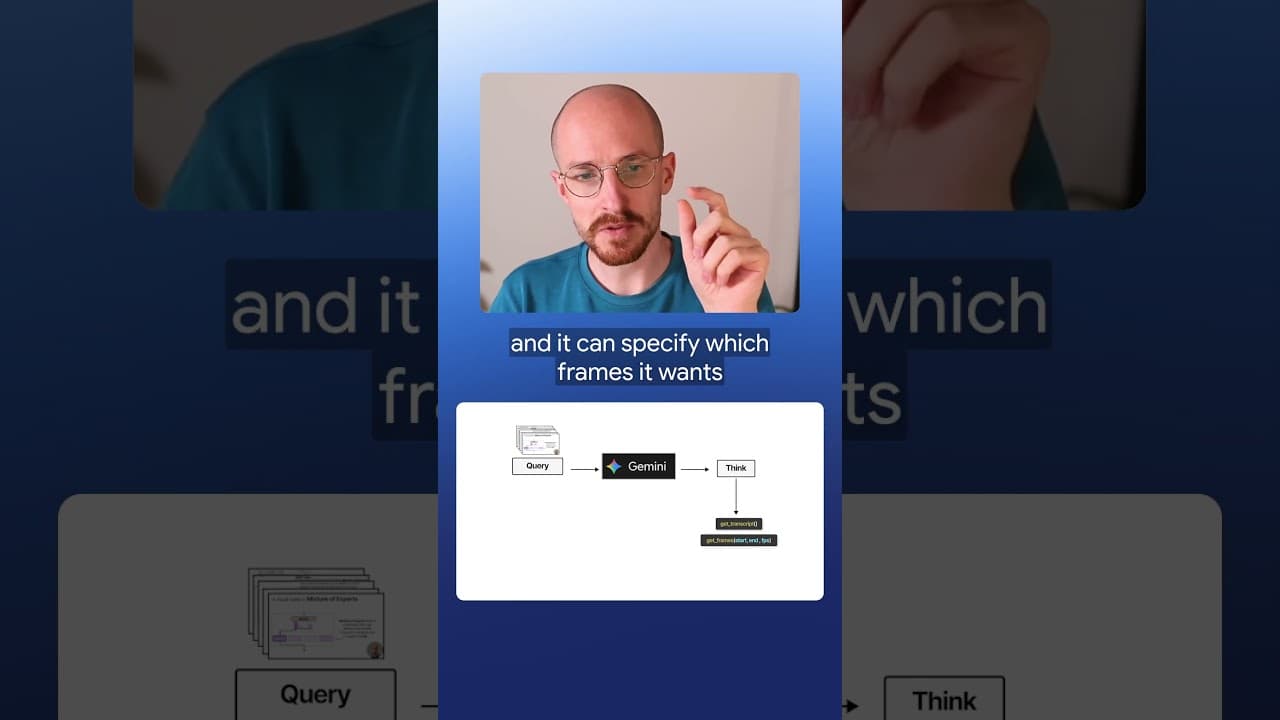
これに対する解決策として提示されたのが「エージェント型動画理解」です(0:16〜)。このアプローチでは、モデルに動画のファイル本体やバイナリデータを直接渡すことはしません。代わりに、動画への参照(例えばYouTubeのURL「https://www.youtube.com/watch?v=sOPDGQjFcuM&t」など)のみをGeminiに与えます。モデルは動画の全体像を把握する前に、まず「どのような情報を取得すべきか」を自律的に判断します。
3. 文字起こしを部分取得する「get_transcript()」ツール
モデルが最初に実行する可能性のあるツールとして、動画の文字起こしを取得する「get_transcript()」関数が紹介されています(0:24〜)。モデルは動画全体を解析する前に、まずこの関数を呼び出してテキストベースのトランスクリプトを取得します。スライドのデモ画面では、タイムスタンプ(0:00, 0:04, 19:03など)付きの文字起こしデータが抽出される様子が示されています。これにより、動画のどの時間帯にどのような内容が話されているかを、極めて少ないトークン数で大まかに把握することが可能になります。
4. 特定シーンをピンポイントで切り出す「get_frames()」ツール
文字起こしから必要な情報のアタリをつけた後、モデルはさらに視覚的な情報を補うために「get_frames(start, end, fps)」関数を呼び出します(0:38〜)。この関数には、開始時間(start)、終了時間(end)、および1秒あたりのフレーム数(fps)を引数として指定できます。動画内のスライドでは、モデルが「frame 1」や「frame 300」といった特定のキーフレームのみを動的に要求し、取得するプロセスが描かれています。動画全体をデコードして入力するのではなく、必要な数フレームだけを狙い撃ちで取得するため、画像入力に伴うトークン消費を最小限に抑えられます。
5. 音声情報を個別に取得する「get_audio()」ツール
視覚情報やテキスト情報だけでなく、音響的な特徴が必要な場合には「get_audio(start, end)」ツールも利用可能です(0:58〜)。例えば、動画内の特定の歓声や効果音、話者の声のトーンなどを分析したい場合、モデルは自律的に音声データのみを切り出して取得します。
6. 自律的な思考と実行のループ(Think-Act-Observe)
これら複数のツールを組み合わせるため、Geminiは「Think(思考)」「Act(行動)」「Observe(観察)」という伝統的なエージェントのループ(Agentic Loop)を実行します(1:00〜)。
Think : ユーザーからのクエリ(質問)に対し、どのツールをどのパラメータで呼び出すべきかを判断する。Act : 選択したツール(例: get_transcriptやget_frames)を実行する。Observe : ツールから返ってきた実行結果(テキストや画像)を観察し、クエリに対する回答が導き出せるか検証する。
このループを繰り返すことで、最終的な回答にたどり着きます。
性能・ベンチマーク
動画内で具体的なベンチマークスコアや、学術的なデータセットを用いた定量的な比較数値は提示されていません。しかし、定性的な性能向上として以下の2点が明確に示されています。
評価項目
従来手法(動画全体を一括入力)
エージェント型アプローチ
出典
トークン消費量
20分の動画で10万トークン以上(例: 121,943 tokens)
必要なトランスクリプトや数フレーム分のみ(劇的に削減)
動画内スライド(0:10 / 0:30)
処理精度(パフォーマンス)
不要な情報がコンテキストに混入し、精度低下の懸念あり
必要な箇所にズームイン(Zoom in)して集中するため向上
登壇者発言(1:11〜)
競合サービスとの比較
(編集部注:本セクションは、発表内容を補完するために、競合であるOpenAIのGPT-4oやAnthropicのClaude 3.5 Sonnetとの比較を記者の知見に基づいて整理したものです。)
動画処理におけるアプローチを競合と比較します。
比較項目
Google Gemini (Agentic)
OpenAI GPT-4o / Assistants API
Anthropic Claude 3.5 Sonnet
動画の直接入力上限 非常に長い(Gemini 1.5 Proは最大200万トークン、約1時間の動画に対応)
数分程度の動画(フレーム抽出して画像として入力)
直接の動画入力は不可(事前に画像や音声を分解する必要あり)
エージェント型アプローチの容易さ 非常に容易(ネイティブなFunction Callingと広いコンテキストを統合可能)
Assistants APIやFunction Callingで実装可能だが、コンテキスト制限に注意が必要
API経由のTool Use(Computer Use等)で実装可能だが、動画処理用のパイプライン自作が必要
強み 長尺動画の全体インデックス(100万〜200万トークン)と、本アプローチによるトークン節約を柔軟に使い分けられる
リアルタイム処理や音声対話の応答速度が速い
テキストおよびコード生成の論理的思考力が極めて高い
弱み エージェントのループによるターン数の増加に伴い、APIの往復レイテンシが発生する可能性がある
長尺動画をそのまま入れるとコンテキスト上限に達しやすい
視覚・音声のマルチモーダルネイティブ処理において一歩譲る
料金・提供プラン
動画内では具体的なAPI料金や提供プランについての言及はありません。
(編集部注:Gemini API(Google AI StudioまたはVertex AI経由)の標準的な料金体系が適用されます。Gemini 1.5 Flashおよび1.5 Proでは、Function Calling自体の追加料金は発生しませんが、モデルがツールを呼び出すための思考プロセス(Think)や、ツールから返されたデータ(トランスクリプトやフレーム画像)を処理する際に入力トークンおよび出力トークンとしての従量課金が発生します。本手法を採用することで、動画全体を入力する場合に比べて入力トークン代を大幅に節約できるため、トータルのランニングコストは劇的に下がると見込まれます。)
日本から使う方法
日本の開発者がこの「エージェント型動画理解」を試すための具体的な手順は以下の通りです。
Google AI Studioへのアクセス : Google AI Studio(aistudio.google.com)に日本国内からアクセスします(Googleアカウントが必要です)。APIキーの取得 : プロジェクトを作成し、Gemini APIキーを発行します。ツールの実装 : PythonやNode.jsなどの開発環境において、動画からトランスクリプトを抽出する関数(YouTube APIやWhisper、Google Cloud Speech-to-Textなどを利用)や、動画ファイルから特定のフレームを切り出す関数(OpenCVやffmpegを利用)をローカル環境またはサーバーサイドに実装します。Function Callingの定義 : Gemini APIを呼び出す際、実装した関数(get_transcript、get_frames、get_audio)のスキーマを tools パラメータとしてモデルに渡します。エージェントループの実行 : モデルが「どのツールを呼び出すべきか」をレスポンス(Function Call)として返してきたら、プログラム側で該当する関数を実行し、その結果(Observation)を再びモデルにフィードバックするループを実装します。
誰にどう効くのか
エンジニア(開発者)へのメリット
動画解析アプリケーションを開発する際、APIコストの壁に突き当たっていた開発者にとって、本手法は極めて実用的なソリューションです。1回のAPIコールで数万〜数十万トークンを消費していた処理を、数千トークン規模に抑えることができます。また、Function Callingを用いた標準的なエージェント構成であるため、既存のLangChainやLlamaIndex、あるいはGemini SDKを用いて比較的容易に実装できます。
企画・マーケティング担当者へのメリット
長時間のセミナー動画、社内研修、あるいは監視カメラの映像アーカイブなどから、特定のシーンや発言を検索・要約するシステムを現実的な運用コストで構築できるようになります。これまでは「動画全体の解析はコストが高すぎて見合わない」と諦めていたアイデアが、実用化可能なビジネスモデルへと転換します。
経営層・意思決定者へのメリット
生成AIを活用したプロダクトのROI(投資対効果)を劇的に改善できます。AIモデルの進化に伴い、コンテキストウィンドウが拡大(Geminiは最大200万トークン)した一方、それを愚直に使い果たすと莫大なコストが発生します。本アプローチのような「賢いエージェント設計」を推奨することで、開発プロジェクトの予算管理とシステムの持続可能性を担保できます。
まとめ
Googleが示した「エージェント型動画理解」は、LLMの長文コンテキスト処理能力に依存しすぎず、エージェント技術を組み合わせて賢くリソースを節約する現実的なアプローチです。開発者は単に動画をモデルに「丸投げ」するのではなく、適切なツール(関数)を定義してモデルに自律的に使わせる設計への移行が求められます。まずは手元の動画データとOpenCV等を用いて、簡易的なフレーム抽出ツールをAPIに連携させるプロトタイプの作成から始めることを推奨します。
動画のタイムテーブル 0:00 長尺動画をGeminiで処理する際のトークン消費の課題提示 0:16 解決策としての「エージェント型動画理解」の概念説明 0:24 get_transcript関数を用いた文字起こしの部分抽出デモ 0:38 get_frames関数による特定フレームの動的取得プロセスの解説 0:43 モデルが自律的にツールを選択・実行する思考プロセスの図解 1:00 思考・行動・観察(Think-Act-Observe)の伝統的なエージェントループの解説 1:10 トークン削減とパフォーマンス向上のメリットのまとめ 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)