公式発表Google for Developers

Google、Gemini Live APIに非同期関数呼び出しやコンテキスト注入などの新機能を追加

Googleは開発者向けイベントにおいて、音声によるリアルタイム双方向対話を可能にする「Gemini Live API」の最新アップデートを発表しました。今回の更新では、処理速度を向上させる非同期関数呼び出しや、必要な場面でのみ発話する「プロアクティブ・オーディオ」、リアルタイムに文脈を挿入する「sendClientContent」などが導入されます。これにより、音声アシスタントの応答性能と実用性が大幅に向上します。

AI解析: gemini-3.5-flash

元動画: 🪄 Gemini Live API in action

3秒でわかる要点

  1. 1非同期関数呼び出しの導入により、音声対話を遮ることなくバックグラウンド処理を実行可能です。
  2. 2プロアクティブ・オーディオ機能により、AIが必要なタイミングでのみ主体的に発話します。
  3. 3高度推論モデルとの統合により、音声対話中に複雑なSVG画像をリアルタイムで生成できます。

何が発表されたのか

Googleは開発者向け公式YouTubeチャンネル「Google for Developers」において、音声によるリアルタイム双方向通信を支える「Gemini Live API」のメジャーアップデートを発表しました。解説を務めるのは、同社のデベロッパーアドボケイトであるトール・シェフ(Thor Schaeff)氏です。

今回の発表は、既存のGemini Live APIに対する機能拡張に位置づけられます。具体的には、音声対話の応答性を極限まで高めるための「非同期関数呼び出し(async function calling)」、AI側から適切なタイミングで話しかける「プロアクティブ・オーディオ(Proactive Audio)」、動的に文脈を流し込む「sendClientContent」のサポート、そして音声対話の裏側で高度な論理思考を実行する「フロンティア・レベルのバックグラウンド推論(frontier-level background reasoning)」の4点が公開されました。本機能群は開発者向けのプレビュー、および一部の環境で一般提供(GA)が開始されています。

発表された機能・アップデートの全容

非同期関数呼び出しによる実行速度の向上

従来のAPIでは、関数呼び出し(Function Calling)を実行する際、モデルはその処理が完了して結果が返ってくるまで、次の発話や処理を一時停止する必要がありました。これに対し、今回導入された非同期関数呼び出し(async function calling)は、APIの実行リクエストをバックグラウンドで処理させながら、ユーザーとの音声対話を継続することを可能にします。デモ画面では、ユーザーが「注文番号1234XYZの状況を調べてください」と発話した直後に、システム側が「状況を確認します」と応答し、裏側でデータベースへの問い合わせ処理が走る様子が示されました。この間、ユーザーとAIの会話は途切れることがなく、システム設計の自由度が大幅に向上します。

必要な時だけ発話するプロアクティブ・オーディオ

プロアクティブ・オーディオ(Proactive Audio)は、音声アシスタントが常に受け身で応答するのではなく、システム側のイベントや処理の進捗状況に応じて、自発的に発話を開始する機能です。デモでは、バックグラウンドでの注文情報の検索処理が完了した瞬間、AIが「お待たせしました。結果の準備ができました」と自ら発話を開始しました。画面上のログには、get_order という関数が呼び出され、ステータスが「shipped(出荷済み)」、配達予定日が「2026年8月11日」であることを示すJSONデータが返ってきたタイミングで、AIが音声出力を生成したプロセスが明確に記録されています。これにより、人間同士の自然な会話に近い、主体性のある音声対話アプリが構築可能になります。

リアルタイムのコンテキスト注入を可能にするsendClientContent

セッションの途中で、外部システムから得られた最新のデータやユーザーの行動履歴などのコンテキストを、対話を中断することなくAPIに注入する仕組みが「sendClientContent」です。このAPIを呼び出すことで、開発者はユーザーが現在見ているウェブ画面の情報や、スマートデバイスのセンサー情報などをリアルタイムにGeminiに送信できます。動画内では、この仕組みを活用して、ユーザーの明示的な音声指示を待つことなく、AIが背後で最新のコンテキスト情報を把握し、より的確な状況判断や提案を行う様子が紹介されました。

ネイティブ音声と高度な推論モデルの融合

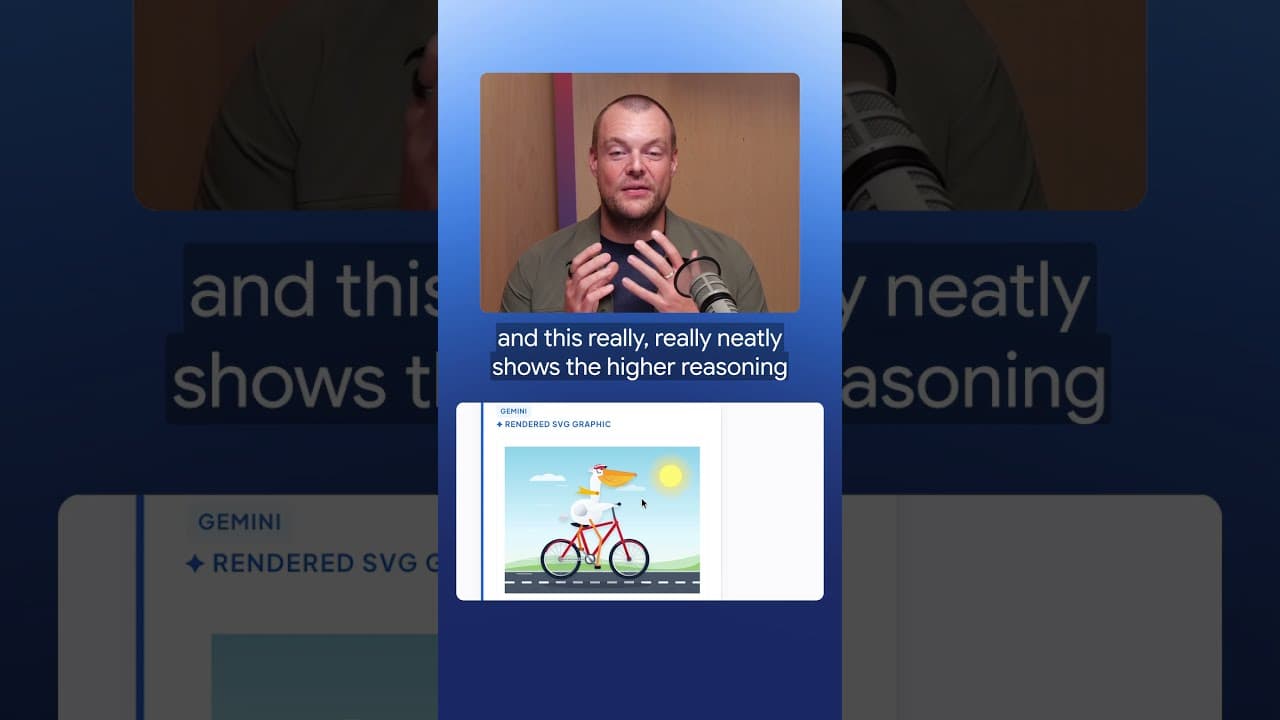
今回のアップデートにおける最大の技術的ブレイクスルーは、音声対話の裏側で「高度な推論モデル(max high reasoning model)」を稼働させ、ネイティブ音声と推論機能を同時に処理できるようになった点です。デモでは、トール・シェフ氏が「自転車に乗るペリカンのSVGを描画してほしい」と指示しました。最初の標準的なモデルが生成したSVGコードは、解釈の余地があるものの、お世辞にも完成度が高いとは言えない簡易的なイラストでした。そこでシェフ氏は、モデルを「max high reasoning model」へと切り替え、再度同じ指示を出しました。モデルは複雑なSVGのコード生成という重い推論処理をバックグラウンドで進めながら、音声では「描画を待つ間、おしゃべりをしましょうか」と提案し、雑談に応じる器用さを見せました。最終的に出力されたSVG画像は、ヘルメットを着用し、赤い自転車に乗り、首にマフラーを巻いた非常に精緻なペリカンのベクターグラフィックであり、推論性能の劇的な向上が視覚的に証明されました。

性能・ベンチマーク

今回の動画内では、具体的な数値によるベンチマークスコアや、他社モデルとの直接的な性能比較グラフの提示はありませんでした。しかし、デモにおいて、複雑なSVGコードの生成(数百行に及ぶXML形式のベクターグラフィック記述)を、音声対話のセッションを維持したまま、わずか十数秒のバックグラウンド処理で完結させた点は、リアルタイム推論における処理効率の高さを示しています。特に、音声認識、思考(推論)、音声合成、画像生成のパイプラインが、単一のネイティブオーディオ対応モデルの枠組みの中でシームレスに統合されていることが確認できます。

評価項目 デモ内での挙動・測定結果 出典(動画内)
関数呼び出しの非同期処理 音声対話を維持したままJSONデータの取得を完了 0:30 付近のデモ画面
SVG画像生成の正確性(標準) 簡易的なペリカンのイラストを出力 0:42 付近のデモ画面
SVG画像生成の正確性(推論モデル) ヘルメット・マフラー・自転車を含む極めて精緻なイラストを出力 1:05 付近のデモ画面

競合サービスとの比較

リアルタイム音声APIの領域における最大の競合は、OpenAI社が提供する「OpenAI Realtime API」です。取材班の見立てでは、今回のGemini Live APIのアップデートにより、Googleは機能面で競合を一歩リードした可能性があります。

機能・特徴 Gemini Live API(Google) OpenAI Realtime API(OpenAI / 編集部調べ)
非同期関数呼び出し 対応。処理中に会話を継続可能 一部制限あり(原則として応答待ちが発生)
能動的発話(Proactive) 対応。システム起点での発話が可能 クライアント側での制御が必要
コンテキスト動的注入 sendClientContent によりリアルタイム注入可能 セッション開始時のプロンプト設定が基本
音声中の高度な推論 推論モデル(High Reasoning)の統合を実演 音声APIと推論専用モデル(o1等)は現状別系統

特に、音声セッションを繋いだまま、バックグラウンドで「推論モデル」を動かしてコード生成などの重いタスクを並行処理するアーキテクチャは、競合にはない独自の強みと言えます。

料金・提供プラン

本動画内では、アップデートされた各種機能の具体的な利用料金や、トークン単価に関する言及はありませんでした。一般的にGoogle CloudのVertex AIやGoogle AI Studioを通じて提供されるGemini APIの料金体系に準拠するものとみられます(編集部注:最新の料金体系については、Google AI StudioまたはGoogle Cloud Vertex AIの公式価格ページを参照してください)。なお、デモで使用された「max high reasoning model」などの高度な推論機能は、通常のモデルと比較してトークン消費量や価格が異なる可能性があります。

日本から使う方法

日本の開発者が本機能を試すための手順は以下の通りです。現在、開発環境の整備が進められています。

  1. Google AI Studioへのアクセス
    • 日本国内からブラウザで「Google AI Studio」にログインします。Googleアカウントがあれば即座に利用可能です。
  2. APIキーの取得
    • プロジェクトを作成し、Gemini Live APIを呼び出すためのAPIキーを発行します。
  3. SDKおよびライブラリのアップデート
    • Python、Node.js、またはWeb用の各種SDKを最新バージョンに更新します。sendClientContent などの新しいメソッドが追加されています。
  4. 日本語での動作検証
    • Gemini Live APIはマルチリンガルに対応しているため、プロンプトおよびシステム指示を日本語で記述することで、日本語のリアルタイム音声対話アプリを開発できます。
  5. 注意点
    • 推論モデル(max high reasoning model)をAPI経由で呼び出す際は、利用可能なリージョンやクォータ制限(Rate Limit)が適用されている場合があるため、開発者コンソールでの確認が必要です。

誰にどう効くのか

エンジニア(開発者)

非同期関数呼び出しと sendClientContent の登場により、ユーザー体験を損なうことなく、バックエンドの基幹システムやデータベースと音声インターフェースを結合できるようになります。音声アシスタントが「処理を待っている間、沈黙する」という不自然な挙動を力技で実装する必要がなくなります。

企画・マーケティング担当者

カスタマーサポート、対話型コマース、音声によるパーソナルコーチングなど、実用的な音声サービスの企画が現実味を帯びます。特に「AI側から適切なタイミングで確認の連絡を入れる」といったプロアクティブなアプローチが可能になるため、ユーザーのエンゲージメントを高める施策を展開できます。

経営層・意思決定者

コールセンターの自動化や、自社製品への音声AIの組み込みにおいて、実用レベルに達したテクノロジーとして投資判断を下す材料になります。音声認識と高度なロジック処理が1つのAPIで完結するため、システム構成をシンプルに保ち、開発運用コストを抑制する効果が期待できます。

まとめ

Googleが発表したGemini Live APIのアップデートは、単に音声の応答速度を競う段階から、「音声で会話しながら、裏で高度な思考やシステム連携を並行処理する」という実用フェーズへの移行を決定づけるものです。開発者の皆様は、まずGoogle AI Studioにアクセスし、非同期関数呼び出しを用いたプロトタイプの作成から着手することをお勧めします。
動画のタイムテーブル

  • 0:00Gemini Live APIの新機能概要の説明
  • 0:16プロアクティブ・オーディオと非同期関数呼び出しの解説
  • 0:22注文ステータス確認APIを利用した非同期処理のデモ
  • 0:36標準モデルによるSVG画像生成のデモと課題提示
  • 0:53最大高度推論モデル(max high reasoning model)への切り替え
  • 1:02画像生成中のフリートークと高度な推論結果の提示
  • 1:18ネイティブ音声と推論機能の統合に関するまとめ

記事で紹介したツール

この機能を、いま自分の環境で試す

記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。

公式サイトで試す

提供: OpenAI

本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.5-flash)