AIエージェント(自分で手順を進めるAI)が、設計の現場の仕事をどこまでこなせるか。それを測る新しい評価が「Physical-Engineering's Last Exam(PLE)」です。ベンチマーク(性能テスト)の一種で、開発者や研究者がAIの実力を比べるために使います。
Google Cloud公式ブログによると、Googleの「AI & Infrastructure」チームがMercorと共同で開発しました。
既存の試験は教科書問題が中心
Googleは、すでに「Humanity's Last Exam」が一般知識を測り、「Agents' Last Exam」がデジタル上の専門業務を測っていると説明しています。PLEは、建物や送電網、半導体など物理的なものを作る仕事の能力を測る位置づけです。
 画像:Google Cloud(公式発表)
発表では、最先端の言語モデルが多くの学術的な評価で90%を超えると述べています。ただ、それらは教科書的な問題や単発のツール呼び出し、小さな設計問題が中心だといいます。有資格の技術者による確認のもとで、安全で、法規に合い、費用面でも妥当な設計を出せるかは、既存の評価では分からないという立場です。
85課題、1課題に平均61ファイル
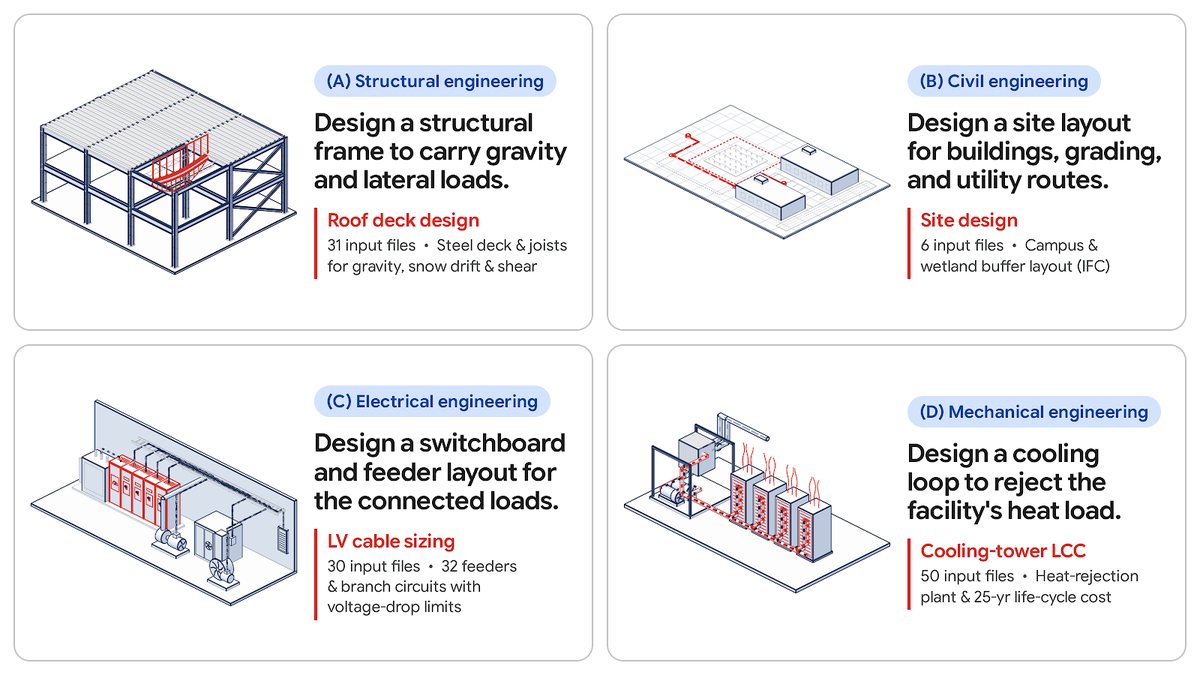
PLEには、長い手順を要する課題が85件あります。内訳は次のとおりです。
- 機械工学:30件
- 電気工学:27件
- 土木工学:18件
- 構造工学:10件
AIは1つの質問に答えるのではなく、コンテナ(独立した実行環境)化されたプロジェクトフォルダの中で作業します。環境はMercorの「Archipelago」を基に作られています。
1課題あたり平均61ファイルで、全体では5,170ファイルです。PDF、表計算、メール、2D CAD図面、3D BIMモデル、文書の改訂版などが含まれます。AIは、これらを読み解いて適用される建築基準や物理的な限界を見つけ、計算し、有資格の審査者が確認する水準の成果物を作ります。
課題の作り方は2通りです。
- 専門家が作成:44件。現役の技術者が、実際の業務に基づいてフォルダ、指示文、採点基準を作成
- 共同作成:41件。技術者が最初の課題を設計し、エージェントのパイプラインが、ライセンス可能な技術標準から環境と採点ツールを組み立て。技術者がすべてを検証し、難しくした
最高スコアは48.3%、安全関門を通ったのは41.3%
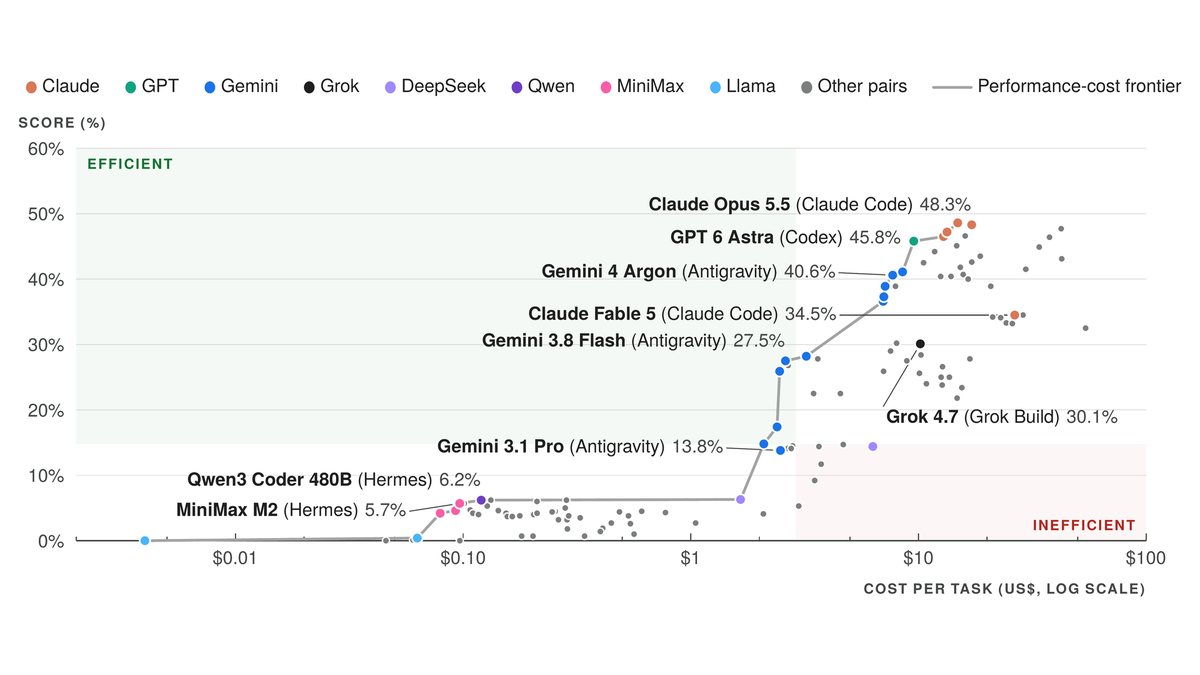
Googleは14の主要モデルを、公開されている7つのエージェント実行基盤(ハーネス)で試しました。対象は、Antigravity、Claude Code、Codex、Hermes、OpenCode、OpenHands、Piです。
PLEは法規への適合とコスト効率の両方を見ます。そのため、まず安全に関わる必須の検査をすべて通った設計だけが得点を得られます。
結果は次のとおりです。
- 非公開のテスト用課題で、全モデルが50%未満。最高は、モデル本来のハーネスで平均48.3%
- 最高構成は、共同作成課題の個々の制約の91%を満たした
- ただし、安全性と実現性の必須検査をすべて通した成果物は41.3%にとどまった
つまり、個々の条件はおおむね満たせても、1つでも安全条件を落とせば設計としては使えません。この差が現状の課題です。
差を生むのはモデルで、ハーネスは実行コストに響く
モデルの選択がハーネスの選択よりも成績を大きく左右することも分かりました。モデル間の差は最大50ポイントでした。同じモデルでハーネスだけを変えた場合の差は、中央値で3ポイントです。ただし、ハーネスは実行コストには大きく影響するとしています。
課題の入手と参加方法
Googleは29件の公開課題と採点ツールを公開し、公開の順位表はple-bench.comで公開しています。参加の手順は次のとおりです。
- 技術的な詳細は、arXivの論文で確認する
- 29件の公開課題、採点スクリプト、評価用コンテナをGitHubのリポジトリから入手する
- 自前のエージェント構成を、ple-bench.comで非公開のテスト用課題にかけて評価を受ける
評価では、Google提供の13モデルがGoogleのサーバーで無料で動かせます。賞品の詳細は後日発表されます。
サイソクが報じた別の話題では、GoogleがAI学習ノート「Gemini Notebook」に無料教科書を追加しました(GoogleがAI学習ノート「Gemini Notebook」に無料教科書を数百冊追加)。AIを学習や専門業務に使う動きは、広がっています。
今回の数字は、全モデルが5割未満で、設計成果物には有資格者の確認が欠かせない段階にあることを示しています。
 画像:Google Cloud(公式発表)