特徴量ごとに独立してリリースでき、同等の抽出用特徴量は従来のF3より約3.6倍速く本番に届くといいます。インフラの計算コストは増えていません。
F3(Facebook Feature Framework)は、AIモデルに渡す材料を作って配信する基盤です。この材料を特徴量と呼びます。たとえば「過去7日間のクリック数」です。Engineering at Metaの公式ブログによると、広告1件のリクエストで2万以上の特徴量が必要になることがあります。F3は2020年の「AI @ Scale」で初めて紹介されました。
共有計算でコストを抑えた代わりに、リリースが全部まとめになった
機械学習の本番システムは、生データをそのままモデルに渡しません。保存された信号を読み、期間で絞り、数えて、正規化し、中間結果を組み合わせます。特徴量を1つずつ独立した関数にすると、わかりやすい反面、無駄が出ます。7日間のクリック数と7日間のインプレッション数は、同じイベントデータを読み、同じ期間の絞り込みをするからです。クリック率の特徴量は、その両方の結果をさらに使います。
 画像:Engineering at Meta(公式発表)
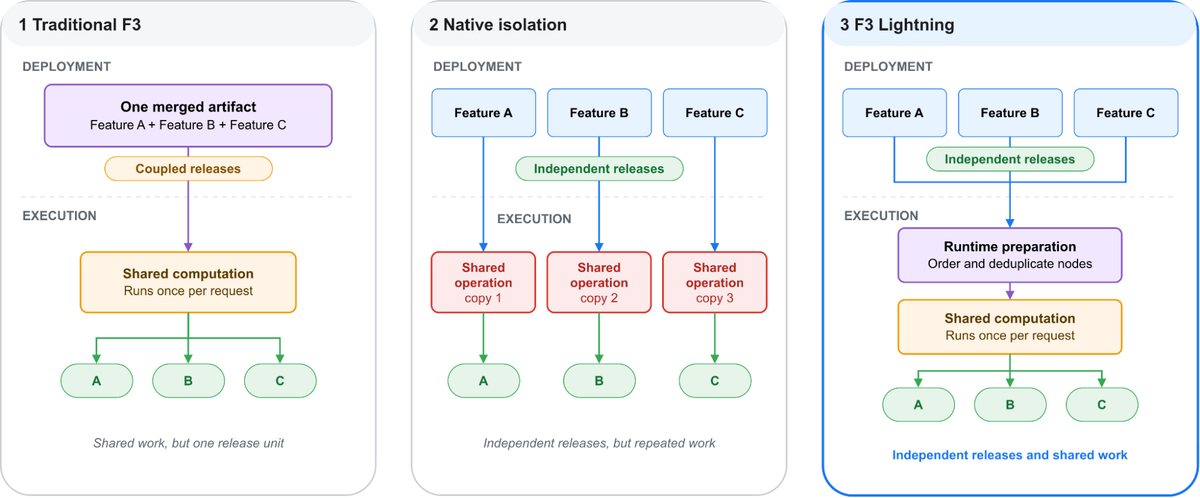
そこでF3は、特徴量の抽出を有向非巡回グラフ(DAG、処理の依存関係を矢印で結んだ図)で表しました。各ノードが読み込み、絞り込み、集計といった1つの作業を担当します。エンジニアは特徴量を1つずつ高水準言語で書き、コンパイラが小さなグラフに変換します。サービスが使う全特徴量のグラフを1つに統合し、重複する作業は1つのノードにまとめます。共通の作業はリクエストごとに1回だけ実行されます。
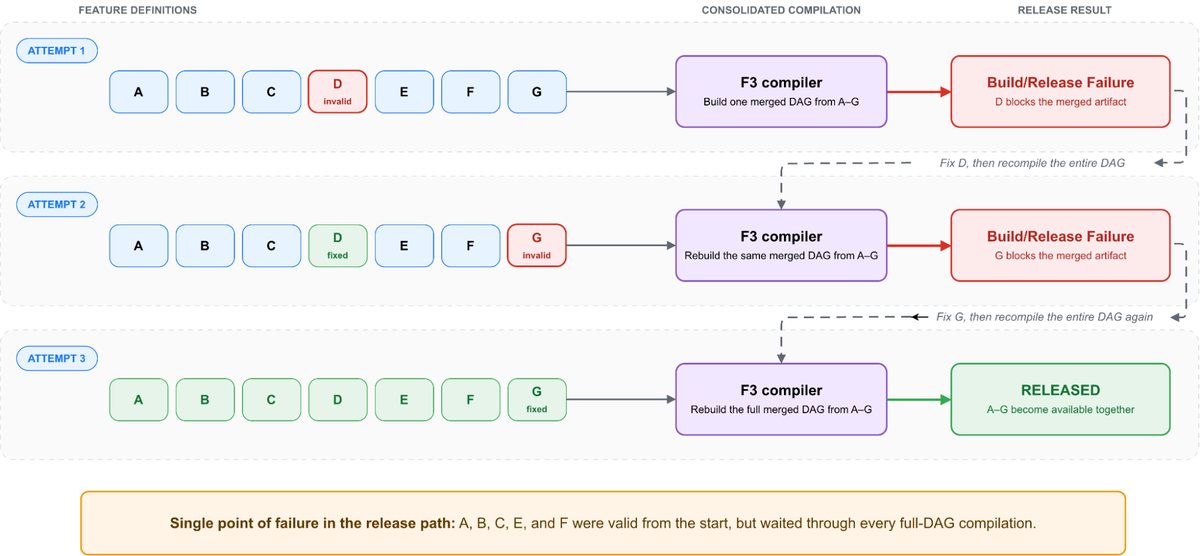
ただし、この統合グラフがそのままリリース単位になっていました。ブログは、定義が1つでも不正だと、ほかの特徴量の反映も止まると説明しています。図の例では、特徴量AからGのうち、DとGにそれぞれ別のエラーがあります。1回目はDで失敗し、7つとも出ません。Dを直した2回目はGで失敗し、3回目でようやく全部が本番に届きます。
数百から2万超へ、検証も重くなった
当初のF3が扱った特徴量は数百で、統合は成功しやすく、リリースも概ね順調でした。現在は2万を超えています。計算方法によって必要な検査が違うため、新規の特徴量と変更した特徴量では、テストの基準が異なります。すでにモデルが使っている特徴量には、モデル関連のテストが必要です。このテストは計算負荷が高く、後ろのリリース段階でしか実行できません。統合グラフは1つの単位で出るため、ほかの特徴量もその待ち時間を共有していました。
MetaはF3の公開後、統合グラフに何度も改善を加えました。そのたびにリリース速度は一時的に戻りましたが、特徴量が増えると効果は薄れました。全特徴量が一緒に出る構造は変わらなかったためです。
特徴量ごとの設定にして、リリースの順番待ちをなくす
F3 Lightningは、リリースの境界と実行の境界を分けます。コンパイラは各特徴量を単独で1つの設定にコンパイルします。その設定には、特徴量の抽出に必要なノードが順番に入っており、隣の特徴量から借りるものはありません。特徴量Cに問題があっても、Aは出せます。
リリースの経路は、一括で出すか全部止めるかのバッチではなく、順番待ちの列になります。変更は、何を前に進めるかで優先度が決まります。まだどのモデルも使っていない新しい特徴量は、標準の検証で素早く出せます。稼働中のモデルが読む特徴量の変更は、先に追加のテストを受けます。
同じ計算を使い回すために、4つの最適化を入れた
最初の試作は、デプロイだけを分けました。特徴量は独立して出せましたが、実行の共有がなくなり、従来のF3よりCPUを大きく使いました。設定ごとに別のグラフとして実行され、統合グラフが省いていた読み込み、絞り込み、集計が繰り返されたためです。
解決策は、統合グラフを作り直さずに共有実行を取り戻すことでした。F3 Lightningは起動時に、稼働中の特徴量の設定を集め、共通の作業をまとめて1つの実行順に並べます。手順は次の4つです。
- 安定した識別子:ノード番号は特徴量ごとの局所的な番号で、同じ計算か判定できません。そこで、操作の種類、パラメーター、入力の識別子から識別子を導きます。同じ入力に同じ操作をする2つの特徴量は、数週間離れてコンパイルされても同じ識別子になります。計算の意味が変われば識別子も変わります。
- 単一の実行計画:起動時に全特徴量を通した1つの計画をトポロジカルソートで作ります。同じ識別子のノードは1つにまとめ、計算は1回だけ実行されます。計画は順序つきのリストに平坦化され、リクエストごとに前から1回通すだけで済みます。
- 共有メモリバッファ:重複をなくしても、CPU使用量は従来より高いままでした。設定ごとの作業用の入れ物が別々のメモリにあり、行き来するたびにキャッシュミスが起きていたためです。リクエストごとに1つのバッファへ置き換え、隣り合う手順が隣り合うメモリを触るようにしました。
- 連番スロット:識別子の検索はハッシュ計算とポインタ追跡が必要で、大量のリクエストでは重くなります。起動時に識別子へ連番を割り当て、全設定の参照を書き換えるため、識別子は初期化時にしか使いません。
共有バッファには、準備できているかを示す1本のベクトルも置かれます。空のリストも有効な結果なので、「空」と「未計算」を区別するためです。リストやマップは参照だけを共有し、20個の特徴量が使う計算も1回の計算と1回の保存で済みます。単一の値は、コピーのほうが安いのでコピーします。
共有しても障害が全体に広がらないようにもしています。ある計算が失敗するか入力が使えないと、その下流だけが「未準備」になり、実行がスキップされます。独立した枝は動き続けます。
Metaは結果として、同等の抽出用特徴量が従来のF3より約3.6倍速く本番に届き、インフラの計算コストは増えていないとしています。リリース周期が短くなるため、同じ期間にモデルの改善を重ねる回数も増えると説明しています。過去には、Metaがバグの事前検出を紹介した例もあります(Meta、AIでバグを事前検出する「JiTTests」の成果を公開)。
 画像:Engineering at Meta(公式発表)