ホーム / AI・テクノロジー / NVIDIA NVIDIA 2026/10/03
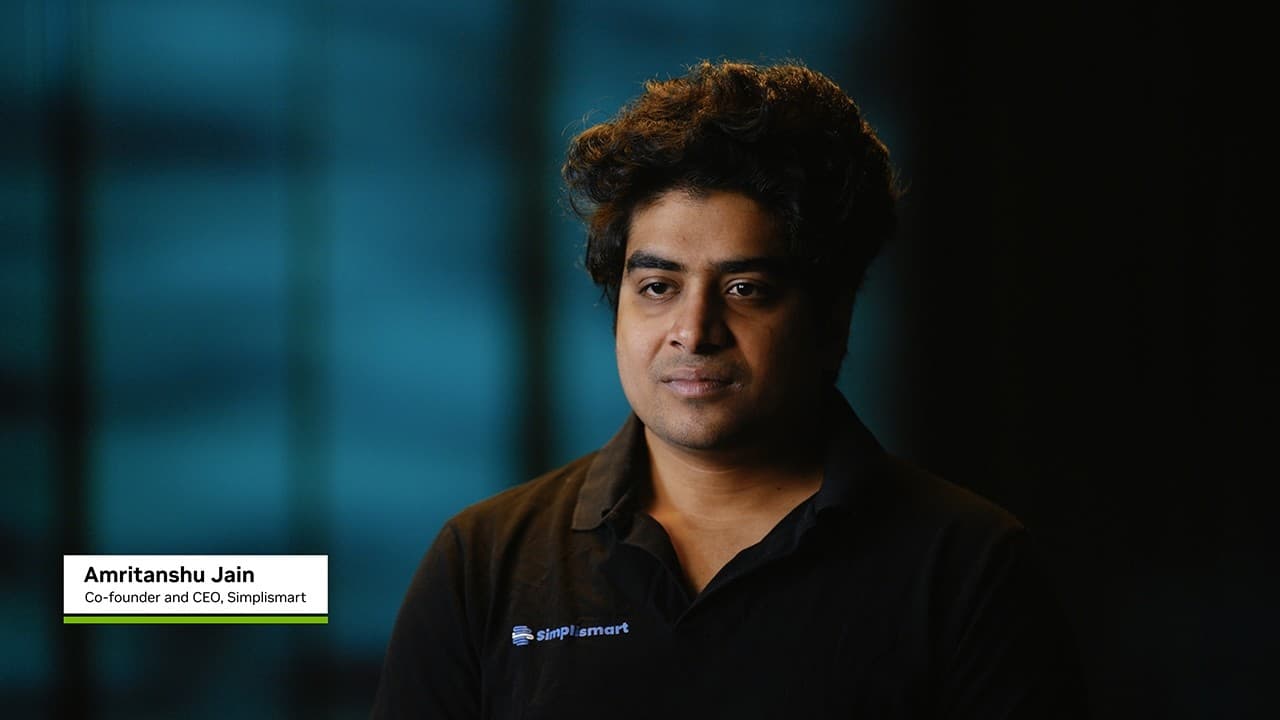
Simplismart、 インドのAIスタートアップ企業Simplismartは、NVIDIAの最新GPU群と推論最適化ソフトウェア群を統合した、エンタープライズ向けのノーコードAIデプロイプラットフォームを公開しました。本プラットフォームは、インフラ管理の手間を排除し、オープンソースのLLMやVLMを数クリックで最適化して本番環境へ展開できます。NVIDIA Inceptionプログラムの支援を受け、HopperやBlackwellなどの最新アーキテクチャに最適化された推論環境を即座に構築可能です。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: Accelerating No-Code Enterprise AI: Inside Simplismart’s NVIDIA Inception Journey
3秒でわかる要点 1 Simplismartは、NVIDIAの技術を統合したノーコードAIデプロイプラットフォームを提供します。2 T4から最新のB200まで対応し、GPU時間あたり1.20ドルからの柔軟な専用デプロイが可能です。3 コスト、レイテンシ、スループットのトレードオフを視覚的に調整し、最適な推論エンジンを自動生成します。この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
Simplismartが提供するノーコードAIプラットフォームの最新機能と、NVIDIAとの協業成果が発表されました。これは研究段階のものではなく、すでにエンタープライズ向けに提供が開始されている商用ソリューションです。
これまで、自社専用のカスタムAIモデルを本番環境にデプロイするには、インフラのプロビジョニングから推論エンジンの最適化、コンテナ化、スケーリングの設定など、多くのMLOps(機械学習オペレーション)プロセスが必要でした。Simplismartの共同創業者兼CEOであるAmritanshu Jain氏は、動画内で「モデルを本番環境へ展開するのに6カ月から9カ月も要するべきではない」と指摘しています。
本発表では、NVIDIA NIM(NVIDIA Inference Microservices)やTensorRT-LLM、Triton Inference ServerといったNVIDIAの最先端推論スタックを内包することで、ユーザーがコードを1行も書くことなく、数分で最適な推論エンドポイントを構築できる環境が整ったことが示されました。
発表された機能・アップデートの全容
1. 多様なモデルのワンクリック選択と自動デプロイ
Simplismartのプラットフォーム上では、多種多様なオープンソースモデルがカタログ化されています。動画内のデモ画面では、Googleの「Gemma 2 27B Instruct」や「Gemma 2 9B」、Metaの「Llama 3.1 8B Instruct」「Llama 3.3 70B Instruct」、Qwenの「Qwen 2.5 72B Instruct」「Qwen 2-VL 72B Instruct」、さらに音声認識モデルの「Whisper Large V3」などが一覧で表示されています。ユーザーは、Hugging Faceなどのモデルソースから任意のモデルを指定し、バックエンドエンジン(vLLMなど)を選択するだけで、デプロイプロセスを開始できます。
2. NVIDIAの最新GPUファミリに対応した専用デプロイ環境
デプロイ時に使用するハードウェアとして、NVIDIAの幅広いGPUラインアップが統合されています。デモ画面では、以下のハードウェアオプションと時間あたりのコストが明示されています。
NVIDIA T4 GPU(1.20ドル/時)
NVIDIA L4 GPU(1.50ドル/時)
NVIDIA A10G GPU(2.00ドル/時)
NVIDIA A100 GPU(3.00ドル/時)
NVIDIA H100 GPU(4.00ドル/時)
NVIDIA H200 GPU(5.20ドル/時)
NVIDIA B200 GPU(要問い合わせ)
ユーザーは、必要なGPUの枚数(1、2、4、8枚など)とインスタンス数をGUI上で直感的に選択できます。これにより、小規模な検証から大規模なプロダクション環境まで、同一のインターフェースで対応可能です。
3. 多次元トレードオフに基づく「パーソナライズ推論エンジン」の自動生成
Simplismartの最大の特徴は、コスト、スループット、レイテンシ、品質の4つの指標を可視化したレーダーチャートを用いて、推論エンジンを最適化できる点です。動画では、適用する最適化技術(Paged Attention、Eagle、Vanilla、Shadow KV、MTPなど)とGPU(L4、H100など)の組み合わせによって、レーダーチャートの形状がリアルタイムに変化する様子が示されています。これにより、開発者は専門的な知識がなくても、自社の予算やサービスレベル合意(SLA)に合致した「パーソナライズ推論エンジン」を自動生成できます。
4. ユースケースに特化したSLAの調整機能
Jain氏は、具体的なユースケースを挙げて最適化の必要性を説明しています。例えば、銀行が債権回収のために音声対話エージェントを構築する場合、エンドツーエンドのレイテンシを300ミリ秒以下、TTFT(Time to First Token:最初のトークンが出力されるまでの時間)を140ミリ秒以下に抑える必要があります。一方で、大量の社内文書を解析するドキュメントパーシングの用途では、レイテンシよりもスループットの最大化(1秒あたりの処理トークン数や画像数)が最優先されます。Simplismartは、これらの異なる要求に対して、ハードウェアとソフトウェアの組み合わせを自動で最適化します。
5. NVIDIA NIMおよびNCPとの緊密な統合
Simplismartは、NVIDIA NIM(NVIDIA Inference Microservices)の初期のコントリビューターであり、モデルデプロイ用のコンテナの標準化を進めてきました。また、NVIDIA Cloud Partner(NCP)との提携により、各地域のデータセンター上にSimplismartのAIオーケストレーションレイヤーをデプロイし、独自の「AIクラウド」としてエンドユーザーに提供する仕組みを構築しています。これにより、オンプレミス環境や特定のプライベートクラウド上でも、セキュアに高性能な推論環境を稼働させることができます。
性能・ベンチマーク
動画内で示された性能指標や特定のユースケースにおける目標値は以下の通りです。
項目
設定値 / 目標値
出典
音声エージェント目標レイテンシ
300ミリ秒以下
動画内発言(0:49)
音声エージェント目標TTFT
140ミリ秒以下
デモ画面(0:48)
音声エージェント目標コスト
100万トークンあたり1ドル未満
デモ画面(0:48)
サポートするGPUオプション
T4, L4, A10G, A100, H100, H200, B200
デモ画面(0:27)
最小GPU利用コスト
1.20ドル / 時間(NVIDIA T4)
デモ画面(0:27)
(編集部注:具体的なスループットの測定値は、選択するモデルや量子化の精度(FP16など)によって変動するため、デモ画面では「Throughput: 1200 Tokens/Sec」や「Throughput: 1 Images/Sec」といった例示に留まっています。実運用時には、選択したパラメータに応じてリアルタイムに予測値が算出されます。)
競合サービスとの比較
(編集部注:本比較表は、動画内で提示されたSimplismartの機能と、一般的な競合サービス(大手パブリッククラウドのMLプラットフォームや個別API提供企業)の公表情報を基に作成しています。)
評価軸
Simplismart
競合A(パブリッククラウドのMLプラットフォーム)
競合B(大手AI企業のAPIサービス)
開発スタイル 完全ノーコード(GUIによる操作)
ローコード / プログラミング(Python SDK等)
API統合(プログラミング必須)
モデルの選択肢 主要オープンソースモデル(Llama, Gemma, Qwen等)
オープンソースおよび独自モデル
独自モデルに限定
最適化の柔軟性 コスト、レイテンシ、スループットの自動トレードオフ調整
手動でのハイパーパラメータ調整やコンテナチューニング
チューニング不可(ホスト型)
インフラ制御 不要(Simplismartが裏側で自動管理)
仮想マシンやKubernetesの管理が必要な場合が多い
不要(完全に隠蔽)
デプロイ場所 クラウド、NCP、オンプレミス(BYOC対応)
自社クラウド内に限定
サービス提供元のサーバーに限定
優位性分析 :
Simplismartは、パブリッククラウドの自由度と、APIサービスの簡便性の双方を両立しています。特に、NVIDIAの最新ハードウェア(H200やB200)に最適化したカスタムカーネルを自社で記述し、プラットフォームに組み込んでいるため、ユーザーは専門知識なしで極限まで推論コストを削減できます。
弱み・課題 :
独自のプロプライエタリモデル(OpenAIのGPT-4oなど)を直接ホストすることはできません。オープンソースモデルの性能向上に伴いこの差は縮まっていますが、特定の独自モデルに依存するシステムからの移行には、モデルの再選定が必要です。
料金・提供プラン
動画内で公開された「Dedicated Deployments(専用デプロイメント)」の料金体系は以下の通りです。
NVIDIA T4 GPU : 1.20ドル / GPU時間NVIDIA L4 GPU : 1.50ドル / GPU時間NVIDIA A10G GPU : 2.00ドル / GPU時間NVIDIA A100 GPU : 3.00ドル / GPU時間NVIDIA H100 GPU : 4.00ドル / GPU時間NVIDIA H200 GPU : 5.20ドル / GPU時間NVIDIA B200 GPU : 要問い合わせ(Contact Us)
(編集部注:上記の料金は、GPU1枚あたりの時間課金です。デプロイ時にインスタンス数(1、2、4、8など)を選択することで、合計料金が算出されます。また、Bring Your Own Cloud(BYOC)やオンプレミス環境での導入については、個別見積もりでの対応となっています。)
日本から使う方法
日本のユーザーがSimplismartを導入、または試用するための手順は以下の通りです。
公式サイトへのアクセスとアカウント作成
Simplismartの公式ウェブサイト(https://simplismart.ai/)にアクセスし、サインアップを行います。企業メールアドレスでの登録が推奨されます。 モデルの選択とパラメータ設定
ダッシュボードの「Models」メニューから、利用したいLLMやVLM(Llama 3.1やGemma 2など)を選択します。推論エンジンの最適化
「Latency」「Throughput」「Cost」の優先度に応じて、スライダーやレーダーチャートを用いて推論設定を調整します。ハードウェアの選択とデプロイ
デプロイ先のGPU(T4からH200など)とインスタンス数を選択し、「Deploy」ボタンをクリックします。APIの統合
デプロイ完了後に発行されるAPIエンドポイントとAPIキーを取得し、自社のアプリケーション(PythonやJavaScriptなど)に組み込みます。
注意点 :
現時点でUIは英語のみの提供となっています。また、選択するGPUのリージョンによっては、日本からのアクセスにおいて物理的なネットワークレイテンシが発生する場合があります。極めて低いレイテンシが求められる音声対話などの用途では、アジア地域のNCP(NVIDIA Cloud Partner)のインスタンスを選択するか、BYOC(自社クラウドへのデプロイ)オプションの利用を検討してください。
誰にどう効くのか
エンジニアへのメリット
インフラのプロビジョニング、CUDAカーネルの最適化、Kubernetesクラスターの管理といった、煩雑なMLOps業務から解放されます。NVIDIA NIMやTensorRT-LLMの複雑な設定を意識することなく、常に最新の最適化技術が適用されたエンドポイントを利用できるため、アプリケーション開発の本質的なロジックに集中できます。
企画・マーケティング担当者へのメリット
新しい生成AI機能を搭載したプロダクトのプロトタイプ作成から、市場へのテストリリースまでの期間を劇的に短縮できます。従来はインフラ構築に数週間から数ヶ月を要していたプロセスが数分で完了するため、市場のフィードバックを得ながら迅速にサービスを改善する「アジャイル開発」が可能になります。
経営層へのメリット
AIの運用コスト(推論コスト)を完全にコントロールできます。プラットフォーム上で「コスト重視」「パフォーマンス重視」のシミュレーションが視覚的に行えるため、事業のROI(投資対効果)に合わせた最適なインフラ投資が可能です。また、NVIDIAの最新GPUを効率的に活用することで、無駄なクラウド支出を削減できます。
まとめ
Simplismartは、NVIDIAの強力なハードウェアとソフトウェアスタックをノーコードという使いやすいインターフェースに収めることで、エンタープライズAIの民主化を推し進めています。開発期間の短縮とコスト最適化を同時に実現したい企業にとって、有力な選択肢となるでしょう。まずは公式サイトでアカウントを作成し、Gemma 2やLlama 3.1などの軽量モデルを用いて、推論速度とコストのシミュレーションを実行してみることをお勧めします。
動画のタイムテーブル 0:00 Simplismartの創業背景とノーコードプラットフォームのミッションを解説 0:18 プラットフォーム上で選択可能な主要LLM/VLMおよび音声モデルの一覧を提示 0:27 NVIDIAの各GPU(T4からB200まで)の選択画面と時間あたりの料金体系を紹介 0:33 Paged AttentionやEagleなどの最適化技術によるトレードオフ調整デモ 0:39 銀行の音声エージェントや文書解析など、具体的なユースケースにおけるSLA設計 1:01 Simplismartの推論最適化アーキテクチャとNVIDIAによる技術支援について説明 1:30 NVIDIA NIMの早期採用と、NVIDIA Cloud Partner(NCP)との連携によるAIクラウド展開 1:57 NVIDIA Inceptionプログラムを通じた3年間のスタートアップ支援実績を総括 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)