ホーム / AI・テクノロジー / OpenAI OpenAI 2026/09/12
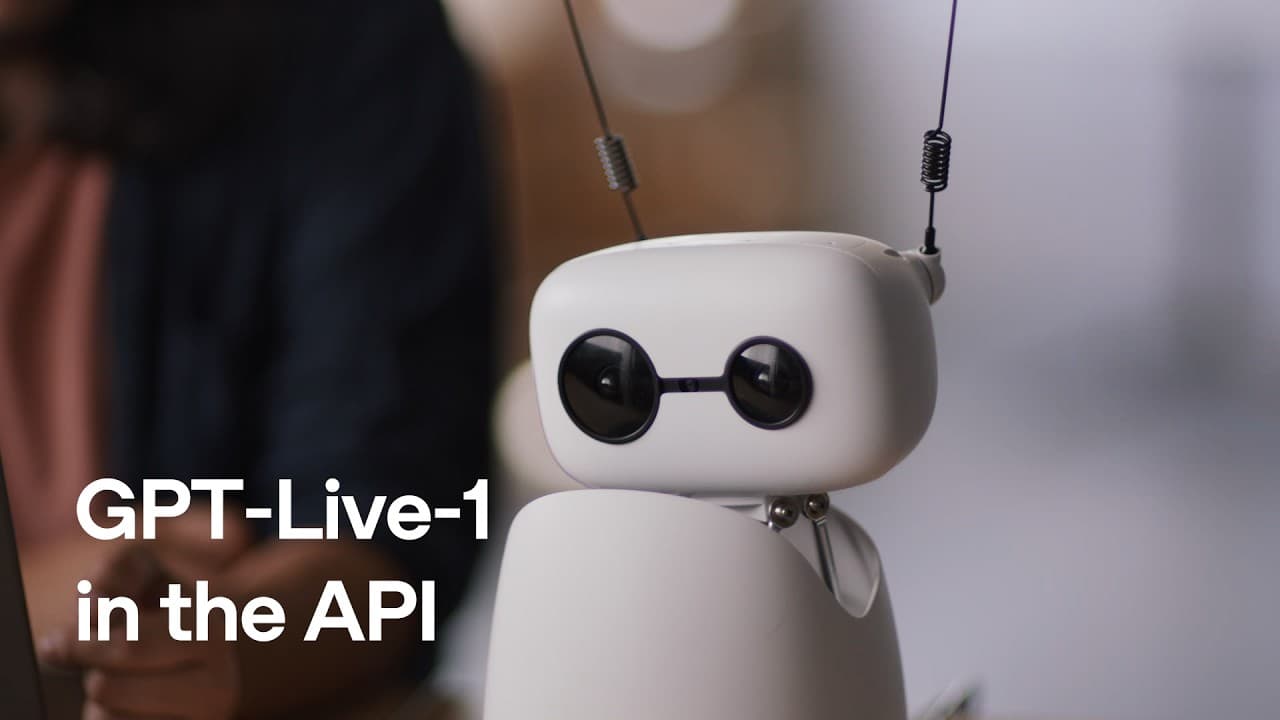
米OpenAI、GPT-Live-1 」を 米OpenAIは2026年9月11日(現地時間)、音声対話に特化した新しいAPI「GPT-Live-1」の一般提供を開始しました。本モデルは、従来の音声対話システムとは異なり、音声フロントエンドとバックエンドの推論モデルを分離して協調動作させる新しいアーキテクチャを採用しています。これにより、会話の遅延を最小限に抑えつつ、高度な推論や外部ツールの実行を同時に実現します。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
まとめ この話題の全体像はこちら GPT-6 Astraの全貌:36本の公式発表から紐解く自律型AIエージェントの決定版まとめ 元動画: GPT-Live-1 is now in the API
3秒でわかる要点 1 音声専用フロントエンド「GPT-Live-1」とバックエンド推論モデルを分離協調させる新構成を採用2 会話を遮る「割り込み」や、背後の激しい騒音に対しても、会話の流れを止めずに処理を継続可能3 フロントエンドの利用料金は1分あたり5セントに設定され、バックエンドの推論処理は別料金で提供この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
米OpenAIは2026年9月11日(現地時間)、公式YouTubeチャンネルにおいて、音声対話に特化した新しいAPI「GPT-Live-1」の提供開始を発表しました。本機能は、開発者が自身のアプリケーションに「ChatGPT」のような自然な双方向音声会話を組み込めるようにするものです。研究段階の技術デモではなく、本日よりAPIを通じて開発者が利用可能な状態(一般提供)となっています。
今回の発表における最大の新事実は、音声処理を行うフロントエンドモデル「GPT-Live-1」と、推論やツール実行を担うバックエンドモデルが完全に分離され、並行して協調動作するアーキテクチャが採用された点です。動画内の開発者向け画面(Workbench)には、バックエンドモデルとして「GPT-5.6 Luna」という未発表のモデル名が明記されており、OpenAIの次世代モデルファミリーが実用段階に達していることを示唆しています。
発表された機能・アップデートの全容
双方向同時会話(フルデュプレックス)と割り込みへの柔軟な対応
GPT-Live-1は、人間同士の会話と同様に、聞き取りと発話を同時に行う「フルデュプレックス(全二重通信)」に対応しています。従来の音声対話システムでは、ユーザーが話し始める前にAIの発話が完全に終了するのを待つ必要がありました。しかし、本モデルではAIが話している最中にユーザーが言葉を挟む(割り込む)と、AIは即座にそれを検知して発話を停止し、ユーザーの新しい指示に耳を傾けます。動画内のデモでは、プレゼンターが「割り込みについて心配する必要はないということですか」と問いかけた際、ロボットはスムーズに自身の発話を中断し、次の応答へ移行する様子が実演されました。
バックエンドモデル「GPT-5.6 Luna」との連携によるツール実行
本APIの最も特徴的な構造は、音声対話の「流れ」を維持するフロントエンドと、論理的思考や外部ツール呼び出しを行うバックエンドを分離した点にあります。動画の13秒付近に表示された「Workbench」のUI画面によると、システムは以下の3つのレイヤーで構成されています。
You(Microphone) : ユーザーの音声入力GPT-Live-1(Voice frontend) : 音声の認識と即時応答を担うフロントエンドBackend(GPT-5.6 Luna) : 思考、推論、ツール実行を担うバックエンド
ユーザーが話しかけると、フロントエンドのGPT-Live-1が極めて低いレイテンシーで応答を返します。それと並行して、バックエンドの「GPT-5.6 Luna」が処理を行い、外部機器の制御や画面表示の書き換えといったアクションを実行します。これにより、AIが「考え中」であっても、音声の会話自体は途切れずに自然なテンポを維持できます。
騒音環境下での高い音声認識性能
動画の24秒からのデモでは、音声認識の堅牢性が示されました。プレゼンターの背後で別のスタッフが意図的に激しい騒音(椅子を床に叩きつけるような音や、金属音)を発生させます。一般的な音声認識システムであれば、ノイズによってユーザーの声がかき消されるか、誤認識を起こす場面です。しかし、GPT-Live-1は「周囲でノイズが発生していても、あなたの声を追跡できます」と述べ、騒音の中でもプレゼンターの発言内容を正確に聞き取り、対話を継続しました。この性能は、騒がしいオフィスや屋外、家庭内などの実環境における実用性を大きく向上させます。
ロボティクスや外部ディスプレイとの物理連携
デモでは、APIが物理的なハードウェアをリアルタイムに制御する様子が描かれました。卓上に置かれた2つのアンテナを持つ小型ロボットは、会話の文脈に合わせて目を動かしたり、首を傾げたり、手を振る動作(ジェスチャー)を行います。さらに、隣に設置されたLEDディスプレイは、バックエンドモデルからの命令(set_display_scene)を受けて、表示内容を「GPT LIVE 1」というテキストから、グラフィック、そして料金表示へとリアルタイムに切り替えました。これは、音声対話APIが単なる音声の入出力にとどまらず、物理的なエージェントの制御インターフェースとして機能することを示しています。
性能・ベンチマーク
動画内において、他社モデルや従来モデルとの比較を示す具体的なベンチマーク数値(ベンチマークスコアや応答速度のミリ秒単位のデータなど)の提示はありませんでした。ただし、Workbenchのタイムライン表示から、ユーザーの発話終了とほぼ同時にフロントエンドモデルが応答を開始している様子が視覚的に示されており、極めて低いレイテンシーが実現されていることが確認できます。
競合サービスとの比較
(編集部注:本セクションの競合情報は、OpenAIの既存技術および他社サービスに関する知見に基づき補足しています)
評価項目
GPT-Live-1 (OpenAI)
Google Gemini Multimodal Live API
OpenAI Realtime API (従来型)
アーキテクチャ フロントエンドとバックエンド(GPT-5.6 Luna)の分離協調
単一のマルチモーダルモデルによる処理
音声入出力を直接処理する単一パイプライン
割り込み耐性 極めて高い(会話の流れを維持したままバックエンドが並行処理)
高い(割り込み検知は可能だが、複雑な処理は一時停止する)
中程度(割り込み時に前の世代のコンテキストが途切れる場合あり)
ツール実行時の挙動 ツール実行中も音声対話を継続可能
ツール実行の完了を待ってから応答する
ツール実行中は音声応答が一時停止する
料金モデル 時間ベース課金(5セント/分)+バックエンド推論代
トークンベース課金
トークンベース課金
取材班の見立てでは、GPT-Live-1の最大の優位性は「対話の継続性」にあります。競合であるGoogleのGemini Liveや、従来のOpenAI Realtime APIでは、AIが外部APIを呼び出したり、複雑な計算(推論)を行ったりする際、その処理が完了するまで音声応答が一時的に無音になる、あるいは不自然な間(ま)が発生するという課題がありました。GPT-Live-1は、推論をバックエンド(GPT-5.6 Luna)に逃がすことで、音声フロントエンドが「ええと、今調べていますね」といった相槌を打ちながら処理を進めるような、極めて人間に近い挙動を可能にしています。
料金・提供プラン
GPT-Live-1の利用料金は、開発者がコストを予測しやすい「時間ベース」の体系が導入されました。
フロントエンドモデル(GPT-Live-1) : 1分あたり5セント($0.05 / minute)バックエンドモデル(推論・ツール実行) : フロントエンド料金とは異なり、使用した推論モデル(GPT-5.6 Lunaなど)およびツールサービスの実績に応じて個別に課金されます。
従来のトークン数に基づく課金体系では、音声の長さや会話の密度によってコストの変動が大きく、予算管理が難しいという開発者の不満がありました。1分あたり5セントという明確な時間課金が導入されたことで、音声エージェントサービスの事業化におけるコスト計算が容易になります。
日本から使う方法
日本の開発者およびユーザーがGPT-Live-1を試すための手順は以下の通りです。
OpenAI Developer Platformへのアクセス
OpenAIの開発者向けポータルサイト(platform.openai.com)にログインします。利用には既存のOpenAI APIアカウントが必要です。APIキーの発行とクレジットのチャージ
APIの利用には、事前にクレジットカードの登録と、デポジット(利用料金の事前チャージ)が必要です。Playground(Workbench)でのテスト
開発者ダッシュボード内の「Workbench」から、動画に登場したGUI環境を利用できます。マイクへのアクセスを許可することで、コードを書くことなくブラウザ上でGPT-Live-1の挙動、割り込み性能、バックエンドとの連携をテストできます。日本語対応について
(編集部注)動画内は英語でのデモとなっていますが、OpenAIのこれまでの音声モデルの仕様を踏襲している場合、日本語を含む複数言語での対話に対応していると考えられます。ただし、バックエンドモデルとの連携における言語依存のレイテンシーについては、実機での検証が必要です。
誰にどう効くのか
エンジニア(開発者)
音声のストリーミング処理や、割り込み発生時の状態管理(ステート管理)という、音声アプリケーション開発における最大の難所をAPI側が吸収してくれます。これにより、複雑な非同期処理のコードを書くことなく、自然に対話できる音声AIエージェントを短期間で実装可能になります。
企画・マーケティング担当者
コールセンターの自動応答システムや、スマートホーム機器、受付ロボット、教育用対話アプリなどにおいて、これまでにない「人間らしい」顧客体験(UX)を企画できます。相槌を打ちながら裏で顧客データベースを検索するような、実用的な対話シナリオが実現します。
経営層・事業責任者
1分あたり5セントという明確なフロントエンドの価格設定により、サービス運営におけるインフラコストの予測精度が劇的に向上します。また、未発表の超高性能モデル「GPT-5.6 Luna」の能力を音声インターフェース経由でビジネスに組み込めるため、競合他社に対する強力な技術的優位性を確保できます。
まとめ
OpenAIが発表した「GPT-Live-1」は、音声フロントエンドとバックエンド推論を分離する新アーキテクチャにより、音声AIの実用性を次の次元へと引き上げました。特に、会話を止めずに裏で推論を回す仕組みは、今後の音声エージェントの標準となる可能性を秘めています。開発者の皆様は、今すぐOpenAIのプラットフォームにアクセスし、Workbenchでその応答速度と割り込み性能を体感することをお勧めします。
動画のタイムテーブル 0:01 プレゼンターが卓上のロボットとLEDディスプレイを起動する 0:03 ロボットが「GPT-Live-1」のAPI提供開始を音声で宣言する 0:13 開発者向けツール「Workbench」の画面を提示し、内部システム構成を解説 0:24 背後で発生する激しい騒音の中でも、ユーザーの音声を正確に認識するデモ 0:39 音声モデルとバックエンドの推論モデル(GPT-5.6 Luna)の連携プロセスを解説 0:52 ロボットが身振り手振りを交えて視聴者へ挨拶を実演する 1:00 LEDディスプレイに利用料金「5¢ a minute」を表示し、価格体系を説明 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)