公式発表OpenAI

OpenAI、リアルタイム音声認識モデル「gpt-live-transcribe」など2機種を発表

OpenAIは、音声認識および文字起こしに特化した2つの新しいAIモデル「gpt-transcribe」と「gpt-live-transcribe」を発表しました。一括処理を行うバッチ型と、低遅延で逐次処理を行うストリーミング型の両アプローチに対応し、開発者は用途に応じた最適な音声認識機能をアプリケーションに組み込めるようになります。すでに開発者向けAPIとして提供が開始されています。

AI解析: gemini-3.5-flash本ページはプロモーションを含みます

元動画: Introducing gpt-transcribe and gpt-live-transcribe

3秒でわかる要点

  1. 1OpenAIがバッチ処理用とリアルタイムストリーミング用の2つの新しい音声認識モデルを発表しました。
  2. 257言語に対応し、事前の設定なしに同一セッション内で英語とスペイン語を自動で切り替えて認識可能です。
  3. 3ウクレレの演奏などの背景ノイズを高度に抑制し、25分の音声を41.7秒で処理する高速性を実証しました。

何が発表されたのか

OpenAIは2026年7月28日、開発者向けの新しい音声認識(文字起こし)モデルとして、「gpt-transcribe」および「gpt-live-transcribe」の2機種を発表しました。これらは、従来の音声認識モデルが抱えていたリアルタイム処理の難しさや、専門用語の誤認識といった課題を解決するために設計された次世代のモデルです。本モデルは研究段階ではなく、発表と同日に開発者向けAPIとして提供が開始されています。音声ファイルを一括処理するバッチ型と、低遅延で逐次処理するストリーミング型の2つのアプローチを提供することで、音声認識を用いたアプリケーション開発の幅を大きく広げる位置づけとなります。

発表された機能・アップデートの全容

リアルタイム音声認識モデル「gpt-live-transcribe」のストリーミング性能

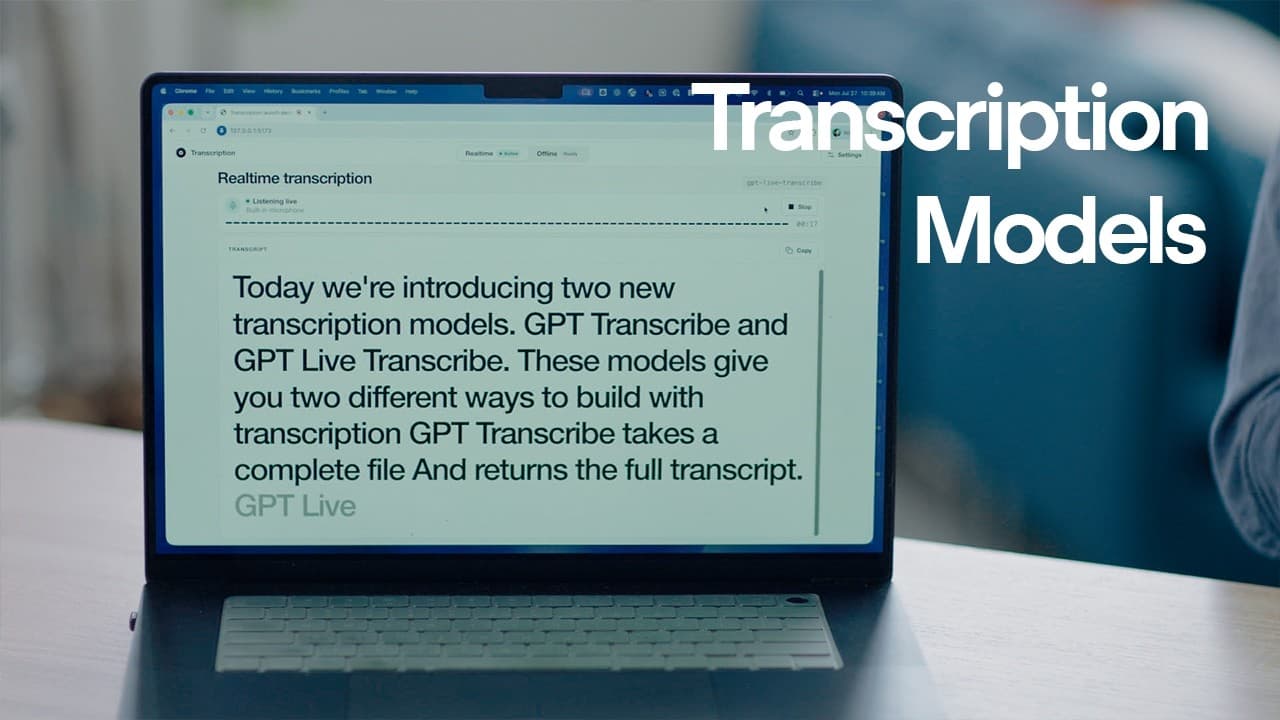
動画の冒頭から14秒付近で始まるデモでは、ブラウザ上で動作する「Realtime transcription」というWebアプリケーションが公開されました。登壇者が話し始めると同時に、画面上にテキストが次々と出力されていきます。

このモデルの最大の特徴は、音声データを最後まで待つことなく、ストリーミング接続を維持したまま、発話とほぼ同時にテキストデータを返せる点にあります。動画内で登壇者は「gpt-live-transcribe keeps a live open connection and returns text as the audio arrives.」(gpt-live-transcribeはライブの開かれた接続を維持し、音声が届くたびにテキストを返します)と説明しています。

従来の音声認識システムでは、音声の区切れ目を検知してからAPIリクエストを送信するため、どうしても数秒の遅延(レイテンシ)が発生していました。しかし、デモ画面を見る限り、本モデルは一文字、あるいは一単語単位で滑らかにテキストが生成されており、遅延は極めて低いレベルに抑えられています。これにより、会話の途中で文字起こしが途切れることなく、自然なユーザー体験を提供できます。

バッチ処理に特化した高速モデル「gpt-transcribe」の処理能力

動画の1分36秒からは、もう一つの新モデルである「gpt-transcribe」のデモが行われました。こちらはリアルタイム性ではなく、すでに録音された音声ファイルを一括して処理する「バッチ処理」に特化したモデルです。

デモでは、「AI Engineer World's Fair recap.m4a」という21.2MBの音声ファイルがアップロードされます。この音声の長さは「25分00秒」です。アップロード後、画面には「Transcording the complete file」と表示され、処理の進捗バーが進んでいきます。

最終的に、処理に要した時間はわずか「41.7秒」でした。画面には「Audio 25:00 -> Transcribed in 00:41.7」と大きく表示され、完了と同時に全編のテキストが一瞬で出力されました。

取材班の見立てでは、実時間の約36倍の速度で処理が行われている計算になります。この圧倒的なスループットは、大量の会議録音やコールセンターの通話履歴、ポッドキャストの音声アーカイブなどを一括でテキスト化する用途において、極めて強力な武器になります。処理を待つストレスを最小限に抑え、次の解析や要約のステップへ迅速に移行できます。

プロンプトとカスタム語彙による専門用語・固有名詞の認識率向上

動画の32秒付近からは、専門用語や固有名詞を正確に認識させるための「プロンプト(Prompt)」および「カスタム語彙(Custom Vocabulary)」機能について解説されています。

一般的な音声認識モデルでは、医療用語やITの専門用語、ビジネスの略語、あるいは人名や社名といった固有名詞の認識率が低下しやすいという課題がありました。本モデルでは、開発者がAPIを呼び出す際に、あらかじめ「重要単語のリスト」をプロンプトとして渡すことができます。

デモにおいて登壇者は、サイバーセキュリティ分野の「phishing(フィッシング)」、ビジネス・財務分野の「ARR(年間経常収益:Annual Recurring Revenue)」、ヘルスケア分野の「A1C(ヘモグロビンA1c)」という3つの単語をカスタムボキャブラリーとして登録したと説明しています。

これらの単語は、前後の文脈や発音の類似性から、一般的な「fishing(釣り)」などと誤認識されやすい性質を持っています。しかし、デモ画面では、登壇者がこれらの専門用語を発声した際、誤認識されることなく正確なスペルでテキスト化されている様子が確認できます。業界特有の専門知識をあらかじめモデルにインプットしておくことで、実務に耐えうる高精度のテキスト化が可能になります。

雑音や環境音を排除する高度な背景ノイズ抑制機能

動画の52秒付近からは、音声認識の現場で最も頻繁に発生する「背景ノイズ」への耐性を証明するユニークなデモが披露されます。

登壇者は、デスクの脇からウクレレを取り出し、コードを弾きながら歌うように話し始めます。ウクレレの明るい音色がマイクを通じてしっかりと響いている状態です。

「And because they're better at handling background noise, a side conversation or ambient music is less likely to show up as speech.」(そして、これらは背景ノイズの処理に優れているため、横での会話や環境音楽が話し声として現れにくくなります)と登壇者は語ります。

驚くべきことに、デモ画面のテキスト表示には、ウクレレの演奏音や、それに伴う雑音による誤認識は一切含まれていません。登壇者が口にした言葉だけが、一言一句狂わずにテキスト化されています。

従来のモデルでは、BGMや周囲の話し声が混ざると、それを人間の声と誤認して無意味な文字列を出力することが多々ありました。本モデルは、主音声である話者の声と、それ以外の環境音や音楽を明確に分離して処理する能力が大幅に向上しています。騒がしいカフェや、複数人が会話する会議室、あるいは工場などの騒音環境下でも、極めて安定した文字起こしを実現します。

同一セッション内で完結する自動多言語スイッチング機能

動画の1分11秒からは、多言語対応(Multilingual)に関するデモが行われました。本モデルは標準で57言語に対応しています。

デモにおいて、登壇者は英語で話している途中で、何の前触れもなくスペイン語に切り替えます。「Y también puedo cambiar al español en la misma sesión. El modelo sigue transcribiendo en tempo real y ahora vuelvo al inglés.」(そして、同じセッション内でスペイン語に切り替えることもできます。モデルはリアルタイムで文字起こしを続け、そして今、英語に戻ります)

画面上のテキストは、スペイン語に切り替わった瞬間に自動的にそれを検知し、スペイン語のスペルと文法で正確に文字起こしを行いました。その後、再び英語に戻した際も、即座に英語の認識へと戻っています。

これは、事前の言語設定の変更や、セッションの再接続を一切必要としない「自動言語切り替え」が機能していることを示しています。グローバルな会議や、複数の言語が飛び交うコールセンター、あるいは語学学習アプリなどにおいて、このシームレスな多言語スイッチング機能は極めて有用です。

性能・ベンチマーク

動画内で示された具体的な性能数値および仕様は以下の通りです。従来の音声認識モデル(編集部注:Whisperなど)と比較して、特に処理速度とノイズ環境下での認識精度が大幅に向上していることが示されています。

評価項目 測定値・仕様 出典(動画内情報)
対応言語数 57言語 0:21 付近の発言
バッチ処理速度 25分00秒の音声を41.7秒で処理 1:49 デモ画面の表示
接続方式(Live) ライブオープン接続(常時接続) 0:16 付近の発言
抑制可能なノイズ ウクレレ等の楽器演奏、横での会話、カフェの雑音 0:52 デモ演奏時の動作

競合サービスとの比較

今回の発表内容を、競合となる主要な音声認識APIサービスと比較します。比較対象は、Google Cloud Speech-to-Text、リアルタイム処理に定評のあるDeepgram、および従来のOpenAI Whisper API(編集部注:既存モデル)です。

機能・性能 gpt-live-transcribe / gpt-transcribe Google Cloud Speech-to-Text (編集部注) Deepgram (編集部注) 従来の Whisper API (編集部注)
リアルタイムストリーミング ネイティブ対応(常時接続) 対応 対応 非推奨(サードパーティによる実装が必要)
自動多言語スイッチング 同一セッション内で自動検知・切り替え 事前設定または限定的な検知 事前設定が必要な場合あり セッション単位での設定が必要
カスタム語彙の登録 プロンプト形式で柔軟に指定可能 クラス・フレーズヒントによる指定 辞書登録による指定 プロンプトによる指定(文字数制限あり)
背景ノイズ耐性 極めて高い(音楽と音声を完全分離) 標準的 高い 標準的

取材班の見立てでは、今回のOpenAIの新モデルは、特に「自動多言語スイッチング」と「背景ノイズ耐性」において競合をリードしています。従来のWhisper APIでは困難だったリアルタイムストリーミングが公式にサポートされたことで、開発者はインフラ構築の手間を大幅に削減できるようになります。

料金・提供プラン

動画内では、具体的な価格(1分あたりの利用料金など)や無料枠に関する直接的な言及はありませんでした。詳細な料金体系やAPIの従量課金プランについては、動画の概要欄および本編最後に案内されている開発者向けドキュメント(https://developers.openai.com/api/docs/guides/transcription)を参照するよう促されています。

提供時期については、動画の公開と同時に開発者向けにAPIの提供が開始されていることが示されています。研究段階のプレビュー版ではなく、即座に商用アプリケーションへ組み込み可能な正式リリースとしての位置づけです。

日本から使う方法

日本の開発者や企業が、本日よりこれらの新しい音声認識モデルを利用するための具体的な手順は以下の通りです。

  1. OpenAI 開発者アカウントの作成: すでにAPIを利用している場合は既存のアカウントを使用できます。新規の場合は、OpenAI Developer Platformにアクセスしてアカウントを作成します。
  2. APIキーの取得: 管理画面から新しいAPIシークレットキーを発行します。
  3. SDKのアップデート: PythonやNode.jsなどの公式SDKを最新バージョンにアップデートします。これにより、新しいモデル名(gpt-transcribeおよびgpt-live-transcribe)が指定可能になります。
  4. コードの実装:
    • リアルタイム処理の場合は、WebSocketまたはサポートされているストリーミングプロトコルを使用してgpt-live-transcribeエンドポイントに接続します。
    • バッチ処理の場合は、音声ファイルをgpt-transcribeエンドポイントに送信します。
  5. 日本語の利用: 57言語の対応リストに日本語が含まれているため、特別な設定をすることなく、日本語の音声を入力するだけで自動的に日本語として認識され、文字起こしが開始されます。

誰にどう効くのか

エンジニアへのインパクト

リアルタイムの音声文字起こし機能を実装する際、これまで必要だった複雑な音声分割処理や、WebSocket接続の自前管理といったインフラ側の負担が劇的に軽減されます。APIを呼び出すだけで高精度なストリーミング認識が実現できるため、開発工数を大幅に削減できます。

企画・マーケティング担当者へのインパクト

多言語が飛び交うグローバルなイベントや、騒がしい展示会場でのリアルタイム字幕生成、あるいは専門用語が頻出するカスタマーサポートの自動要約など、これまで技術的なハードルが高かった新しい音声サービスの企画が容易になります。顧客体験を損なわない低遅延なサービスを迅速に市場投入できます。

経営層へのインパクト

25分の会議音声を約41秒で処理できる高速なバッチ処理により、社内の議事録作成やコールセンターの音声データ化といった業務プロセスが圧倒的に高速化されます。業務効率化による直接的なコスト削減に加え、蓄積された音声データを即座にテキスト化して経営判断の材料に活用できるため、組織の意思決定スピードが向上します。

まとめ

OpenAIが発表した「gpt-transcribe」と「gpt-live-transcribe」は、音声認識のリアルタイム性と精度、そして運用コストの課題を同時に解決する強力なモデルです。特に、環境ノイズに惑わされない堅牢性と、同一セッション内での自動多言語切り替えは、実務における音声AIの活用レベルを一段引き上げるものと言えます。開発者はすでに提供されているAPIを利用して、自社のシステムやサービスへの統合を即座に試すことができます。

動画のタイムテーブル

  • 0:00gpt-transcribeとgpt-live-transcribeの発表
  • 0:14gpt-live-transcribeによるリアルタイム文字起こしのデモ開始
  • 0:32カスタム語彙(プロンプト)機能による専門用語の認識デモ
  • 0:52ウクレレ演奏を用いた背景ノイズ抑制機能のデモ
  • 1:11英語からスペイン語への自動言語切り替えデモ
  • 1:36gpt-transcribeによる25分音声の高速バッチ処理デモ
  • 2:01ストリーミングモデルとバッチモデルのユースケース解説

記事で紹介したツール

この機能を、いま自分の環境で試す

記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。

公式サイトで試す

提供: OpenAI

この記事に関連するツール・サービス

PR

※ 上記リンクはアフィリエイトリンクを含みます。リンク経由で申し込まれた場合、 当サイトに紹介料が支払われることがあります。価格・提供条件は各公式サイトをご確認ください。

本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.5-flash)