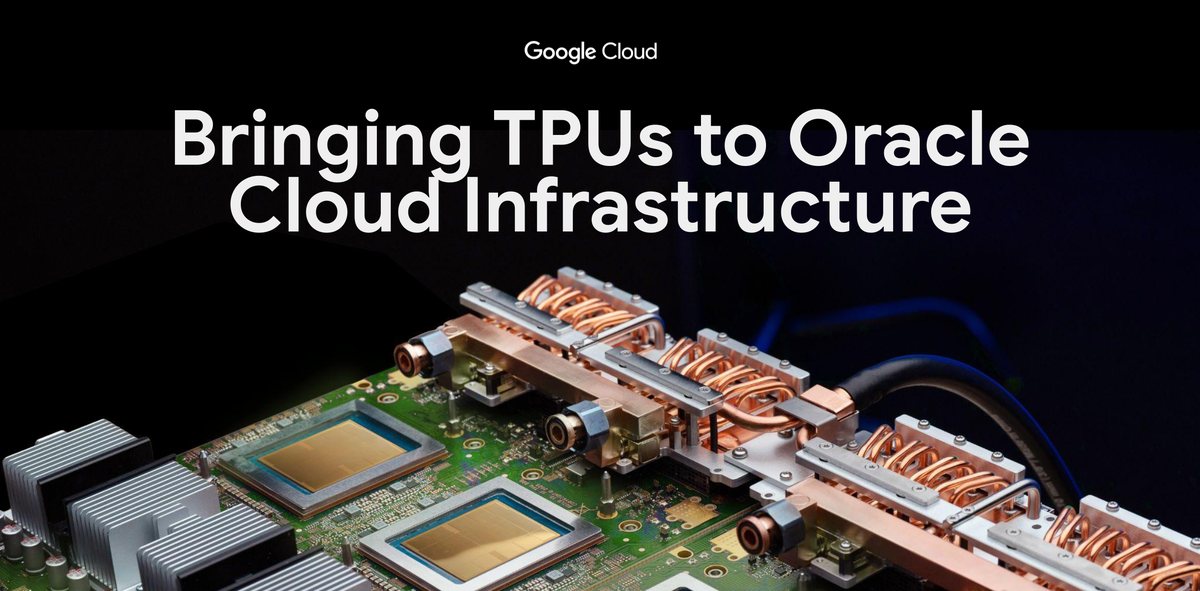
TPUは、Googleが開発したAI専用の計算チップです。PyTorchは、AIモデルを作って動かすために世界中で使われているオープンソースの開発基盤です。
TorchTPUは、この2つを直接つなぐ仕組みです。Google Cloud公式ブログによると、Metaのチームと共同で開発しました。TPUをGPUやCPUと同じ感覚で選べるようにするのが狙いです。
遅延テンソル方式からの転換
Google Cloudのドキュメントによると、これまでTPUでPyTorchを動かすにはPyTorch/XLAが必要でした。計算の流れを記録してまとめて実行する方式で、コンパイルできる範囲を示すコードを足す必要がありました(Google Cloudのドキュメント、11/4確認)。
TorchTPUは、PyTorch標準の「1デバイスにつき1プロセス」の実行方式を使い、処理を即時に実行します。そのため既存の処理やライブラリを、構造を書き換えずに動かせるとされています(同、11/4確認)。
使い方は2段階です。まずイーガーモード(1行ずつ即実行する方式)でデバッグします。次にtorch.compileで本番向けの性能に移ります。公式ブログは「最小限のコード変更」で動かせると説明しており、変更が不要という意味ではありません。
Hugging FaceとMetaの評価
Hugging Faceとは、人気のオープンウェイトモデル(重みを公開したAIモデル)をTPUで動かせるようにしました。Transformers v5ではdevice_map="tpu"を渡すだけで配置できます。画像生成向けのDiffusersもTPU上で動き、テンソル並列処理に対応します。
Hugging Faceのトランスフォーマー群は、TPU上で毎晩自動テストされる体制も整えられました。
Metaでは、PyTorchエンジニアリング担当ディレクターのJana van Greunen氏が「単一のハードウェア アーキテクチャに縛られるわけにはいきません」と述べています。
推論:vLLM、SGLang、llm-d
推論とは、学習済みのAIに答えを出させる処理です。公式ブログは、この費用と応答の速さが本番運用の主な難所になると説明しています。
- vLLM:Inferactと開発したバックエンドで、継続的なバッチ処理、量子化、マルチチップ並列処理に対応します。
- SGLang:RadixArkと開発しました。RadixAttentionで、繰り返されるプロンプト接頭辞の再計算を省きます。
- llm-d 1.0:Red Hat、IBMなどと公開しました。公式ブログは、500人以上の協力者と25の組織のコミュニティとしています。一方、Google Cloudのドキュメントでは35の組織とあり、数字が異なります。
llm-dはCNCFのサンドボックスプロジェクトです。接頭辞キャッシュ対応ルーティングや、プレフィルとデコードの分離ができます。GKEでは共通のエンドポイントのまま、GPUかTPUかを選べます。サイソクでは、llm-d 1.0を10月のAI基盤更新でも取り上げました。
Zenteiq.aiの創業者は、llm-dを使ったGKE Inference Gatewayで、総スループットが4倍以上になったと述べています。1日のトークン生成能力は、TPU v6e 1,000個あたり14億7,000万トークンから59億7,000万トークンに増えたとのことです。これは同社自身の用途での結果です。
学習:TorchTitanは最大8,192個のTPUで検証
TorchTitanには、Llama 3 70B/405B、Qwen 3 8B/32B、Qwen 3 235B、FLUX.1 12Bなどの事前学習用レシピがあります。最大8,000個のIronwood TPU(TPU v7x)での実行が検証されています。
Googleのテストでは、Qwen 3 8Bで最大52%のモデルFLOP使用率(MFU)を示しました。最大8,192個のIronwood TPUで、ほぼ線形のスケーリングと安定性も確認されたとしています。いずれもGoogle自身の測定です。
VeRL(強化学習の枠組み)は、TPUバックエンドとリファレンスレシピがアップストリームされました。これはプレビュー版です。Rayでは、CPU、GPU、TPUをまたぐ処理を1つのワークフローで管理できます。
スマホ向けのLiteRTとTPU Agent Suite
LiteRT(旧TensorFlow Lite)もPyTorchの周辺に加わりました。litert-torch.convert()を1回呼ぶとPyTorchモデルを変換でき、Android、iOS、Windows、Webなどで動かせます。
TPU Agent Suiteのプレビュー版もGitHubで公開されました。導入の案内、診断、性能調整などの自動化を助けるものです。
編集部の見方では、TPUの利用者はGPU中心の開発環境を大きく作り替えずに、TPUを比較対象に加えやすくなります。ただし費用や性能の差は、各社の用途でしか分かりません。