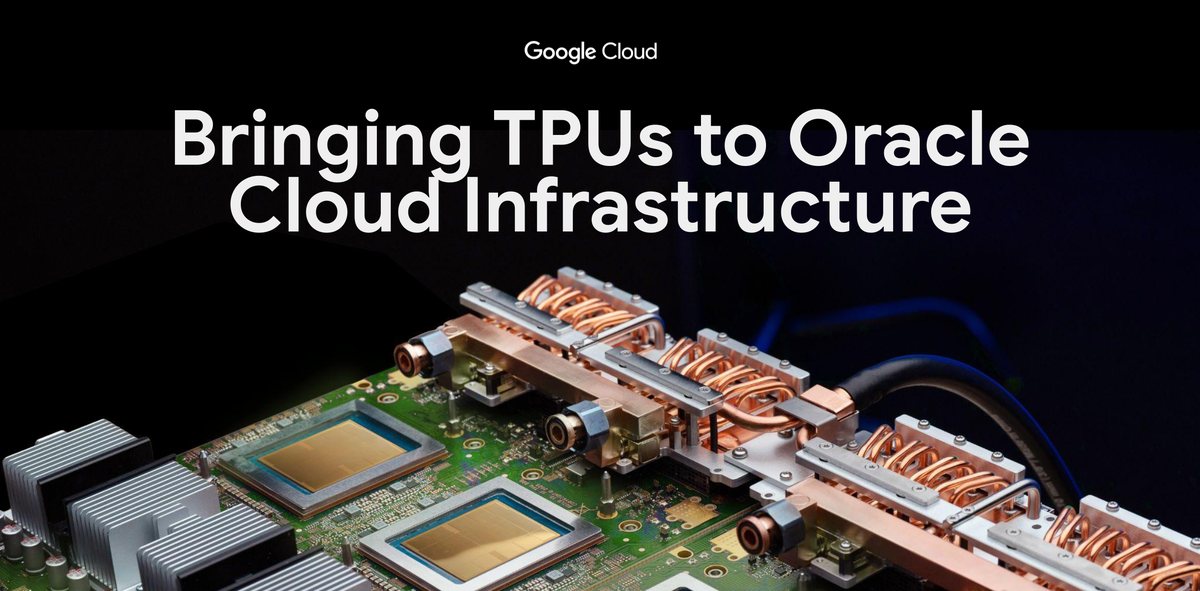
TPU(Tensor Processing Unit)は、Google が AI の計算のために設計したチップです。AI のモデルを学習させる作業と、学習済みモデルに答えを出させる作業の両方に使われます。今回の提携で、その提供先が Google Cloud の外にも広がります。
Google Cloud の公式ブログによると、Oracle と Google Cloud は TPU を OCI に導入します。両社は 2027 年から、OCI 上で TPU キャパシティ(使える計算資源)の導入を始める予定です。価格や提供地域はまだ発表されていません。
投稿者は OCI のシニア バイス プレジデントの Karan Batta 氏と、プロダクト管理担当シニア ディレクターの Gurmeet Goindi 氏です。この投稿は、米国時間 2026 年 10 月 28 日に Google Cloud blog に掲載されたものの抄訳です。
第8世代TPUは1チップで最大12.6 PFLOPS
公式ブログは、TPU の特徴をチップ単体ではなく、システム全体の設計に置いています。カスタムのチップを、光ネットワーキング、電力供給、液体冷却、コンパイラ ソフトウェアとともに設計するという考え方です。
主な数字は次のとおりです。
- 初代の TPU v1 は、当時のプロセッサと比べて 30 倍のワットあたりスループット
- 第 8 世代は、チップあたり最大 12.6 PFLOPS のネイティブ FP4 演算
- 第 8 世代は、前世代より最大 2 倍高いワットあたりパフォーマンス
- TPU v1 は 92 TFLOPS で、第 8 世代はその 100 倍以上
ただしブログは、演算性能の数字だけでは費用対効果は決まらないとも述べています。学習で重要なのはグッドプット(クラスタが有効な計算に使った時間の割合)です。推論(学習済み AI に答えを出させる処理)では、応答の速さとトークンあたりのコストが重要になります。
グッドプットを支えるのが、チップ間をつなぐ ICI(Inter-Chip Interconnect)のルーティングと、光サーキット スイッチング(OCS)です。ハードウェアやリンクの劣化を検出すると、ジョブを再起動せずに、光の通り道を動的に切り替えて障害を避けます。公式ブログは、大規模な学習で数千チップにわたって 97% 以上のグッドプットを維持できると説明しています。
低レイテンシ(応答の速い)サービングでは、オンチップ SRAM と HBM の容量を増やしています。こうして 1 ドルあたりのパフォーマンスは最大 80% 向上するとのことです。これらは Google 側の説明で、測定条件の詳細は示されていません。
さらに、ネットワーク ホップを 50% 以上減らす新しいトポロジを採用しました。
TorchTPUで、PyTorchのコードを書き直さず使う
ソフトウェア面では、PyTorch Conference での発表が背景にあります。Google TPU 向けのネイティブ PyTorch スタック「TorchTPU」が、GitHub でオープンソースとして公開されました。
vLLM、SGLang、llm-d、TorchTitan、Ray、TorchRec、Hugging Face、LiteRT といった既存のツールがあります。これらのツールで、TPU を使って学習、サービング、デプロイができるとしています。
公式ブログは、このポータビリティ(移しやすさ)を強調しています。これにより、チームはモデルコードを書き直さずに、各処理を最適な装置へ割り当てられます。ただし、Google Cloud か Oracle のインフラ上の TPU に割り当てられるようになるのは「まもなく」です。現時点で OCI 上の TPU を使えるわけではありません。
Google Cloud は 10 月にも、TPU 向けの技術を含む AI 基盤の更新を発表していました(Google Cloud、AI基盤の10月更新を発表)。
OCIで得られる4つのメリット
公式ブログは、TPU を OCI で提供する利点として 4 点を挙げています。
1つ目は、データセンターです。TPU システムはラック規模の直接液冷を前提に設計されています。OCI の次世代データセンターもその仕様で構築されているといいます。
フロンティア モデルの学習と本番環境の推論を、需要に合わせて切り替えられる点も強調しています。
2つ目は、ネットワークです。TPU のチップ間は ICI と OCS が担当します。TPU キャパシティを OCI のほかの部分につなぐのが、Oracle Acceleron です。
その SmartNIC(ネットワーク処理を担う専用カード)は、ハードウェア レベルのテナント分離を備えます。高パフォーマンス ファブリックとゼロトラスト パケット ルーティングも備えます。これにより、Oracle データベース、ストレージ、TPU クラスタ間で高スループットかつ低レイテンシのデータ転送ができるとしています。
3つ目は、企業データとの近さです。Oracle データベースは、多くの企業でシステム オブ レコード(業務データの正本)の役割を果たしています。
OCI 内に TPU があれば、費用のかかるクロスクラウド転送をせずに済みます。既存データの近くでファインチューニング(追加学習)と推論ができるとしています。節約額などの数字は示されていません。
4つ目は、選択肢の広さです。OCI は GPU とともに TPU を提供するため、AI の各段階を費用対効果の高い装置へ割り当てやすくなります。
編集部の見方では、Oracle データベースに業務データを置く企業が、最も影響を受けます。ただし、料金や対応する TPU の世代が分かっていないため、導入判断は発表を待つ段階です。