この発表は、IT運用やSRE(サイト信頼性エンジニア。サービスを止めずに動かす担当)の人に関係します。AIで開発が速くなると、本番環境に出す変更の数も増えます。Atlassianの公式ブログは、この変化に合わせた運用の仕組み「AIOps」(AIで運用を支える仕組み)の新機能を紹介しています。
Jira Service Management(IT部門の依頼や障害を管理するツール)を使っていない組織には、今のところ直接の影響はありません。
変更を出す前に、リスクの高いものへ目を向ける
1つ目の新機能は「Prevention Center」です。本番に出す前の変更のうち、リスクが高そうなものを選び、人が確認できるようにする仕組みです。
AIがリスクを評価し、対応策の候補を示します。判断は、承認する側の人が持ちます。
評価するときは、変更に関係する情報をまとめて見られます。プルリクエスト(コードの変更依頼)、デプロイの流れ、関連するチケット、社内のナレッジを1か所に集めます。依存しているサービスの確認や、ほかの作業との日程の重なりの確認もできます(Atlassian公式ヘルプ、11/8確認)。
リスクは次の4つの分類で評価されます(Atlassian公式ヘルプ、11/8確認)。
- 技術面
- 運用面
- コンプライアンスとセキュリティ
- ビジネス
組織の方針や基準を取り込むと、評価と対策の提案も自社のルールに合わせられます。
元の発表では、開発者の作業を遅らせずに、承認する側が本番の品質に自信を持てる状態を保つ狙いが示されています。変更の数が増えるほど、すべてを同じ手間で見るやり方は続きません。リスクに応じて確認の度合いを変えるのが、この機能の考え方です。
障害対応は、監視データとつないで原因まで追う
変更の審査をすり抜けた障害には、「Incident Command Center(ICC)」で対応します。ICCは、障害対応の情報を1つの画面にまとめるAI中心の画面です。障害に関係する直近の変更やデプロイ、アラート、過去の障害、サービス情報、監視データを一覧できます(Atlassian公式ヘルプ、11/8確認)。
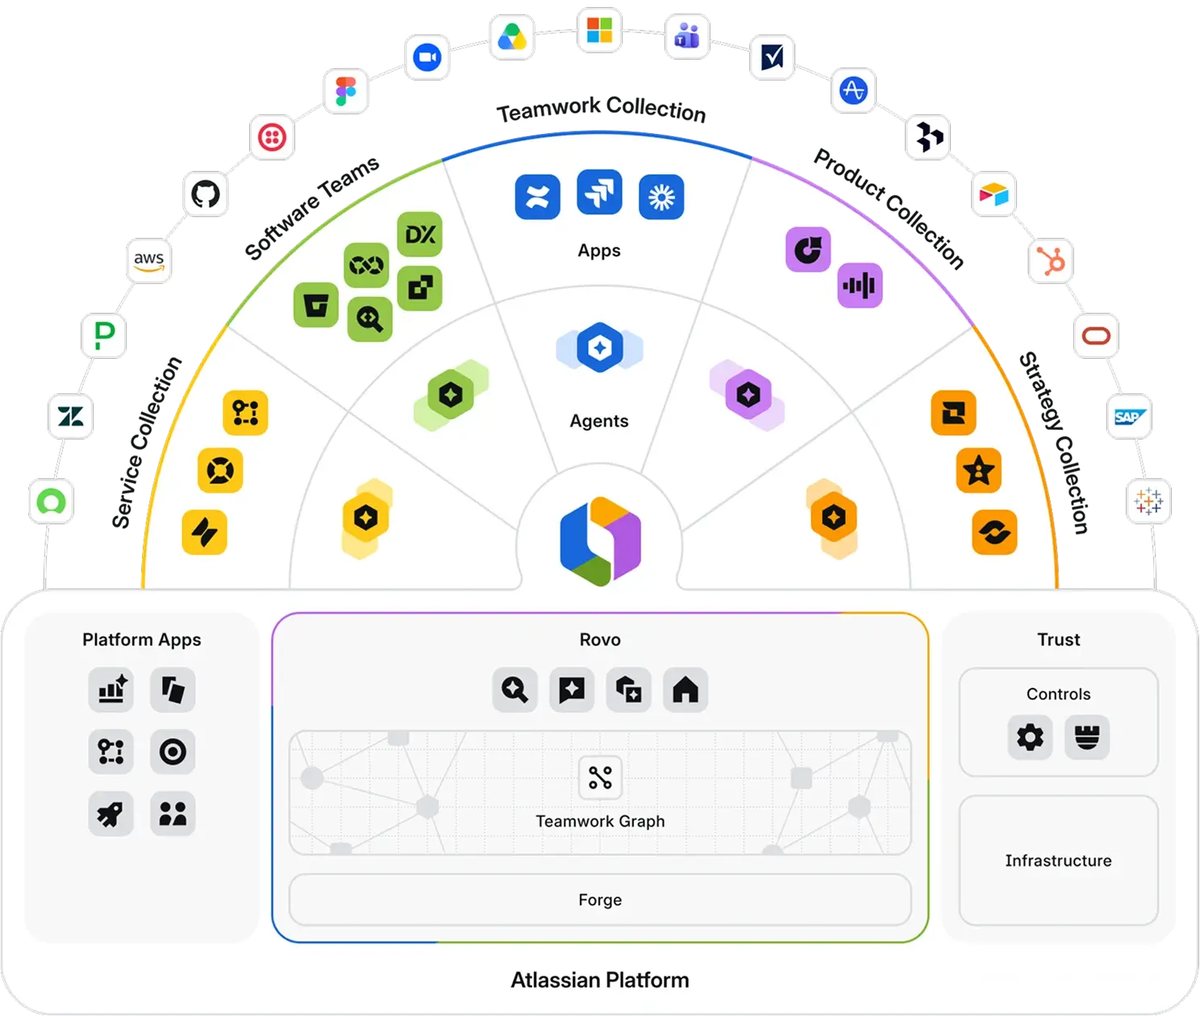
画面の情報を選んで示すのは、Atlassianの生成AI「Rovo」です。Rovoは、社内の開発履歴や担当者などをつなぐ「Teamwork Graph」の情報を使います。対応者は、原因の見当をつけるまでの時間を短くできます。
復旧したあとには、同じ情報をもとに振り返りの文書(ポストインシデントレビュー)が作られます。文書には、根本原因に対する対策が作業項目として並びます。その作業項目はJiraに登録され、開発者やAIエージェント(自分で手順を進めるAI)が引き継げます。
監視ツールとの連携も加わりました。Datadog、Sentry、Splunkの情報を、インシデントの画面に取り込みます。対応者は、ひとつの画面で次の情報を確認できます。
- 影響を受けたサービスと担当者
- 似た過去の障害とその解決方法
- 合う手順書
ここで押さえたいのは、提供の段階です。Prevention CenterとICCは公開ベータ(一般公開前の試験的な提供)です。一方、監視ツールとの連携は一般提供されています。
連携は、Atlassian MCP Gallery(外部ツールとつなぐ仕組みの一覧)経由で、Dynatrace、New Relicなども対象とされています。
公式ヘルプでは両機能を「early access program(EAP)」と表記しています。段階や名称は、開発の進み方で変わる可能性があると説明されています(Atlassian公式ヘルプ、11/8確認)。