公式発表Microsoft Developer

Azure SQL Databaseで10億行のベクトル検索を1秒未満に、DiskANNインデックスが一般提供開始

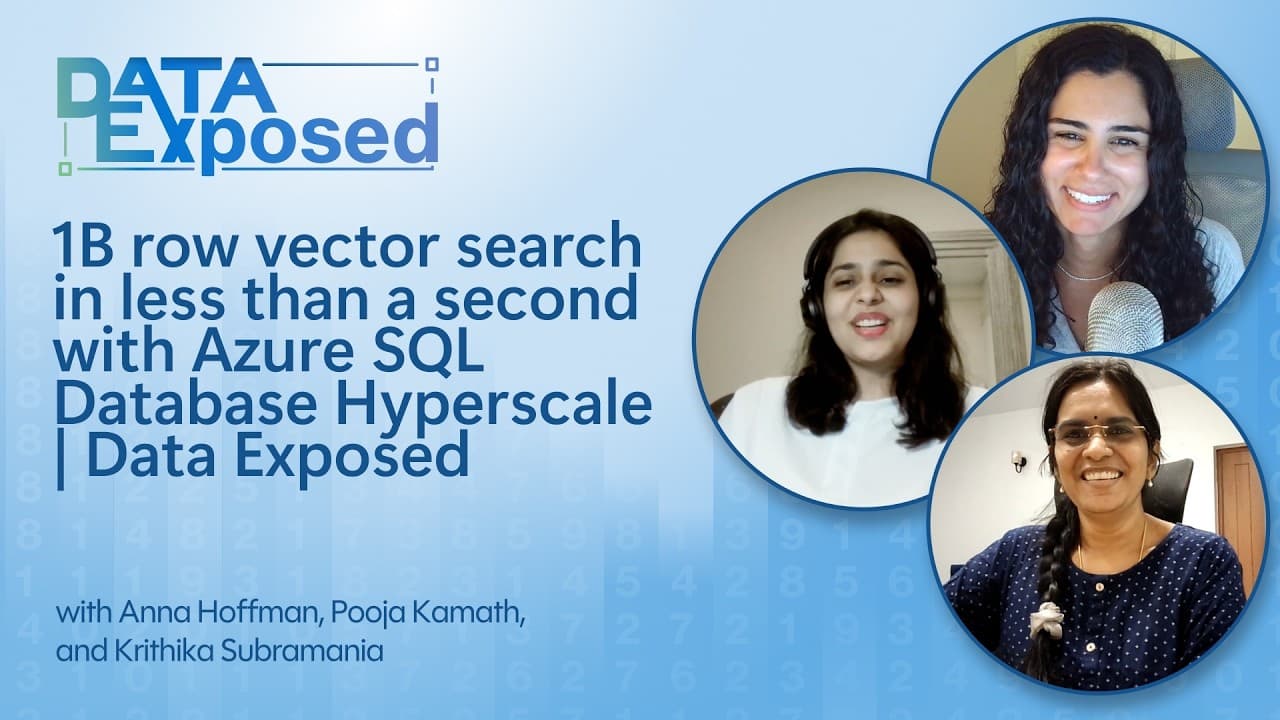
米マイクロソフトは、Azure SQL DatabaseおよびFabric SQLにおいて、グラフベースのベクトルインデックス機能「DiskANN」の一般提供(GA)を開始しました。本機能の導入により、専用のベクトルデータベースを別途導入することなく、既存のリレーショナルデータとベクトルデータを同一のデータベース内で高度に統合して運用することが可能になります。10億行規模の超巨大データセットに対しても、ミリ秒単位の極めて高速な類似性検索を実現します。

AI解析: gemini-3.5-flash

元動画: 1B row vector search in less than a second with Azure SQL Database Hyperscale | Data Exposed

3秒でわかる要点

  1. 1Azure SQL DatabaseにおいてDiskANNベクトルインデックスが一般提供(GA)に達しました
  2. 210億行のベクトルデータに対する類似性検索において、1秒未満(ミリ秒単位)の応答速度を達成しました
  3. 3オプティマイザが「正確な検索」と「近似検索」をクエリの選択度に応じて自律的に選択します

何が発表されたのか

米マイクロソフトは、同社の主要なクラウドデータベースサービスである「Azure SQL Database(Hyperscaleを含む)」および「Fabric SQL」において、最先端のベクトルインデックス技術である「DiskANN」の一般提供(GA:General Availability)を開始したと発表しました。

この機能は、リレーショナルデータベース(RDB)の内部に、グラフベースの高次元ベクトルインデックスを直接統合するものです。これまでプレビュー段階にあった機能が正式リリースとなり、商用環境での利用に耐えうる安定性と性能が保証されました。これにより開発者は、エンタープライズ向けの生成AIアプリケーション、セマンティック検索システム、RAG(Retrieval-Augmented Generation:検索拡張生成)などのシステムを、追加の専用ベクトルデータベースを導入することなく、使い慣れたSQL環境のみで構築できるようになります。

発表された機能・アップデートの全容

ブルートフォース検索の限界とインデックスの必要性

データベースにネイティブなベクトルデータ型とベクトル関数が導入されたことで、初期のプロトタイプ構築は容易になりました。しかし、データ量が増大するにつれて深刻なパフォーマンス低下が発生します。インデックスが存在しない状態でのベクトル検索は、すべての行に対してベクトルの距離計算を行う「ブルートフォース(総当たり)検索」となります。

このアプローチは、データ件数が1万行程度であればミリ秒単位で処理できますが、100万行に達すると秒単位、1000万行を超えると分単位の時間を要するようになり、実質的に運用不可能な状態に陥ります。高次元ベクトルの距離計算は、浮動小数点演算の負荷が極めて高いためです。そこで、検索の計算量を劇的に削減し、大規模データでも高速に応答を返すための専用のインデックス構造が必要となります。

Microsoft Research発のグラフベースインデックス「DiskANN」の統合

マイクロソフトが採用した解決策が、同社の研究開発部門であるMicrosoft Researchが開発し、2019年の機械学習国際会議「NeurIPS」で発表されたベクトルインデックスアルゴリズム「DiskANN」です。これはすでに、検索エンジン「Bing」、協調AI「Microsoft 365 Copilot」、そして「Azure AI Search」などの大規模商用サービスで、数十億から数兆件規模のインデックスを支える実績のある技術です。

DiskANNの最大の特徴は、メモリ空間を極端に圧迫しないアーキテクチャにあります。一般的なベクトルインデックス(HNSWなど)は、高速性を維持するためにすべてのインデックスデータを主メモリ(RAM)上に展開する必要があります。これに対しDiskANNは、SSD(ソリッド・ステート・ドライブ)などの高速なディスクストレージを活用するように設計されています。アクティブに探索される主要なグラフ構造のみをメモリに保持し、詳細なベクトルデータ本体はディスク上に配置することで、極めて高いコスト効率で数十億規模のベクトルをインデックス化できます。ANN(Approximate Nearest Neighbor:近似最近傍探索)の手法を用いることで、正確な結果に限りなく近い近似値を、圧倒的な速度で導き出します。

リレーショナルフィルタと融合する「反復フィルタリング」

実際の業務アプリケーションにおける検索要件は、「類似するデータを10件探す」という単純なベクトル検索だけでは完結しません。例えばカスタマーサポートのシステムでは、「ステータスが『未解決(Open)』であり、特定の製品カテゴリに属し、かつ過去30日以内に投稿されたチケットの中から、現在の問い合わせに類似する上位10件を探す」といった複合的な条件が求められます。

従来のベクトル専用データベースでは、ベクトル検索を最初に行い、その結果に対して後からリレーショナルな条件で絞り込む「ポストフィルタリング(後フィルタリング)」が一般的でした。しかしこの方法では、ベクトル検索で返された上位10件のなかにフィルタ条件に合致するデータが1件も含まれていない場合、最終的な検索結果が空になってしまうという致命的な問題があります。Azure SQL Databaseが実装したDiskANNは、グラフ探索のプロセス自体の中にリレーショナルなフィルタ条件を組み込んで実行する「反復フィルタリング(Iterative Filtering)」をサポートしています。これにより、フィルタ条件を満たす正しい上位N件を確実かつ高速に取得できます。

リアルタイムなデータ更新に追従する非同期DMLサポート

業務システムでは、データが静的に固定されていることは稀であり、常に新しいレコードの挿入(INSERT)、既存レコードの更新(UPDATE)、不要レコードの削除(DELETE)が発生します。Azure SQL Databaseのベクトルインデックスは、これらのDML(データ操作言語)操作に完全に対応しています。

デモでは、新しい記事データを挿入した直後に、その内容に対応するベクトル検索を実行すると、新データが即座に検索結果の最上位に反映される様子が示されました。また、特定の記事の内容を「量子コンピューティング」に関するものに更新(UPDATE)すると、それまで「ベクトルデータベース」の検索クエリでヒットしていた当該記事が結果から除外され、代わりに「量子コンピューティング」の検索クエリの上位に表示される挙動が確認されました。これらのインデックス更新処理は、データベースエンジンのバックグラウンドタスクとして非同期かつ自動的に実行されるため、アプリケーション側で手動のインデックス再構築や同期処理を記述する必要はありません。インデックスの更新状況は、専用のシステム動的管理ビュー(DMV)である sys.dm_db_vector_index_status を通じて、進行度(パーセンテージ)やタスクのステータスをリアルタイムに監視可能です。

オプティマイザによる正確な検索と近似検索の自動選択

Azure SQL Databaseのクエリオプティマイザは、ベクトル検索のクエリに対しても高度なインテリジェンスを発揮します。開発者は、クエリごとに「正確な全件検索を行うべきか」あるいは「DiskANNインデックスを用いた近似検索を行うべきか」をコード上で判断して書き分ける必要はありません。

クエリ内に WITH APPROXIMATE 句を指定しておくだけで、オプティマイザがテーブルの統計情報やフィルタ条件の「選択度(Selectivity)」を分析し、最もコストの低い実行計画を自動的に選択します。例えば、フィルタ条件によって対象データが数件から数十件程度にまで極端に絞り込まれる場合、DiskANNのグラフ探索を行うよりも、絞り込まれた数件に対して直接ベクトル距離を計算(正確な検索)した方が処理コストは低くなります。デモでは、選択度の高いクエリを実行した際、実行計画においてDiskANNインデックスのシーク(Vector Index Seek)ではなく、リレーショナルインデックスのシークとフィルター処理、その後の直接計算が自動的に選択される挙動が示されました。開発者は同一のSQL記述のままで、常に最適なパフォーマンスを享受できます。

10億行スケールでの超高速ベクトル検索デモ

動画のハイライトとして、10億行(1 Billion rows)のベクトルデータを格納した実環境のデータベースを用いた、検索デモが実行されました。このデモは、Azure SQL DatabaseのHyperscale層で稼働する環境で実施されました。

10億行のテーブルに対して、VECTOR_SEARCH 関数を用いて最も類似度の高い上位10件を探索するクエリを実行したところ、応答時間はわずか「32ミリ秒」を記録しました。CPUの処理時間(CPU time)は31ミリ秒、経過時間(Elapsed time)は32ミリ秒であり、実質的に1秒をはるかに下回る一瞬の処理で検索が完了していることが示されました。実行計画を確認すると、バックグラウンドで「Vector Index Seek (DiskANN)」が稼働しており、10億行という膨大なデータスケールに対しても、DiskANNのグラフ探索アルゴリズムとSSDストレージの最適化が極めて有効に機能していることが実証されました。
性能・ベンチマーク

動画内で実演および提示されたベンチマーク数値と、測定条件は以下の通りです。10億行という超巨大データセットにおいて、ミリ秒単位の応答を返している点が特筆されます。

評価指標・項目 測定数値・結果 測定条件・システム構成(動画内提示)
10億行ベクトル検索の応答時間 32ミリ秒 Azure SQL Database Hyperscale, 1,024次元(動画内のクエリパラメータより推測), DiskANNインデックス使用
10億行検索時のCPU時間 31ミリ秒 同上、SET STATISTICS TIME ON による出力値
1万行以下のブルートフォース検索 ミリ秒単位 インデックスなしの全件スキャン(概念図による提示)
100万行のブルートフォース検索 秒単位 同上(スケールアウトしない例として提示)
1000万行のブルートフォース検索 分単位 同上(スケールアウトしない例として提示)
1億行のブルートフォース検索 実行不可能(Not Viable) 同上(スケールアウトしない例として提示)

競合サービスとの比較

Azure SQL DatabaseのDiskANNベクトルインデックスと、競合する他のデータベース製品や専用ベクトルデータベースとの比較は以下の通りです。(※競合製品の仕様は、一般的な市場知識および公開情報に基づき編集部にて補足しています)

機能・特性 Azure SQL Database (DiskANN) 専用ベクトルDB (例: Pinecone, Milvus) 一般的なRDBのベクトル拡張 (例: pgvector)
インデックスアルゴリズム DiskANN (グラフベース、SSD最適化) HNSW, IVFなど (主にインメモリ) HNSW, IVFFlat
メモリ効率 極めて高い (主要グラフのみメモリ保持、実データはSSD) 低い (高速化のために大容量メモリが必須) 低い (HNSW使用時はメモリ消費が激しい)
リレーショナル機能との融合 完全融合 (反復フィルタリングによる一貫したSQL処理) 弱い (メタデータフィルタに限定され、結合は困難) 良好 (リレーショナル機能と統合されている)
DML操作の追従性 自動・非同期 (バックグラウンドタスクが自動実行) 製品による (リアルタイム更新は可能だが管理が必要) 自動 (トランザクションと同期、または手動再構築)
10億行スケールでの実績 実証済み (1秒未満の応答、Bing等で実績あり) 対応可能 (ただし莫大なメモリとクラスタ構築コストが必要) 困難 (メモリ制限により大規模スケールアウトは高コスト)

料金・提供プラン

動画内では、具体的な金額や価格設定の詳細についての言及はありません。しかし、本機能は「Azure SQL Database」および「Fabric SQL」の標準機能の一部として提供されるため、追加の専用ライセンス費用は発生しません。

利用にあたっては、Azure SQL Databaseの現行の価格プラン(Hyperscaleを含む各種サービスティア)に基づくデータベース利用料のみが適用されます。DiskANNインデックスの構築に伴う追加のストレージ消費分(SSD容量)およびインデックス構築・更新時のCPUリソース消費が、通常の従量課金またはプロビジョニングされたリソースの範囲内で課金されます。一般提供(GA)が開始されているため、すでに正式な商用サポートプランの対象となっています。

日本から使う方法

日本のユーザーが、本機能を試すための具体的な手順は以下の通りです。

  1. Azureアカウントの準備: 有効なAzureサブスクリプションを用意し、Azureポータルにアクセスします。
  2. データベースの作成: Azure SQL Database(推奨サービスティア:HyperscaleまたはGeneral Purpose)を新規作成、または既存のデータベースを選択します。Fabric環境を利用している場合は、Fabric SQLデータベースを作成します。
  3. ベクトルの有効化と定義: T-SQL(SQL Server Management StudioやAzure Data Studioなどを使用)で、高次元ベクトルデータを格納するためのカラムを定義します。データ型には、動画内で示されている VECTOR 型(例: VECTOR(1536))を使用します。
  4. DiskANNインデックスの作成: ベクトルカラムに対して、DiskANNインデックスを作成します。T-SQL構文を用いて、距離測定基準(コサイン類似度、ユークリッド距離など)を指定してインデックスを定義します。
  5. クエリの実行: VECTOR_SEARCH 関数を使用し、WITH APPROXIMATE 句を付与してクエリを実行します。これにより、DiskANNインデックスを活用した高速な近似最近傍検索が有効になります。
  6. 日本語対応とリージョン: 本機能はプラットフォームの標準機能であるため、日本国内のリージョン(東日本、西日本)でも制限なく利用可能です。日本語のテキストデータをベクトル化(埋め込み化)する場合は、事前にAzure OpenAI Serviceなどで埋め込みベクトルを生成し、データベースに格納して検索を行います。

誰にどう効くのか

エンジニア・データサイエンティストへのインパクト

既存のSQL ServerやAzure SQL Databaseの知識をそのまま活用し、最先端のAI検索機能を実装できます。専用のベクトルデータベースを別途プロビジョニングし、ETLパイプラインを構築してデータの同期をとるという、極めて煩雑な開発・運用保守の手間から解放されます。データの一貫性とトランザクションの安全性をRDBの基準(ACID特性)で維持したまま、10億行スケールのAIシステムを構築できます。

企画・マーケティング担当者へのインパクト

自社が長年蓄積してきた膨大な顧客データ、商品データ、過去のサポート履歴などを、即座に生成AIやセマンティック検索のソースとして活用可能になります。例えば、「過去の類似する問い合わせ」をミリ秒単位で検索し、顧客への回答を自動生成する高度なサポートAIなどを迅速に市場へ投入できます。新しいアイデアのPoC(概念実証)から本番展開までのリードタイムが劇的に短縮されます。

経営層・IT投資決定者へのインパクト

システム構成のシンプル化により、インフラの調達コストおよび人件費を大幅に削減できます。複数のデータベース製品を並行して運用することによるセキュリティリスクや、データ移行に伴うコンプライアンス上の懸念を最小限に抑えられます。実績のあるマイクロソフトのエンタープライズインフラ上でAIシフトを安全に進めることができ、投資対効果(ROI)を最大化できます。

まとめ

Azure SQL DatabaseにおけるDiskANNベクトルインデックスの一般提供開始は、RDBとAI機能の真の融合を象徴するマイルストーンです。10億行のデータをミリ秒単位で検索できる圧倒的なスケーラビリティと、使い慣れたSQLによる高い操作性を両立した本機能は、今後のエンタープライズAI開発の標準となる可能性を秘めています。読者の皆様におかれましては、まずはAzureポータルから開発環境を立ち上げ、既存のデータセットを用いてその劇的な検索速度を体感されることをお勧めします。

動画のタイムテーブル

  • 0:00番組のイントロダクションと登壇者の紹介
  • 1:13顧客が求めていたベクトル検索のユースケースと課題の共有
  • 2:02データスケール増大に伴うインデックス導入の必要性についての議論
  • 2:37正確な全件検索(ブルートフォース)がスケールしない理由の解説
  • 2:59グラフベースのベクトルインデックス「DiskANN」の基本コンセプト
  • 3:35DiskANNの名称の由来とMicrosoft Researchでの開発背景
  • 4:30リレーショナルフィルタとベクトル検索を融合する反復フィルタリング
  • 5:50ポストフィルタリングに対する反復フィルタリングの技術的優位性
  • 6:33インデックスの自動更新を可能にするDML(挿入・更新・削除)サポート
  • 7:05DML操作に伴うベクトルインデックスのリアルタイム更新デモ
  • 8:00オプティマイザによる正確な検索と近似検索のインテリジェントな選択
  • 10:2010億行の超巨大データセットを用いたベクトル検索のスケール実証
  • 10:4910億行に対するベクトル検索がミリ秒単位で完了するデモの実行
  • 11:17リレーショナルデータベースとしてのベクトル検索のあるべき姿の総括
  • 12:05Azure SQL DatabaseおよびFabric SQLでの一般提供開始の発表

記事で紹介したツール

この機能を、いま自分の環境で試す

記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。

公式サイトで試す

提供: OpenAI

本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.5-flash)