Hugging Faceは、コーディングエージェントとHub機能を連携させ、データ分析からビジネスダッシュボード構築、プライベート共有までを迅速に実現するワークフローを公開しました。データサイエンティストでなくても、自然言語を用いたデータ探索からプロダクション環境へのデプロイまでをシームレスに実行できます。
何が発表されたのか
Hugging Faceは、開発者やビジネスアナリスト向けに、コーディングエージェント(CodexやClaude Code)とHugging Face Hubの諸機能を組み合わせた実践的なビジネスダッシュボード構築ワークフローを提示しました。
本発表は新製品の単体リリースではなく、既存のHugging Face Hubの諸機能(Data Studio、Spaces、Hugging Face CLI/プラグイン)と最新のAIコーディングエージェントを組み合わせたソリューションの解説です。研究段階ではなく、すでに一般提供(GA)されている環境を活用して即座に実践できます。
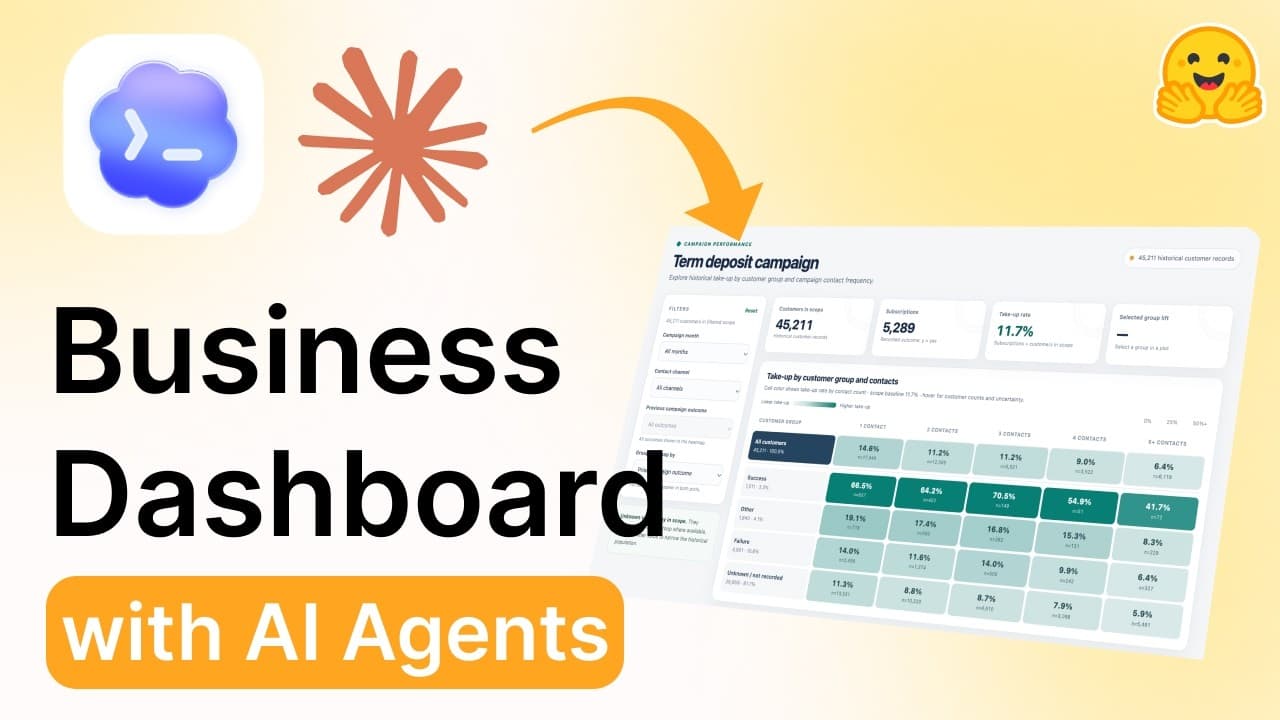
動画内では、ポルトガルの銀行における45,211件の定期預金ダイレクトマーケティングデータセット(cestwc/bank-marketing)を題材とし、CSVファイルのアップロードから自然言語によるデータ探索、KPIの自動選定、対話的な画面改修、そして組織限定共有が可能なプライベートSpaceへのデプロイまでを数分間で完了させるプロセスが実演されました。
発表された機能・アップデートの全容
CodexおよびClaude CodeとHugging Face Hubの連携環境構築
AIコーディングエージェントからHugging Face Hubのリポジトリやデータセットを操作するための認証手順が示されました。Codexを利用する場合は、アプリケーション内のプラグイン検索画面から「Hugging Face」を選択してインストールします。その後、画面指示に従って8桁の認証コードを入力し、OAuth認可を行うことで準備が完了します。
一方、Claude Codeを使用する場合は、事前に端末へHugging Face CLI(hf-cli)をインストールしておく必要があります。ターミナル上でhf auth loginを実行し、ブラウザ経由で認証を完了させることで、Claude CodeがCLIコマンドを介してリポジトリの作成やデータ取得を実行できるようになります。この認証段階で所属組織(Organization)へのアクセス権限を付与しておくことが、後のチーム共有において不可欠です。
Data Studioにおける自然言語データ探索とDuckDBクエリ
Hugging Face上のデータセット詳細画面から直接起動できる「Data Studio」機能の活用法が実演されました。Data StudioにはGPT-oss-120bモデルを基盤としたデータエージェントが組み込まれており、ローカル環境にデータをダウンロードすることなく、ウェブブラウザ上でデータ構造や各列の属性を自然言語で照会できます。
実演では「教育水準(education)の列に含まれるユニーク値は何か」という質問に対し、エージェントがDuckDB WASMを用いたSQLクエリをバックグラウンドで自動発行し、正確な分類コードを提示する挙動が確認されました。これにより、分析担当者は前処理コードを書くことなく、データセットの全体像(定期預金申込率のベースラインが11.7%であること等)を瞬時に把握できます。
ビジネス分析における課題特定とKPIの定義
データセットの理解後、AIエージェントに対して「次の定期預金キャンペーンに向けたビジネス上の質問とKPIを提案せよ」と指示を送ります。エージェントはデータ構造を考慮した上で、顧客属性ごとの申込率比較や連絡回数による成約率の変化といった問いを提示します。
提示されたKPI案には、全体基準となる「ベースライン申込率(11.7%)」、各属性の「グループ規模と構成比」、基準からの乖離を示す「グループ申込率とリフト値」、および「連絡回数別申込率」が含まれます。単にグラフを作成するよう命じるのではなく、事前に計算式やフィルタ適用時の挙動をエージェントと取り決めるステップを挟むことで、分析精度の向上を図るアプローチが強調されました。
コーディングエージェントへのフィードバックとダッシュボードの改善
エージェントが生成した初回のダッシュボードはローカルサーバー上で起動しますが、初期状態の棒グラフや詳細テーブルは人間にとって直感的に理解しにくい課題がありました。ここでユーザーが具体的な改善フィードバックを与えるプロセスが実演されました。
具体的には、「画面上部のフィルタ群を折りたたみ可能なサイドバーに移動させる」「主要可視化を顧客属性と連絡回数を交差させたヒートマップに変更しツールチップを付与する」「最下部のデータテーブルをバブルチャートなどの直感的なグラフへ置き換える」という3点の指示を与えました。エージェントは約11分間の処理でこれらの指示を正確に反映し、洗練されたWebアプリケーションへと進化させました。
Hugging Face Spaceへのプライベートデプロイと組織共有
ローカル環境で完成させたダッシュボードをチームメンバーへ共有するため、Hugging Face Spacesへの自動デプロイが実行されました。ユーザーが「自分のプロファイル配下のプライベートSpaceにデプロイせよ」と自然言語で指示すると、エージェントは自動的に必要なDockerコンテナ構成や依存関係ファイル(README.mdやPythonスクリプト)を作成し、Spaceへプッシュします。
デプロイされたSpaceはビルド処理を経て数分でオンライン状態(Running)となります。設定をプライベートに指定しておくことで、外部への漏洩を防ぎつつ、同一組織(Organization)の所属メンバーのみがブラウザ上でダッシュボードを閲覧・操作できる安全な共有環境が完成します。
性能・ベンチマーク
本発表はシステム構築および分析ワークフローの解説であるため、単体のモデルベンチマーク測定結果は示されていません。ただし、動画内で実行された処理の応答時間およびデータ規模について以下の数値が提示されています。
| 評価項目 / 処理内容 |
測定数値・条件 |
出典 |
| 対象データセット規模 |
45,211件(17カラム、CSV形式) |
動画内スライドおよびData Studio画面 |
| データ全体のベースライン申込率 |
11.7%(5,289件 / 45,211件) |
動画内分析結果画面 |
| Data Studio初期応答速度 |
約2〜3秒(GPT-oss-120b使用) |
動画内実演画面 |
| 画面改修(ヒートマップ化等)処理時間 |
約11分(Codexによるコード生成・再起動) |
動画内経過時間表示 |
| Spaceデプロイおよびビルド完了時間 |
約4分30秒 |
動画内経過時間表示 |
競合サービスとの比較
今回のHugging Faceを活用したダッシュボード構築手法と、他社の類似データ分析・アプリケーション構築環境との比較は以下の通りです。なお、競合サービスの仕様は一般に公開されている知見に基づく比較(編集部注)です。
| 機能・特徴 |
Hugging Face (本ワークフロー) |
OpenAI (ChatGPT Advanced Data Analysis) |
Anthropic (Claude Artifacts) |
Microsoft (Power BI + Copilot) |
| アプリ構築形態 |
Webアプリ(Spaces / Docker / Gradio) |
会話画面内の一時的Pythonコード実行 |
フロントエンドUIの即時プレビュー |
エンタープライズBIツール |
| 継続的なデプロイ機能 |
あり(URLでの永続的ホスティング) |
なし(対話セッション終了で消滅) |
限定的(コード共有のみ) |
あり(Power BI Service) |
| チーム・組織共有 |
強力(Organization権限管理) |
個人利用主体(Teamプラン等限定) |
個人利用主体 |
強力(Azure AD統合) |
| 開発柔軟性 |
極めて高い(任意のコード・ライブラリ) |
限定的(Sandbox環境制限) |
限定的(フロントエンド中心) |
BIツールの枠組みに限定 |
Hugging Faceの最大の強みは、AIエージェントを用いて生成したコードをそのまま「Spaces」という堅牢なホスティング基盤にデプロイできる点にあります。ChatGPTやClaudeのチャット画面内での分析は一次的な検証にとどまりがちですが、本手法では永続的なWebアプリケーションとして組織内に展開可能です。
料金・提供プラン
動画内で示された各機能の利用条件および料金体系は以下の通りです。
- Hugging Face Hubの基本機能: 無料でアカウント作成、データセットの閲覧、Data Studioの利用が可能。
- Pro / Enterprise / Academia アカウント: エージェントによるSpaces作成やDocker環境を利用したプライベートデプロイを行うには、有料のProアカウント、または企業向けのEnterprise、教育機関向けのAcademiaアカウント契約が必要です。
- コーディングエージェント(Codex / Claude Code): 各エージェント(OpenAI APIやAnthropic API等)の契約およびAPI利用料が別途発生します。
日本から使う方法
日本のユーザーが本ワークフローを試すための具体的な手順は以下の通りです。
- Hugging Faceの公式サイト(
huggingface.co)にアクセスし、アカウントを登録します。組織で共有する場合は組織(Organization)を作成します。
- 必要に応じてProプラン以上の契約を行い、高度なSpaces機能やコンテナデプロイを有効化します。
- 使用するローカル環境にCodex(ChatGPTデスクトップアプリ等)またはClaude Code CLIをインストールします。
- ターミナルまたはアプリ内プラグインからHugging Face認証を実行し、OAuthアクセス権限を許可します。
- サンプルデータセット(
cestwc/bank-marketing)等のURLをエージェントに渡し、日本語または英語で「データ分析とダッシュボード作成」を指示します。
- 日本語対応について: 指示を与えるプロンプトやダッシュボード上のラベル表記は日本語でも指定可能ですが、エージェントへの細かな技術指示は英語で行うとより精度が高まります。
誰にどう効くのか
エンジニア・データサイエンティストへのインパクト
ダッシュボードのUI実装やインフラ構築にかかる定型作業をAIエージェントに委託できます。これにより、本質的なデータモデリングや高度な分析アルゴリズムの検討に集中することが可能になります。
企画・マーケティング担当者へのインパクト
プログラミングスキルが乏しくても、自然言語で指示を出すだけでデータセットから必要なKPIを算出し、インタラクティブなダッシュボードを作成できます。施策の検証サイクルが大幅に短縮されます。
経営層・マネジメント層へのインパクト
組織内の安全なプライベート環境でダッシュボードが共有されるため、最新のマーケティング成果や顧客セグメントの動向を迅速かつ安全に把握できます。意志決定のスピード向上に直結します。
まとめ
本ワークフローは、AIエージェントを単なるコード自動生成ツールとしてではなく、分析基盤およびデプロイ基盤と密接に連携した「協働パートナー」として定義する新しい開発スタイルです。
読者が次に取るべきアクションは、自社で保有するCSVデータをHugging Faceのプライベートデータセットとしてアップロードし、CodexやClaude Codeを用いて最初のダッシュボードプロトタイプを出力させてみることです。