ホーム / AI・テクノロジー / Matthew Berman Matthew Berman 2026/10/07
欧州Mistral AIがMistral Large 4 」を 欧州のAIスタートアップであるMistral AIは、新しいオープンウェイトLLM「Mistral Large 4」(コードネーム:Le Chonk)のパブリックプレビューを開始しました。1兆パラメータの規模を誇るMixture of Experts(MoE)構成を採用し、欧州内の自社データセンターでスクラッチから開発されました。サイバーセキュリティや法的文書のベンチマークで極めて高い性能を示す一方、実務でのエージェント利用には課題も見られます。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: Mistral is BACK! (Le Chonk)
3秒でわかる要点 1 Mistral AIが1兆パラメータの最新LLM「Mistral Large 4」のパブリックプレビューを開始しました。2 欧州内のデータセンターで3800基のNVIDIA Grace Blackwellを用いてスクラッチから訓練されました。3 サイバーセキュリティベンチマーク「CyberGym-E2E」においてオープンソースモデル中1位の82点を記録しました。この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
欧州の代表的なAIスタートアップ企業であるMistral AIは、同社のフラグシップモデルの最新世代となる「Mistral Large 4」(以下、ML4)を発表しました。開発チームやコミュニティ内での愛称、あるいはコードネームとして「Le Chonk」とも呼ばれています。本発表は研究段階のデモではなく、開発者向けのパブリックプレビューとしての提供開始となります。すでに同社のAPIサービス「La Plateforme」を通じて利用が可能です。
本モデルの最大の特徴は、モデル全体のパラメータ数が1兆(1 trillion)規模に達する超巨大モデルである点です。さらに、モデルのウェイト(重みデータ)を今月末(2026年10月末)までに一般公開することを確約しています。これにより、既存の中国製オープンソースモデルや米国のクローズドソースモデルに対する、強力な選択肢が提示された形になります。
発表された機能・アップデートの全容
1兆パラメータ規模のMixture of Experts(MoE)構成
ML4は、総パラメータ数が1兆に達する極めて巨大なネイティブマルチモーダルモデルです。しかし、推論時にすべてのパラメータを同時に動かすわけではありません。本モデルはMixture of Experts(MoE)構成を採用しており、推論時にアクティブになるパラメータ数は490億(49 billion active parameters)に抑えられています。これにより、高い表現力と実用的な推論速度を両立させています。特定の専門分野のタスクに対して、最適な「エキスパート」ネットワークのみを動的に選択して処理を行います。
欧州主導のスクラッチ開発とAI主権の確立
本モデルは、中国製などの既存のオープンソースモデルをベースにしたファインチューニングモデルではありません。Mistral AIが欧州内に保有する自社データセンターにおいて、完全にゼロから(from scratch)事前学習が行われました。訓練環境には、3,800基のNVIDIA Grace Blackwell GPUが投入されています。自国内のインフラと技術のみで最先端のLLMを構築することは、欧州における「AI主権(AI Sovereignty)」の観点から極めて重要なマイルストーンとなります。
サイバーセキュリティベンチマークにおける傑出した成績
ML4は、サイバーセキュリティのタスクにおいて世界最高峰の性能を示しています。セキュリティ脆弱性の発見やパッチの自動生成能力を測定する「CyberGym-E2E」ベンチマークにおいて、ML4は「82」というスコアを記録しました。これは、現在公開されているすべてのオープンソースおよびオープンウェイトモデルの中で、中国製の競合モデルを抑えて単独首位となる数値です。クローズドソースモデルに迫る安全性を、自社ホスト可能なモデルで実現しています。
法的文書処理における「Harvey's Legal Agent」の適合性
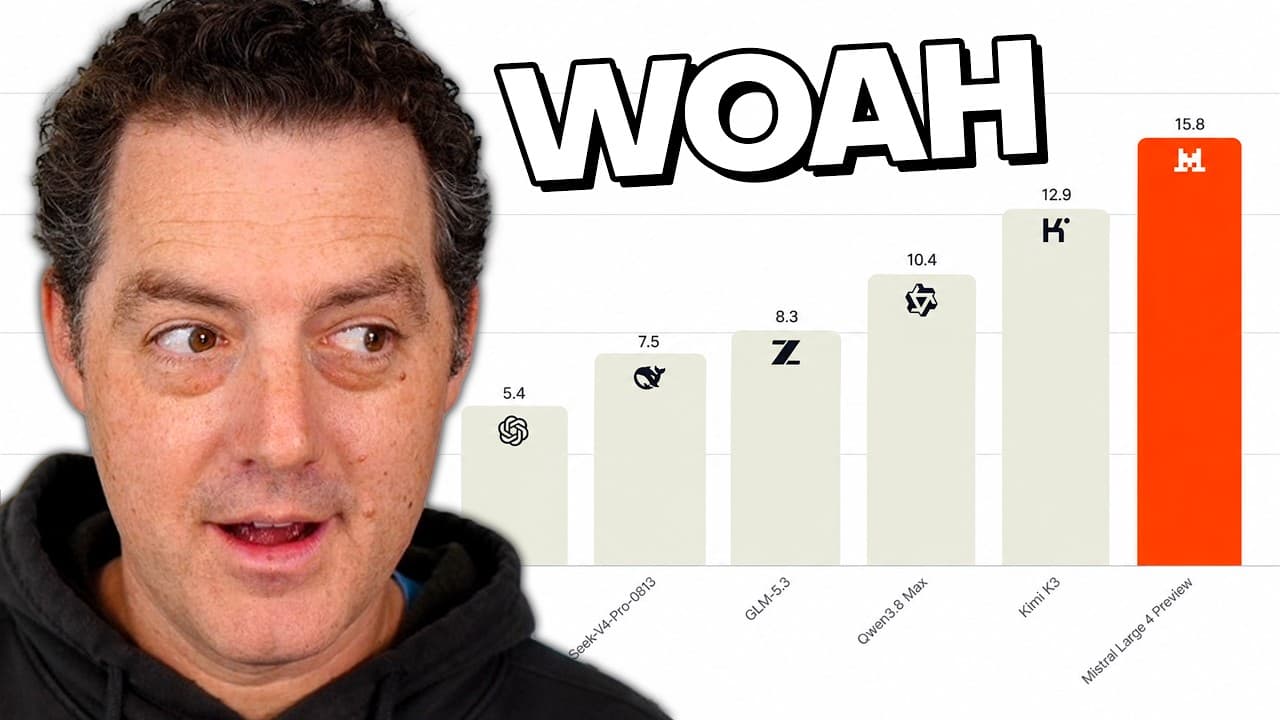
ビジネス実務、特に法務分野での実用性を評価する「Harvey's Legal Agent Benchmark」において、ML4は「12.8」という高いスコアを達成しました。この数値は、米国の主要なクローズドソースモデルの一部を大きく凌駕するものです。複雑な文脈理解と厳密な論理構築が求められるリーガルテックの領域において、ML4が即戦力として機能することを示しています。
実機デモにおける描画バグとエージェント最適化の課題
動画内では、ML4のAPIキーを用いて「ルービックキューブの3Dシミュレーションプログラム」を自動生成するデモが行われました。生成されたコード自体は一見すると正常に動作し、3Dモデルの回転アニメーションも描画されました。しかし、キューブを回転させた瞬間に各面の色が消えてしまうという、可視化のバグが発生しました。自動解決機能(Auto-solve)を実行した際も、最終段階で色がすべてリセットされる挙動が確認されています。取材班の見立てでは、これはモデル単体の思考能力の欠陥というよりも、外部のエージェント開発環境(ハーネス)との連携やプロンプト最適化がまだ十分に成熟していないことが原因と考えられます。
性能・ベンチマーク
動画内で提示された各ベンチマークのスコアを以下に整理します。ML4はコーディングや実務タスク、セキュリティ分野で上位に位置しています。
ベンチマーク名 / 評価指標
Mistral Large 4 (ML4) のスコア
比較対象モデルとスコア
出典・測定条件
DeepSWE 1.1 (開発実務能力)62 (2位)Kimi K3: 68 (1位)
Artificial Analysisによるオープンソース限定評価
Terminal-Bench 4.0 (コマンド操作)31 (2位)GLM 5.3: 40 (1位)
ターミナル操作の自動化タスク
AA Cyber Index (セキュリティ総合)50 (1位タイ)GLM 5.3 Flash: 50
セキュリティ脆弱性の特定と修復
AutomationBench (業務自動化)59.9 (2位)GLM 5.3: 62.2 (1位)
Mistral Medium 3.5からの大幅な向上を確認
Harvey's Legal Agent (法務タスク)12.8 (2位)Kimi K3: 12.9 (1位)
複雑な法的文書の論理整合性評価
CyberGym-E2E (AA) (模擬ハッキング)82 (1位)MIMO: 70台
オープンソースモデルを対象とした検証
Artificial Analysis Intelligence Index 38 (25位)Claude Opus 5.5: 58 (1位)
クローズドソースを含む25モデル中の総合順位
競合サービスとの比較
今回のML4(Le Chonk)の発表内容を、競合する米国および中国の主要モデルと比較します。競合モデルのスペックや詳細な位置づけは、現在の市場データに基づき編集部にて補足しています。
比較項目
Mistral Large 4 (ML4) (Mistral AI)
Claude Opus 5.5 / Fable 5.1 (Anthropic)
GPT-6.1 Sol / Astro (OpenAI)
GLM 5.3 / Kimi K3 (中国系オープンソース)
提供形態 オープンウェイト
クローズドソース
クローズドソース
オープンソース / オープンウェイト
総パラメータ数 1兆パラメータ (MoE)
非公開 (数千億規模と推測)
非公開 (数兆規模と推測)
数千億パラメータ規模
コンテキスト長 524,288トークン (約52万)
1,000,000トークン (100万)
1,000,000トークン (100万)
1,000,000トークン (100万)
推論速度 116トークン / 秒
127トークン / 秒 (Sonnet 5.5)
非公開 (高速化が進む)
227トークン / 秒 (DeepSeek V4.1)
強み 自社ホスト可能
圧倒的な総合インテリジェンス
高いコストパフォーマンス
コーディング能力の高さ
弱み コンテキスト窓が競合の半分
利用コストが極めて高い
完全非公開のブラックボックス
ライセンスや地政学的リスク
取材班の見立てでは、インテリジェンスの絶対値においては依然としてAnthropicのClaude最上位モデルやOpenAIの最新クローズドモデルに数ヶ月から半年の遅れをとっています。しかし、自社でサーバーを構築し、データを完全に隠蔽した状態で運用できる「オープンウェイト」のモデルとしては、世界最高水準の性能に達しています。
料金・提供プラン
ML4はパブリックプレビュー段階として、Mistral AIのAPIプラットフォームで従量課金制にて提供されています。提示された価格は、既存の最高峰モデルと比較して非常に安価に抑えられています。
インプット料金 : 100万トークンあたり 1.36ドル アウトプット料金 : 100万トークンあたり 4.18ドル
(編集部注:この価格設定は、OpenAIのGPT-4oやAnthropicのClaude 3.5 SonnetのAPI価格と比較しても半額以下であり、1兆パラメータ規模のモデルとしては破格のコストパフォーマンスを実現しています。)
日本から使う方法
日本のユーザーが、本日よりMistral Large 4のパブリックプレビューを試すための具体的な手順は以下の通りです。
Mistral AIのプラットフォームへアクセス
公式開発者サイト「Mistral La Plateforme(La Plateforme)」にアクセスします。開発者アカウントの作成
メールアドレスまたはGitHub、Googleアカウントを連携してアカウントを作成します。APIキーの取得
ダッシュボードから「API Keys」セクションに移動し、新規APIキーを発行します。初期利用枠またはクレジットカードの登録が必要です。エージェント環境への組み込み
OpenCodeやCursorなどの開発ツール、あるいは自作のPythonスクリプトにAPIキーを設定します。モデル名には「mistral-large-4-preview」を指定します。日本語対応と注意点
モデル自体は多言語に対応しており、日本語による指示やコード生成も可能です。ただし、現時点では一般向けのチャットUI「Le Chat」には直接組み込まれていないため、API経由での利用が必須となります。
誰にどう効くのか
エンジニア・開発者へのインパクト
自社でホスト可能な高精度なコード生成モデルとして、極めて強力な選択肢になります。特に、機密性の高い商用コードを扱うプロジェクトにおいて、外部のクローズドAPIにデータを送信することなく、ローカル環境や自社クラウド上で安全にコード補完やデバッグを実行できます。
企画・マーケティング担当者へのインパクト
マルチモーダル対応と高い日本語理解力を活かし、大量の製品画像やドキュメントを読み込ませた上でのコンテンツ生成や、高精度な社内ナレッジベース(RAG)の構築が低コストで実現します。API費用が安価なため、プロトタイプの検証を繰り返す際の予算的ハードルが下がります。
経営層・セキュリティ統括者へのインパクト
「AI主権」の確保とデータプライバシーの完全なコントロールが可能になります。個人情報や財務データ、未公開の知的財産を扱う業務において、クローズドLLMの利用に伴うデータ流出リスクを完全にゼロに抑えつつ、最先端のAI機能を社内システムに統合できます。
まとめ
Mistral AIが発表した「Mistral Large 4」は、欧州の自社インフラでスクラッチ開発された、AI主権を象徴する画期的な1兆パラメータモデルです。クローズドモデルに匹敵するサイバーセキュリティ性能と、極めて安価なAPI価格を両立させています。開発者や経営層の皆様は、まずLa PlateformeでAPIキーを取得し、自社の機密データを扱う業務システムやセキュリティ監査ツールでの検証を開始することをおすすめします。
動画のタイムテーブル 0:00 Mistral Large 4(Le Chonk)のパブリックプレビュー開始を報告 1:01 モデル概要とMixture of Experts(MoE)構成の解説 2:53 APIの提供価格とトークン単価の提示 5:39 コーディングベンチマーク「DeepSWE 1.1」の結果分析 6:41 サイバーセキュリティ指標「AA Cyber Index」の比較 7:41 法的文書ベンチマーク「Harvey's Legal Agent」での優位性 8:11 欧州でのスクラッチ開発とAI主権(Sovereignty)の意義 9:25 API経由での利用方法とエージェント開発における課題の指摘 10:03 思考トークンの過剰消費によるコンテキスト上限到達の不満 11:50 サイバーセキュリティ性能の深掘りと優位性の説明 12:25 「Artificial Analysis Intelligence Index」での全体的な位置づけ 14:08 コスト対性能の散布図を用いた競合モデルとの比較 16:12 コンテキストウィンドウ(約52万トークン)の制限に関する指摘 16:45 出力速度(116トークン/秒)の評価 17:43 ルービックキューブシミュレーション of コード生成デモと検証 18:57 シミュレーション実行時の描画バグとエージェント最適化の課題 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)