公式発表NVIDIA
NVIDIA、機密データを守る「Confidential Computing」を解説。モデルとデータの双方を秘匿
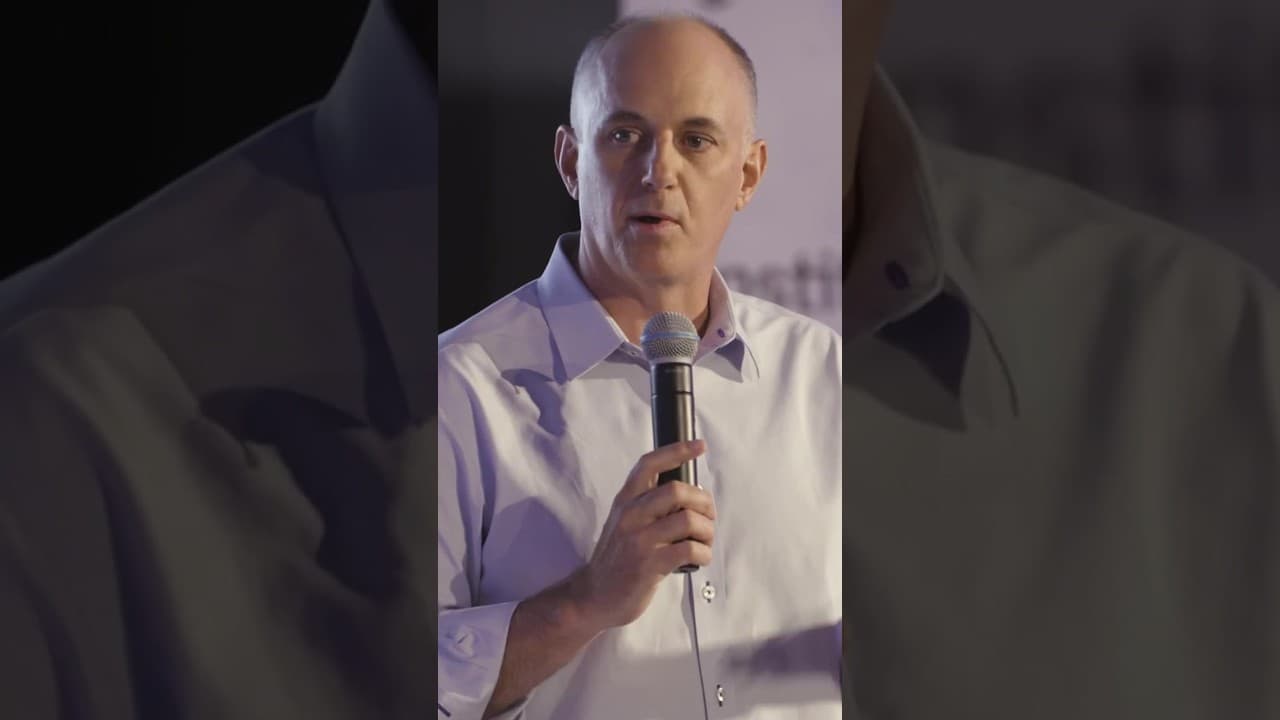
NVIDIAは、企業の機密データとAIモデルの知的財産を同時に保護する「NVIDIA Confidential Computing」の重要性について、同社VPのJustin Boitano氏とVAST DataのCEOであるRenen Hallak氏の対談動画を公開しました。金融や医療などの規制業界において、外部に持ち出せないデータと、モデル開発者が秘匿したいモデルの重み(ウェイト)を両立させる技術の仕組みを解説しています。
AI解析: gemini-3.5-flash本ページはプロモーションを含みます
まとめこの話題の全体像はこちらConfidential Computing の全貌と安全な AI 運用の未来:NVIDIA らの最新発表を徹底統合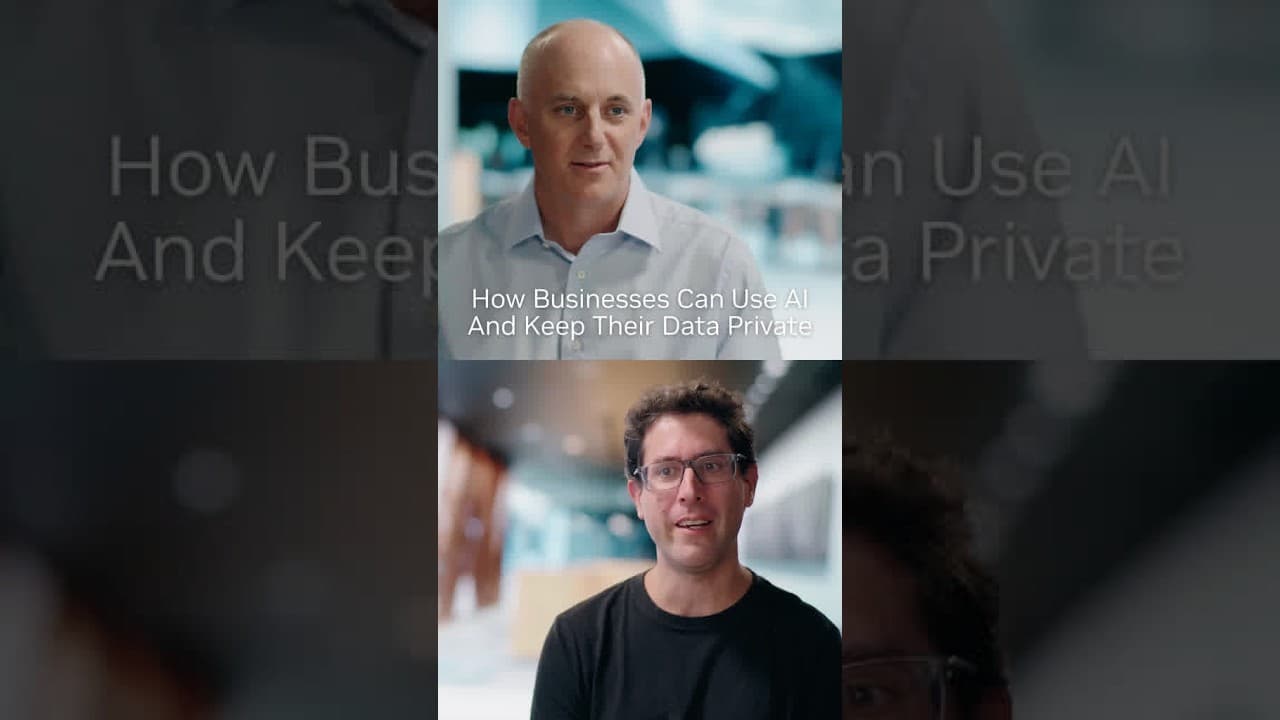
元動画: How businesses can use AI and keep their data private
3秒でわかる要点
- 1企業データとAIモデルの知的財産(重み)を同時に保護するセキュリティ技術の仕組みを解説
- 2医療や金融、政府機関など、データをクラウドに移動できない規制業界でのAI活用に道を拓く
- 3暗号化されたモデルの重みはデータセンター内でも復号されず、管理者すら閲覧不可能
何が発表されたのか
今回公開された動画は、NVIDIAのEnterprise AI担当バイスプレジデントであるJustin Boitano(ジャスティン・ボイタノ)氏と、データプラットフォームを提供するVAST DataのCEOであるRenen Hallak(レネン・ハラク)氏による対談です。テーマは、企業が所有する機密データのプライバシーを完全に保護しながら、最先端のAIモデルを安全に実行するための技術「NVIDIA Confidential Computing(コフィデンシャル・コンピューティング)」の重要性と仕組みについてです。
本技術は、NVIDIAのH100 Tensor コア GPUなどの最新ハードウェアに組み込まれているセキュリティ機能をベースにしています。研究段階のものではなく、すでに一般提供(GA)されている実用的なソリューションです。企業が自社のデータセンターやプライベートクラウド環境において、外部にデータを一切流出させることなく、かつAIモデル開発者の知的財産である「モデルの重み(ウェイト)」も暗号化したまま実行できる環境を提示しています。
発表された機能・アップデートの全容
1. 企業データとモデル知的財産の「相互不信」を解消するアプローチ
動画の冒頭でVAST DataのRenen Hallak氏は、エンタープライズAIの導入における最大の障壁として「データの所有権と知的財産の衝突」を挙げています。企業側は自社の機密データを外部に渡したくありません。また、法的な規制によりデータを外部に出すことが禁止されているケースも多々あります。一方で、大規模言語モデル(LLM)などを開発するモデルビルダー側も、巨額の投資をして構築した「モデルの重み(ウェイト)」を外部に開示したくないという強い要望を持っています。
NVIDIA Confidential Computingは、この双方の「渡したくない」という要求を同時に満たす技術です。データをモデル開発者に渡す必要がなく、同時にモデル開発者もモデルの重みをプレーンテキスト(暗号化されていない状態)で企業に渡す必要がありません。双方の資産を暗号化したまま、安全なハードウェア領域の内部でのみ結合して処理を行うことが可能になります。
2. 規制業界におけるオンプレミスAI実行の必然性
NVIDIAのJustin Boitano氏は、医療(ヘルスケア)、金融、政府機関などの「規制市場(Regulated Markets)」における具体的な課題を指摘しています。これらの業界では、金融取引データ、電子カルテなどの医療記録、政府の契約書など、極めて機密性の高い情報を取り扱います。そのため、データをパブリッククラウドにアップロードしてAI処理を行うことは法的に不可能です。
AIの価値をこれらの業界で引き出すためには、モデルをクラウドに持っていくのではなく、モデルをデータのあるオンプレミスのデータセンター側に「持ち込む」しかありません。しかし、単にモデルを持ち込むだけでは、モデル開発者側の知的財産がデータセンターの管理者やオペレーターに盗み見られるリスクが生じます。この課題を解決するために、ハードウェアレベルでのセキュリティが必要となります。
3. 暗号化されたモデルウェイトを復号せずに実行する技術
Justin Boitano氏が解説する最大の技術的ブレイクスルーは、暗号化されたモデルウェイトをデータセンターに持ち込み、それを「決して復号することなく」GPU内部で処理する仕組みです。モデルビルダーから提供された暗号化モデルは、GPUのハードウェア内部に設けられた「信頼実行環境(TEE: Trusted Execution Environment)」に直接読み込まれます。
この暗号化されたモデルの重みは、システムメモリやストレージ上では常に暗号化された状態を維持します。GPU内部の安全なプロセッサ領域でのみ一時的に復号されて演算に使用されるため、データセンターを物理的に管理しているシステム管理者や、ホストOSのルート権限を持つオペレーターであっても、モデルの重みや処理中のデータを覗き見ることはできません。これにより、完全なゼロトラスト環境でのAI推論が実現します。
性能・ベンチマーク
本動画内においては、具体的なベンチマーク数値やパフォーマンスの比較スコアの提示はありません。
ただし、技術的な背景として、NVIDIAのConfidential Computingはハードウェアによる高速な暗号化・復号エンジンをGPUに統合しています(編集部注:NVIDIAの公開仕様によると、H100 GPUにおけるConfidential Computingの有効化による性能への影響は、通常の処理と比較して数%のオーバーヘッドに抑えられており、実用上ほぼ無視できるレベルで高速な処理が維持されるとされています)。
| 評価指標 |
測定条件 |
スコア / 特徴 |
出典 |
| 処理パフォーマンス |
GPU内部でのハードウェア暗号化 |
ソフトウェア暗号化に比べ極めて低遅延 |
編集部注(NVIDIA技術仕様) |
| 暗号化キーの管理 |
ハードウェアによる自動生成 |
外部へのキー漏洩リスクを完全に排除 |
動画内解説(0:34) |
| メモリ保護 |
TEE(信頼実行環境)による隔離 |
管理者権限(Root)でもアクセス不可 |
動画内解説(0:39) |
競合サービスとの比較
NVIDIA Confidential Computingと、主要な競合プラットフォームが提供するセキュリティ機能の比較は以下の通りです(編集部注:競合の仕様は各社の公開ドキュメントに基づきます)。
| 比較項目 |
NVIDIA Confidential Computing |
OpenAI API (Enterprise) |
Microsoft Azure Confidential VM |
| データの配置場所 |
オンプレミス / 自社データセンター |
クラウド(OpenAI社環境) |
クラウド(Azure環境) |
| モデルの保護 |
暗号化したままGPUで実行(モデルの重みを秘匿) |
モデルはOpenAIが保持(ユーザーには非開示) |
仮想マシン全体を暗号化(GPU連携は限定的) |
| データの移動 |
移動不要(データのある場所で実行) |
クラウドへの送信が必要 |
クラウドへの送信が必要 |
| 主な対象業界 |
医療、金融、政府機関など極めて厳しい規制業界 |
一般エンタープライズ、Webサービス開発 |
クラウド移行が可能な金融・ヘルスケア企業 |
| ハードウェア依存性 |
NVIDIA H100 / H200 / B200 GPU |
依存なし(API経由) |
AMD SEV-SNP / Intel TDX等 |
取材班の見立てでは、OpenAIなどのAPIサービスは手軽であるものの、データを外部に一歩も出せない超規制業界においては選択肢になり得ません。NVIDIAのソリューションは、データのローカル保持と最先端AIモデルの利用を両立させる唯一の現実解となっています。
料金・提供プラン
動画内では、具体的な料金やライセンス費用に関する言及はありません。
一般的に、NVIDIA Confidential Computingを利用するためには、以下のコンポーネントが必要となります(編集部注)。
- 対応ハードウェア: NVIDIA H100 / H200 Tensor コア GPU、またはそれ以降の世代のGPUを搭載したサーバー。
- ソフトウェアライセンス: 「NVIDIA AI Enterprise」ライセンス。これにConfidential Computingを有効化するためのソフトウェアスタックが含まれます。
- パートナー製品: VAST Dataなどの対応データプラットフォームや、各OEMサーバーベンダーのシステム。
価格は導入規模や構成によって異なるため、認定パートナーまたはNVIDIAへの直接の問い合わせが必要です。
日本から使う方法
日本のユーザーがNVIDIA Confidential Computingを導入し、試すための具体的な手順は以下の通りです。
- ステップ1:対応GPUサーバーの選定
NVIDIAの認定OEMパートナー(Dell Technologies、HPE、Lenovo、富士通、NECなど)から、Confidential Computingに対応したH100等のGPU搭載サーバーを選定します。
- ステップ2:NVIDIA AI Enterpriseの契約
本機能を利用するために必要なソフトウェアスイート「NVIDIA AI Enterprise」のライセンスを国内代理店から購入します。
- ステップ3:データ基盤の構築
動画内に登壇しているVAST Dataなどのエンタープライズデータプラットフォームを導入し、機密データを安全に格納・処理できる環境を整備します。
- ステップ4:日本語対応とローカルLLMのインポート
国内で開発されている日本語特化型のLLM(Llama 3の日本語ファインチューニング版など)の暗号化モデルを用意し、セキュアな環境内にインポートして推論を実行します。
誰にどう効くのか
エンジニアへのインパクト
インフラおよびセキュリティエンジニアは、これまで不可能だった「機密データのAI活用」を、社内のセキュリティポリシーを一切変更することなく実現できます。ホストOSやハイパーバイザの脆弱性を突かれたとしても、GPU内部のデータは保護されるため、セキュリティ設計の負担が大幅に軽減されます。
企画・マーケティングへのインパクト
顧客の個人情報や購買履歴、機微な行動データなど、これまで「漏洩リスク」を懸念してAI活用を断念していたデータを使った、高度なパーソナライズサービスや分析の企画が可能になります。競合他社がアプローチできなかった未開拓のデータ資産を有効活用できます。
経営層へのインパクト
自社の競争力の源泉である独自データ(知財)を完全に保護しながら、同時にAIモデル開発者の最新技術を取り入れることができます。データの外部流出によるレピュテーションリスクや制裁金リスクをゼロに抑えつつ、安全なDX(デジタルトランスフォーメーション)を強力に推進できます。
まとめ
AIの進化において、データのプライバシーとモデルの知的財産保護は、常にトレードオフの関係にありました。NVIDIA Confidential Computingは、ハードウェアレベルの暗号化によってこのジレンマを完全に解決し、医療や金融などの規制業界におけるAI導入を加速させます。自社に眠る機密データを活用したい企業は、まず対応GPUの調達とセキュリティ要件の整理から着手することをおすすめします。
動画のタイムテーブル
- 0:00企業とモデル開発者の双方が抱える「データとモデルを渡したくない」というジレンマ
- 0:09医療・金融・政府機関など、データをクラウドに移動できない規制業界の現状と課題
- 0:34NVIDIA Confidential Computingによる暗号化モデルの実行と、データセンター内での秘匿化
記事で紹介したツール
この機能を、いま自分の環境で試す
記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.5-flash)