ホーム / AI・テクノロジー / NVIDIA NVIDIA 2026/08/05
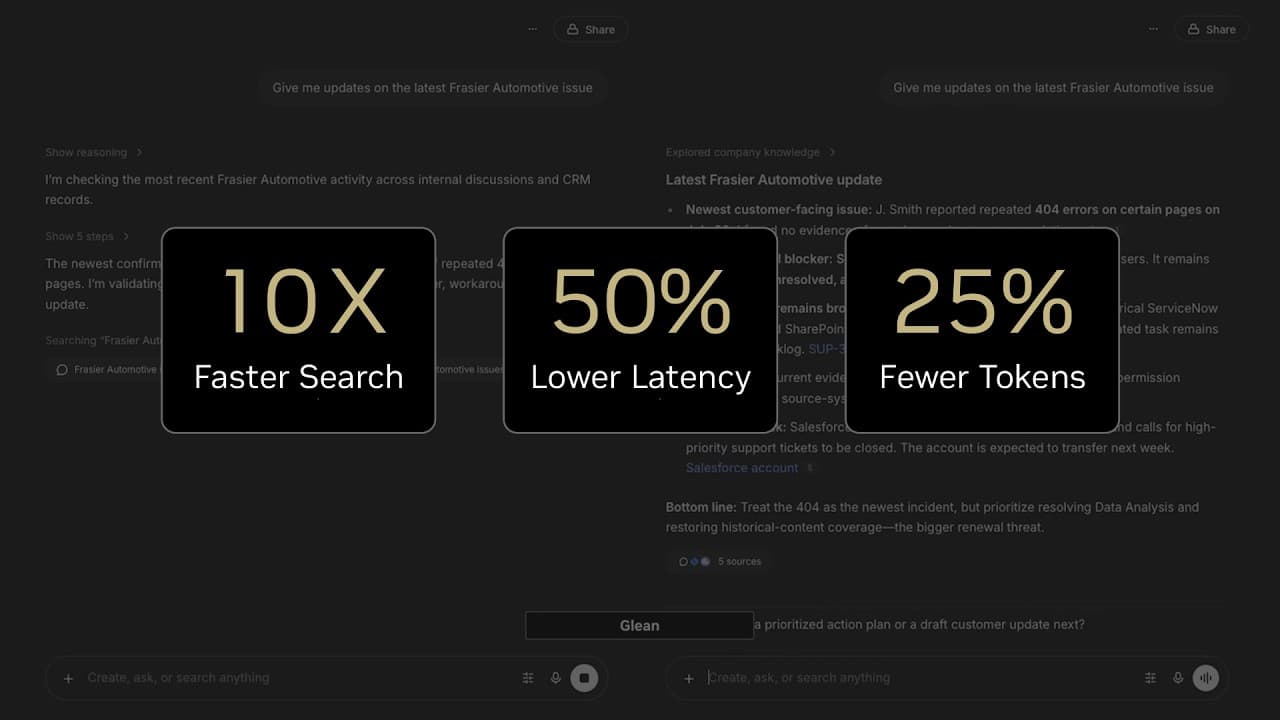
NVIDIAとSystem of Models 」 米NVIDIAは企業向け検索・AIプラットフォームを展開する米Gleanと連携し、単一の大規模言語モデル(LLM)に頼らず、タスクに応じて複数のモデルを最適に使い分ける「System of Models」アプローチの有効性を発表しました。NVIDIA Nemotron-3 Nanoをベースにした専門モデル「Waldo」をルーティング役に配置することで、回答精度を落とすことなく応答速度を10倍に高速化し、レイテンシを50%削減、消費トークン数を25%削減した成果を明示しました。
AI解析: gemini-3.6-flash 本ページはプロモーションを含みます
元動画: Why AI Agents Need More Than One Model
3秒でわかる要点 1 NVIDIAとGleanが複数のLLMを使い分ける「System of Models」アプローチの有効性を発表。2 Nemotron-3 Nanoベースの「Waldo」がコンテキストを収集し、フロンティアモデルとオープンモデルを最適ルーティング。3 Gleanでの検証において、回答精度を維持したまま検索速度10倍、レイテンシ50%削減、トークン25%削減を達成。この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
米NVIDIAは、企業向けAI検索プラットフォームを手がける米Gleanと提携し、単一の巨大言語モデル(LLM)に依存するのではなく、性質の異なる複数のモデルをオーケストレーションして利用する「System of Models(モデルの複合システム)」アーキテクチャの解説動画を公開しました。
本発表では、最先端の「フロンティアモデル」と、社内データで微調整(ファインチューニング)された「オープンモデル」を組み合わせてAIエージェントを構成する実務的な設計指針が示されています。研究段階の概念実証(PoC)にとどまらず、Gleanの実際のエンタープライズ製品で稼働するルーティングモデル「Waldo」の具体例を挙げ、処理速度の向上と運用コスト削減を両立するソリューションとして商用提供済みであることを明らかにしました。
発表された機能・アップデートの全容
1. タスクの複雑度に応じた「System of Models」の基本アーキテクチャ
AIエージェントの導入において「万能な単一モデル」は存在しないという前提に基づき、複数のモデルを動的に制御する仕組みが体系化されました。動画冒頭ではTogether AI、Perplexity、ChatGPT、Claude、Gleanなどの画面が提示され、各種プラットフォームが既に多様なモデルを統合している状況が示されます。高精度な深い推論を必要とするタスクには大規模なフロンティアモデルを割り当て、処理速度や低コスト、セキュリティが重視される定型タスクにはオープンモデルやオンプレミスモデルを割り当てるという明確な役割分担が提案されています。
2. コンテキスト収集と判別を担う専門モデル「Waldo」の機能
Glean内部で機能する専門モデル「Waldo」は、NVIDIAの小規模言語モデル「Nemotron-3 3B Nano」をポストトレーニング(事後学習)して構築された中間ルーティングエンジンです。ユーザーから入力されたクエリを受け取ると、Slackの会話履歴、ServiceNowのサポートチケット、社内アンケート調査データ(Survey Data)など、社内環境に分散する膨大なコンテキストを迅速に収集します。そして、得られた情報をもとに、後続の回答処理を自社内のオープンモデルで即座に完結させるか、外部のフロンティアモデルに委任すべきかを知的判断します。
3. オープン小規模モデルによるワンショット高速レスポンス
例えば「在宅勤務用機器の経費精算ルールは何か」というような、社内ナレッジベースから一意の事実を検索すれば足るシンプルな問い合わせの場合、Waldoはコンテキストを整えた上でローカルまたはオープンな小規模パラメータモデル(Open Low Parameter Model)へ処理を送ります。モデルは即座にWeb検索や社内規定を参照し、「上限500ドルまで」「請求書提出は開始後90日以内」といった具体的回答を「ワンショット(1回のやり取り)」で生成します。無駄な中間推論ステップを省くことで、ユーザーへの応答速度を劇的に高速化しています。
4. フロンティアモデルを活用した高度な多段階推論とデータ分析
一方、「最新のAutomotive顧客案件の不具合状況を報告せよ」といった多角的な情報集約と推論が求められる複雑な問い合わせでは、Waldoは収集したコンテキストと共に処理を「Frontier High Parameter Model(高パラメータフロンティアモデル)」に引き継ぎます。フロンティアモデルは、ナレッジベース、計算ツール、さらにはデータ分析や計画作成を専門とするサブエージェント(Sub-Agents)を呼び出し、複数ステップにわたる推論を実行します。事前に入力コンテキストが整理されているため、テーマ別の分析、根拠の提示、セグメント別の問題分解を含んだ構造化レポートを極めて効率的に出力可能です。
5. オンプレミスとクラウドを組み合わせたハイブリッドセキュリティ構造
本アーキテクチャでは、データガバナンスとレイテンシの観点からモデルの配置場所を柔軟に変更できます。機密性の高い社内データや顧客の個人情報を扱う一次処理(コンテキスト抽出や基本照会)は、自社環境内(オンプレミス)やローカルモデルで完結させます。そして、匿名化・集約された情報のみを必要に応じて外部クラウド上のフロンティアモデルに送信する運用が可能です。これにより、セキュリティポリシーを遵守しながら、最先端モデルの推論能力を最大限に享受するハイブリッド構成を実現します。
性能・ベンチマーク
動画内で明示された、Gleanにおけるルーティング機能(Waldo)適用時の定量的なパフォーマンス改善効果は以下の通りです。無効化時(Waldo Off)と比較し、精度の低下を一切招くことなく劇的な効率化が達成されています。
評価項目
従来構成(Waldo Off)
ルーティング構成(Waldo On)
パフォーマンス改善率
出典
検索・コンテキスト抽出速度
基準値(1x)
10倍高速
10X Faster
動画内実証デモ(1:34)
応答レイテンシ(遅延)
基準値(100%)
50%短縮
50% Lower Latency
動画内実証デモ(1:34)
消費トークン数(コスト)
基準値(100%)
25%削減
25% Fewer Tokens
動画内実証デモ(1:34)
回答の正確性・クオリティ
高
同等以上(劣化なし)
No reduction in answer quality
動画内実証デモ(1:41)
競合サービスとの比較
NVIDIAとGleanが提示した「System of Models」を、競合するAIエコシステムの動向と比較評価します。(※競合サービスの情報は編集部注に基づきます)
比較項目
NVIDIA & Glean (System of Models)
OpenAI (ChatGPT Enterprise)
Google (Gemini for Workspace)
Anthropic (Claude Enterprise)
アーキテクチャ マルチベンダー・ハイブリッド(オープン+商用)
OpenAI自社モデル統合(GPT-4o, o1等)
Google自社モデル統合(Gemini Ultra/Flash)
Anthropic自社モデル統合(Claude 3.5 Sonnet/Haiku)
ルーティング機能 Nemotronベースの専用モデル「Waldo」が最適化
プラットフォーム側で自動切替(Auto)
処理内容に応じ内部モデルを切替
クライアント側でモデル手動選択
データ主権・配置 ローカル / オンプレミス / クラウドに対応
主にOpenAI専用クラウド
主にGoogle Cloud
主にAWS / GCP / 自社クラウド
企業データ連携 Slack, ServiceNow, Concur等を統合横断
カスタムGPTs / API連携
Google Workspace連携
MCP(Model Context Protocol)による接続
比較分析 :
OpenAIやGoogle、Anthropicが自社モデルファミリー内での最適化(例:軽量モデルFlash/Haikuとフラッグシップモデルの切り替え)を進めるのに対し、NVIDIAとGleanの強みは「ベンダーロックインのないマルチモデル運用」にあります。社内データセキュリティの都合上、オンプレミスでローカルLLMを動かしたい企業にとって、オープンモデルとクラウド上のフロンティアモデルを安全に取り持つNVIDIAのルーティングアプローチは強力な選択肢となります。
料金・提供プラン
動画内で言及された価格設定 : 動画内での具体的な価格・料金プランへの言及はありません。Gleanの提供形態(編集部注) : Gleanは企業向けのSaaSとしてシート単位(月額/年額)サブスクリプションで提供されており、Waldoを含むSystem of Modelsのオーケストレーション機能はエンタープライズ機能の一部として組み込まれています。NVIDIAモデルの提供形態(編集部注) : ルーティングの基盤となった「Nemotron-3 Nano」などのオープンモデルは、NVIDIA NGCカタログやHugging Faceを通じて利用可能であり、NVIDIA NIM(Inference Microservice)を活用することで社内インフラや各種クラウド上にデプロイできます。
日本から使う方法
日本国内の企業およびエンジニアが本アーキテクチャや関連プロダクトを導入・検証する手順は以下の通りです。
Gleanの導入検討 : Gleanの公式サイトからデモ請求を行い、日本国内でのエンタープライズ導入パートナーを通じてライセンスを手配します。Glean自体は日本語インターフェースおよび多言語での社内文書検索に対応しています。NVIDIA NIMおよびオープンモデルの取得 : NVIDIA Developerアカウントを作成し、NVIDIA NGCカタログから「Nemotron-3」シリーズのNIMコンテナをダウンロードします。ローカル環境へのデプロイ : 自社のNVIDIA GPU環境(On-PremiseまたはAWS/GCP/Azure上のGPUインスタンス)にNIMをデプロイし、社内データに基づくファインチューニングを実施します。ルーティングパイプラインの構築 : LangChainやLlamaIndexなどのエージェントフレームワークを用いて、一次処理を行う小規模ローカルモデルと、複雑な推論を行うAPI(ClaudeやGPT-4oなど)を接続するルーティングロジックを実装します。
誰にどう効くのか
エグゼクティブ・経営層へのインパクト
AI投資における最大課題である「API利用コストの肥大化」と「応答遅延による業務効率の低下」を同時に解決します。すべての業務問い合わせを単価の高いフロンティアモデルで処理する愚を避け、8割の定型タスクを軽量なオープンモデルで処理することで、AI運用全体のTCO(総保有コスト)を劇的に削減可能です。
ITエンジニア・開発責任者へのインパクト
AIエージェント構築の設計指針が明確になります。プロンプトエンジニアリングのみで精度を上げようとする限界を打破し、「入力段階で文脈を整えるルーティング用小規模モデル(Waldoのような存在)」を前 processing に置くアーキテクチャを導入することで、システムの安定性とレスポンス速度を向上させられます。
企画・プロダクトマネージャー・現場業務担当者へのインパクト
社内ナレッジの検索体験が根本から変わります。情報検索時のレスポンス待機時間が従来より50%削られ、10倍の速度で目的のデータに到達できるため、日常業務のストレスが削減されます。また、情報漏洩リスクを気にする顧客対応部門にとっても、オンプレミスモデルによる安全なデータ処理は大きな安心材料となります。
まとめ
NVIDIAとGleanが示した「System of Models」は、単一LLMの性能競争から、複数モデルの協調による「システム全体の最適化」へとAIエージェントのトレンドが移行したことを象徴しています。企業がAIエージェントを実用化する際は、自社データを取り扱う軽量なルーティングモデルと、高度な推論を担うフロンティアモデルを組み合わせるアーキテクチャ設計を優先して検討すべきです。
動画のタイムテーブル 0:00 マルチモデルプラットフォームの最新インターフェース 0:03 AIエージェントにおけるモデル多様化の必要性解説 0:20 フロンティアモデルとオープンモデルの役割分担 0:37 Gleanによる「System of Models」の実装事例紹介 0:45 Nemotron-3 Nanoベースの専門モデル「Waldo」の役割 1:05 簡易クエリに対するオープン小規模モデルでの即答デモ 1:15 複雑クエリにおけるフロンティアモデルへの転送と多角分析 1:29 ルーティング導入による検索速度やトークン削減のパフォーマンス評価 1:43 システム・オブ・モデルズがもたらす企業向けAIエージェントの未来 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.6-flash)