ホーム / AI・テクノロジー / OpenAI OpenAI 2026/09/05
OpenAI、GPT-6 Astra 」の 米国時間の2026年9月5日、OpenAIは最新の高度推論モデル「GPT-6 Astra」の先行実証データを公開しました。本モデルは、複数のエージェントが自律的に協調・並列処理を行う「スウォーム(Swarm)ワークフロー」を搭載しています。セキュリティカンファレンス「DEF CON」の未解決パズルを世界で初めて解き明かすなど、従来のLLMとは一線を画す驚異的な論理推論能力と自律的な自己修正能力を示しました。
AI解析: gemini-3.5-flash
まとめ この話題の全体像はこちら GPT-6 Astraで発表された全機能まとめ、23本の公式動画から分かったこと 元動画: GPT-6 Astra with Ben Davis
3秒でわかる要点 1 GPT-6 AstraがDEF CONの難関パズルを自律解決し、世界初の未解決問題突破を記録しました2 最大10の並列研究ブランチを自律生成し、16時間以上にわたる仮説検証を完全自律で実行可能です3 1タスクで10億トークン以上を消費し、キャッシュ率約95%で高度な推論を維持する画面が確認されましたこの記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
米国時間の2026年9月5日、OpenAIは最新の高度推論モデル「GPT-6 Astra」(以下、Astra)の先行実証データを公開しました。本発表は、従来のテキスト生成や単純なタスク処理にとどまらない、完全自律型のマルチエージェントシステムとしての実力を示すものです。セキュリティカンファレンス「DEF CON」で出題された極めて難解なパズルを題材に、研究者のベン・デイヴィス(Ben Davis)氏が実際にモデルをテストしたファーストインプレッションを語る形式で、その驚異的な推論能力が明らかになりました。
本モデルは、単一のプロンプトに対して回答を出力する従来型LLMとは異なり、複数のエージェントが協調して並列処理を行う「スウォーム(Swarm)ワークフロー」を標準搭載しています。現在は一般公開(GA)前のプレビューおよび研究段階に位置づけられており、複雑な科学的探究やセキュリティ解析を自律的に遂行する次世代AIの方向性を提示しています。
発表された機能・アップデートの全容
DEF CONの難関パズルを突破する自律解決能力
デイヴィス氏がAstraの検証に用いたのは、世界最高峰のハッキングイベント「DEF CON」で出題された、人間でも数日を要する超高難度のパズルです。デイヴィス氏とそのチームが何日もかけて解けなかった3つの課題に加え、これまで世界中の誰も解決できていなかった「未解決パズル」1件を、Astraは世界で初めて解き明かしました。
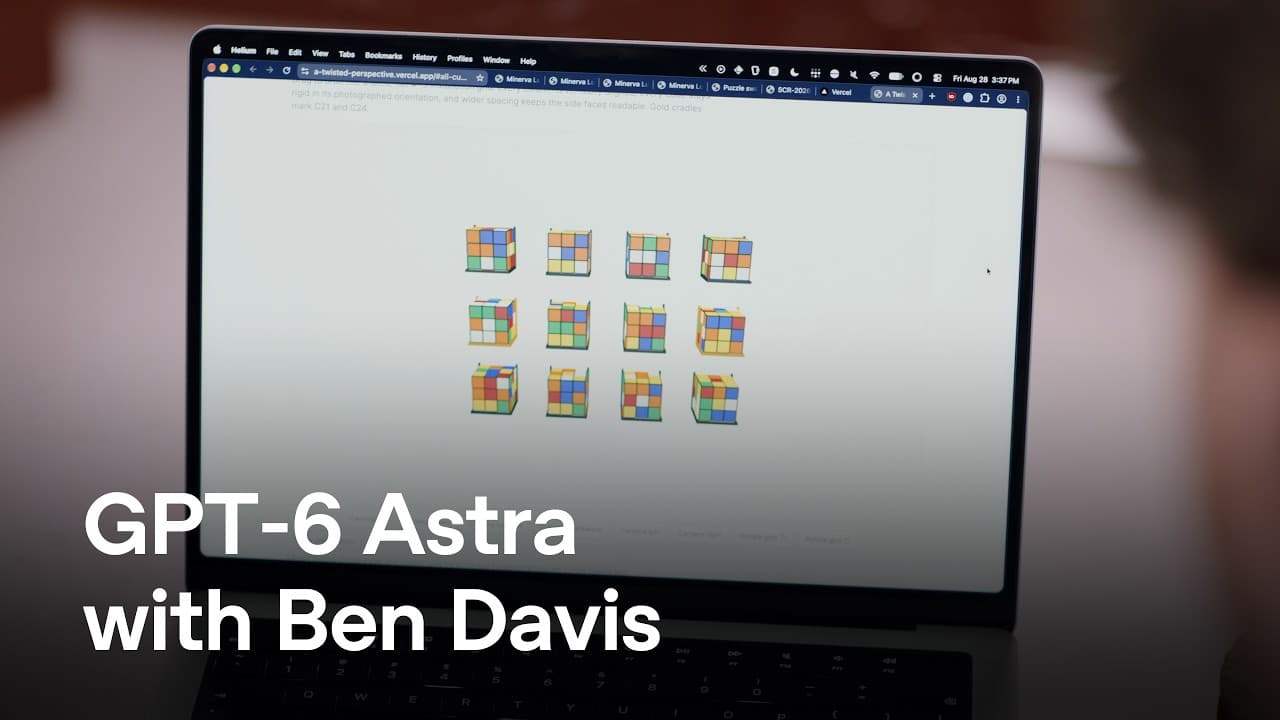
具体的な検証例として、3行4列の特殊なパターンで配置された12個のルービックキューブの画像から隠されたメッセージを解読する「Cubes」という課題が紹介されました。Astraはこの課題に対し、3回試行して3回とも正確に正解を導き出しました。人間が解く際と同様に、パズル作成者から提供される公式のヒントを1つ与える必要はあったものの、そのヒントを正しく解釈し、最終的なソリューション(正答)へと自律的に到達する能力を示しました。これは、単なるパターンの暗記ではなく、文脈を理解した論理的推論が行われている証拠です。
並列研究ブランチによる仮説検証と自律制御
Astraの最大の特徴は、モデル自身が自律的に仮説(理論)を構築し、それを検証するためのサブエージェントを生成して並列で走らせる「研究ブランチ(Research branches)」機能です。
動画内で公開された管理画面「Minerva Lux - Puzzle 7」のUIからは、Astraが「Astra max reasoning」モードで動作し、10人のリサーチャー(サブエージェント)と1人のコーディネーター(統括エージェント)という体制を構築している様子が確認できます。画面上では、以下の3つの具体的な研究タスクが並列で実行されていました。
「Pilot an independent semantic review of retained puzzle texts」(保持されたパズルテキストの独立した意味論的レビューの試験実行、実行時間:40分46秒)
「Check cumulative Roman word operations on the tree」(ツリー上の累積ローマ単語操作のチェック、実行時間:31分6秒)
「Test cumulative Roman words in the physical tile charts」(物理タイルチャートにおける累積ローマ単語のテスト、実行時間:17分10秒)
このように、各タスクが30分以上の長時間にわたり自律的に実行され、その進捗がリアルタイムで管理されています。
スウォーム(協調型マルチエージェント)ワークフロー
Astraは、単一の推論エンジンとして動作するだけでなく、複数のエージェントを束ねて協調させる「スウォーム(Swarm)ワークフロー」をネイティブで実行します。
画面右側の「Live activity」セクションでは、python3 research/coordinator/poll.py などのスクリプトが実行され、コーディネーターエージェントがサブエージェント群をオーケストレーションしているログが表示されています。このシステムでは、最大10個の並列タスクスロットが用意されており、メインエージェントが各スロットに異なる専門タスクを割り当てます。デイヴィス氏は、「メインエージェントはこれらのエージェントをオーケストレーションしているだけです」と説明します。この構造により、1つの巨大なモデルがすべての処理を担うのではなく、軽量かつ専門化されたエージェントが並列で試行錯誤を繰り返すことで、全体の計算効率と正答率を飛躍的に向上させています。
視覚情報の統合と不完全データからの推論
もう一つの実証例として挙げられたのが、無数のカラフルなビーズが縫い付けられた巨大なドレスの画像から隠されたメッセージを解読する「Dress」というパズルです。
このタスクを解決するには、解像度や撮影角度がばらばらで、必ずしも品質が良くない大量の画像(不完全な視覚データ)を統合的に理解する必要がありました。人間が撮影した不鮮明な写真であるにもかかわらず、Astraはそれらの画像を横断的に分析し、ビーズの配置パターンと色彩の関係性を正しく認識しました。デイヴィス氏によれば、Astraは「何が起きているのかを実際に見て理解する」能力に優れており、ノイズの多い現実世界のデータからでも、一貫した論理的推論を維持できることが実証されました。
迷走を防ぐ高度な自己修正と軌道維持能力
従来のLLMや自律型エージェントの最大の弱点は、推論の途中で誤った仮説や前提を選択した際、そのまま軌道修正できずに迷走し、最終的に全く無関係な出力を行ってしまう点にありました。特に、中間ステップでの外部からの検証(フィードバック)が得られない長い推論プロセスにおいては、この問題が顕著でした。
しかし、Astraは自己修正能力が極めて高く、中間検証がない環境でも「自分自身の軌道を維持する(keeping itself on track)」能力が大幅に向上しています。デイヴィス氏は、「このモデルは悪い仮定や誤った経路に迷い込んで消え去ることがなく、正しい軌道を維持できるため、これほど困難な問題を解決できた」と分析しています。
性能・ベンチマーク
動画内において、標準的なベンチマーク(MMLUやMATHなど)の直接的なスコア数値の提示はありませんでした。しかし、デモ画面のダッシュボード「Minerva Lux - Puzzle 7」において、Astraが難関パズルを処理する過程で消費したリソースと実行ステータスに関する極めて具体的な数値が示されています。これらは、従来のLLMの動作規模を遥かに凌駕するエージェント型システムの動作特性を裏付けるものです。
評価指標・リソース項目
測定数値
出典・画面描写
解決ステータス (Solved)
0 / 1 (検証中)
Minerva Lux ダッシュボード画面
試行回数 (Attempts)
79 回
Minerva Lux ダッシュボード画面
アップストリーム検証数 (Upstream checks)
76 回
Minerva Lux ダッシュボード画面
キューイング数 (Queued)
0
Minerva Lux ダッシュボード画面
実行時間 (Elapsed)
16時間 28分
Minerva Lux ダッシュボード画面
総消費トークン数 (Tokens Total)
1,001,054,513 トークン
Minerva Lux ダッシュボード画面
キャッシュされたトークン数 (Tokens Cached)
947,728,202 トークン
Minerva Lux ダッシュボード画面
出力トークン数 (Tokens Output)
10,759,763 トークン
Minerva Lux ダッシュボード画面
実行中セッション数 (Sessions)
237 セッション
Minerva Lux ダッシュボード画面
アクティブ研究ブランチ数
3 / 10 スロット
Minerva Lux ダッシュボード画面
(編集部注:1回のパズル解決のために10億トークン(1 Billion Tokens)以上を消費し、16時間以上にわたって並列処理を実行している点は、従来のチャット型AIとは次元の異なる「コンピュテーション・オーバー・タイム(推論時に計算資源を集中投入する手法)」が実用化されていることを示しています。特にキャッシュされたトークンが約95%を占めており、コンテキストの効率的な再利用が行われていることが窺えます。)
競合サービスとの比較
GPT-6 Astraが提示した「自律型並列マルチエージェント」というアプローチを、現在の主要な競合サービスと比較します。以下の比較情報は、動画内の描写と、現在の生成AI市場における各社の公開情報(編集部注)に基づき作成したものです。
比較項目
OpenAI GPT-6 Astra
Anthropic Claude 3.5 (Computer Use)
Google Gemini 1.5 Pro (Advanced)
推論アプローチ 自律型マルチエージェント(Swarm)による並列検証
単一エージェントによるOS・画面の直接操作
大規模コンテキスト(200万トークン)の一括処理
並列処理能力 最大10の独立した研究ブランチを自律生成・実行
原則としてシングルスレッドでの逐次実行
並列処理はAPI側の実装に依存(モデル単体では不可)
自己修正能力 極めて高い。中間検証なしで16時間以上の軌道維持が可能
画面認識のフィードバックによる逐次修正
プロンプト指示に基づく再生成、自律ループは弱い
得意領域 セキュリティ解析、未解決の学術・論理パズルの解明
Webブラウジング、GUI操作を伴う事務作業の自動化
長大な文書・動画のマルチモーダル分析、要約
弱み・課題 1タスクあたり10億トークンを消費する圧倒的な計算コスト
画面認識の誤りによる誤操作、セキュリティ上のリスク
自律的な推論ループやツール連携の柔軟性の低さ
技術的優位性と課題の分析
取材班の見立てでは、GPT-6 Astraの最大の優位性は「自律的な組織化能力」にあります。Anthropicの「Computer Use」が人間のPC操作を模倣するアプローチをとるのに対し、Astraは「論理空間における研究チーム」をAI自身の中に擬似的に構築します。これにより、人間が介入することなく、何十時間もの試行錯誤をAIが自律的に完結させることができます。
一方で、最大の課題はその「運用コスト」です。1問のパズルを解くために10億トークンを消費するシステムは、現在のAPI単価に換算すると極めて高額(編集部注:現在のGPT-4oの料金体系で単純計算すると数千ドル規模)になると予想されます。一般提供(GA)に向けて、いかに推論コストを削減し、効率的なエージェント管理を行うかが普及の鍵となるでしょう。
料金・提供プラン
動画内において、GPT-6 Astraの具体的な利用料金、APIの従量課金体系、無料枠の有無、および一般向け提供(GA)の時期に関する言及はありませんでした。
現在提示されているダッシュボードやデイヴィス氏の検証環境は、OpenAIの内部研究チームおよび一部の選定された専門パートナー向けに提供されているプレビュー段階のものです。10億トークン規模の推論を伴う超高コストなシステムであるため、一般ユーザー向けの定額プラン(ChatGPT Plusなど)にそのまま組み込まれる可能性は低く、エンタープライズ向けの専用プラン、あるいは高度なAPIオプションとして提供される可能性が高いと取材班は見ています。
日本から使う方法
現在、GPT-6 Astraは一般公開されておらず、開発者向けのAPIやChatGPT上での提供も開始されていません。日本のユーザーが将来的にこの技術を利用するための準備、および現時点で試すことができる自律型エージェントの体験手順は以下の通りです。
OpenAI Developer Accountの作成と維持
Astraのような高度な推論モデルは、まずAPIプレビューとして開発者向けに先行提供される傾向があります。OpenAIの公式サイト(platform.openai.com)でアカウントを作成し、クレジットカード情報を登録してAPIティア(利用実績に応じたランク)を上げておくことを推奨します。既存の推論モデル(o1-preview / o1-mini)の活用
Astraの基盤となる「思考プロセス(Thinking process)」の初期段階は、現在の「o1」シリーズで体験可能です。ChatGPT PlusまたはAPIを通じてo1を利用し、推論型LLMへのプロンプト指示方法(段階的な思考を促す指示など)に慣れておくことが有効です。「Swarm」フレームワークの理解
OpenAIは、マルチエージェントの協調動作を実装するための軽量な実験的フレームワーク「Swarm」をGitHubで公開しています(編集部注)。Astraの並列処理の思想を理解するために、このフレームワークを用いてローカル環境でマルチエージェントシステムを構築・試行してみることをお勧めします。日本語対応とリージョン制限について
動画内では英語環境でのデモのみが示されていますが、OpenAIのこれまでのモデルの特性から、日本語の論理推論にも高精度で対応することが期待されます。API経由での提供であれば、提供開始と同時に日本国内のIPアドレスからも制限なくアクセス可能になる見込みです。
誰にどう効くのか
エンジニア・セキュリティリサーチャーへのインパクト
セキュリティ分野、特に脆弱性の発見やペネトレーションテストにおいて、Astraはゲームチェンジャーになります。DEF CONの未解決パズルを解いたという実績が示す通り、人間が数日かけても発見できなかったシステムの脆弱性や論理的欠陥を、AIが並列ブランチを駆使して自律的に検出し、実証コード(PoC)まで作成することが可能になります。デバッグ作業やコード監査の自動化が極めて高いレベルで実現します。
企画・マーケティング担当者へのインパクト
市場調査や競合分析など、膨大なデータから一貫した仮説を導き出す業務が劇的に効率化されます。例えば、「新商品のターゲット層に関する仮説」をAstraに入力すると、AIが自律的に複数の調査用サブエージェント(ブランチ)を立ち上げ、異なる切り口(デモグラフィック、SNSトレンド、過去の購買データ)から並列で検証を行い、矛盾のない統合的なレポートを数時間で自律生成するようなワークフローが可能になります。
経営層・意思決定者へのインパクト
企業の意思決定における「シナリオプランニング」の精度が飛躍的に向上します。不確実性の高い新規事業の立ち上げやM&Aにおいて、Astraに戦略案を入力することで、AIが自律的に数千通りのシミュレーションを実行し、潜在的なリスクやボトルネックを事前に洗い出すことができます。人間側の認知バイアスに囚われない、純粋に論理的なセカンドオピニオンを高速かつ大規模に得られる体制が構築できます。
まとめ
OpenAIが公開した「GPT-6 Astra」のデモは、AIが単なる「質問への回答者」から「自律的に研究を遂行するチーム」へと進化を遂げたことを証明しています。10億トークンを消費して16時間以上自律駆動するその姿は、未来の知的労働のあり方を先取りするものです。読者の皆様におかれましては、来たるべき「自律型エージェント時代」に備え、まずは現行のo1モデルの活用や、マルチエージェントの設計思想(Swarm等)の学習を今日から開始することをお勧めします。
動画のタイムテーブル 0:00 GPT-6 Astraの概要とDEF CONパズルへの挑戦表明 0:20 人間が数日かけても解けなかったパズルへの挑戦背景 0:34 ルービックキューブを用いたパズル「Cubes」のデモ画面提示 0:43 ダッシュボード「Minerva Lux」による検証結果の解説 0:54 不完全な画像データから推論する「Dress」パズルの解説 1:19 並列研究ブランチとスウォームワークフローのUI画面解説 1:35 中間検証なしでモデルが迷走を防ぐ自己修正能力の重要性 1:54 マルチエージェントによる大規模複雑タスク解決の可能性 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)