Hugging Faceの公式ブログによると、Phononは文章を音声に変える「音声合成(TTS)」のモデルです。ふつうの音声AIは、文章をクラウド(インターネット上の大きなコンピューター)に送って音声を作ります。Phononは、手元の機器の中だけで音声を作ります。入力した文章も手元に残ります。
機器やアプリに読み上げ機能を組み込みたい開発者には、直接関係する発表です。通信が不安定な場所や、文章を外に送りたくない用途にも向いているとされています。クラウドの音声サービスを今どおり使っている人は、この発表で使い方が変わることはありません。
Phononは約65MBと約75MBの2サイズがあります。英語、フランス語、ドイツ語、スペイン語、ポルトガル語の5言語に対応します。内蔵の声は100種類以上です。
電話番号、日付、コードなど、音声合成が読み間違えやすいものも扱えるとしています。スマホ、ノートパソコン、小型のシングルボードコンピューター、ブラウザのタブでも動きます。
声は2通りの方法で増やせます。本人の同意を得た短い録音から声をまねる方法と、「こんな声」と文字で説明して作る方法です。発表では、どちらもGradium Studioで作れるとしています。ただ、録音から声をまねる方法については、当サイトが確認した関連ページで、音声エンコーダーが公開されておらず録音から声をクローンできないとされています。この点は確認が必要です。作った声ファイルをPhononに読み込めば、声も含めて機器の中で動きます。
開発者向けには、Transformers(Hugging Faceの機械学習用ライブラリ)への対応も進んでいます。モデルページによると、2026年10月20日にTransformersへ追加されました(Hugging Faceのモデルページ、11/6確認)。
日本語は未対応、商用で無料なのは31mだけ
ライセンスは2種類に分かれます。小型の「Phonon 31m」は英語だけに対応し、Apache 2.0ライセンスです。商用の製品にも無料で組み込めます。
全5言語に対応する「Phonon 40m」は、非商用のライセンスです。ほかのモデルはCC BY-NCで、非商用の用途だけ無料です。商用で使うと、料金は利用者の数で決まります。音声の生成量では決まりません。
日本語は、対応する5言語に入っていません。Hugging Faceは、日本語・韓国語・アラビア語が必要なら、設計パートナーとして学習できると説明しています。
聞き取りやすさと速さ、ベンチマークで上位
Hugging FaceのベンチマークOpen TTS Leaderboardでも、Phononは評価されました。このランキングでは、Hugging Faceの共有サイトにある9,000を超える音声合成モデルのうち、公開されたものを23言語で比べられます。評価の軸は3つです。
- 聞き取りやすさ(出力された音声の単語の誤り率)
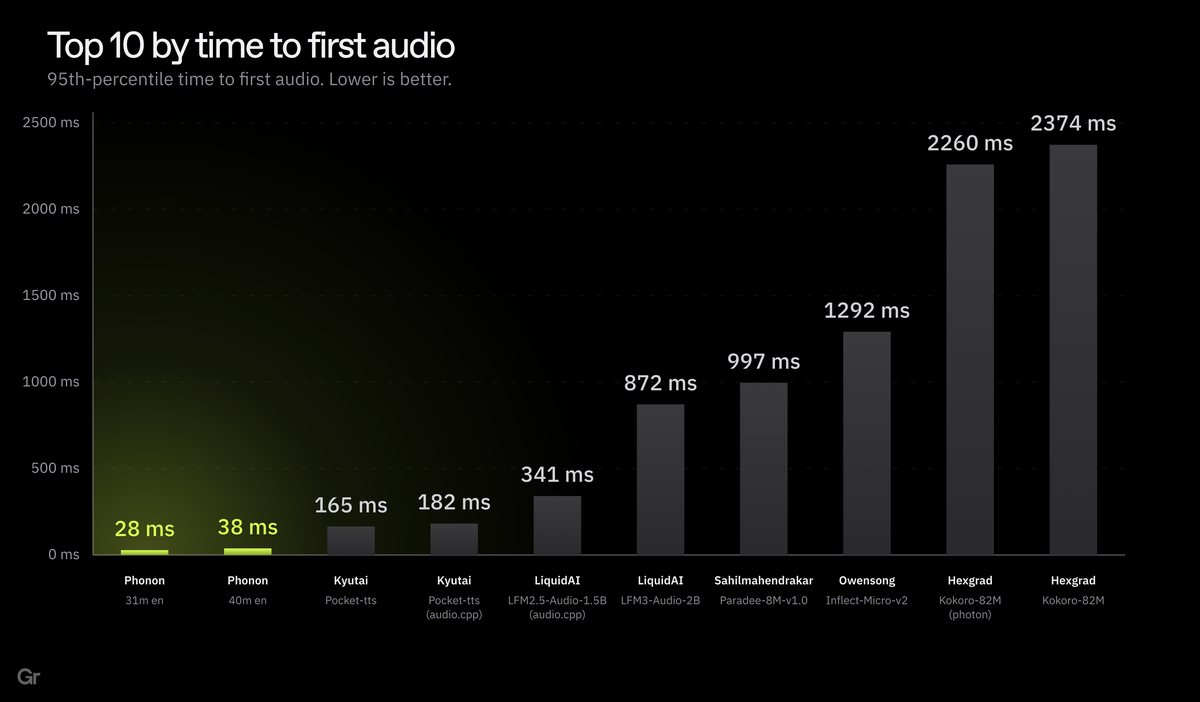
- 速さ(最初の音が出るまでの時間)
- 自然さ(英語はUTMOS、韓国語はKOMOSで採点)
Phononは、聞き取りやすさでドイツ語とスペイン語の1位になりました。どの言語でも上位3位以内で、最大100倍の大きさのモデルと並んでいます。速さでは、CPUで音声を流し始める計測の最初の音の速さでトップでした。
ただし、これはベンチマークの測定条件の中での結果です。どの端末で、どの文章で測ったかによって数字は変わります。編集部の見方では、自分の用途で実際に聞いて比べるのが確実です。
開発者向けには、推論(学習済みのAIが答えを出す処理)を機器で動かす「ptts」という実行環境も作られました。CPU、GPU、NPU(AI処理に特化した部品)の10以上の環境に対応します。
デモも公開されています。Wi-Fiを切ったApple Watchで、コーヒーの淹れ方を手順ごとに読み上げる例があります。電波のないiPhoneで、筋トレの回数を数えて声をかける例もあります。公開から2週間で20万回以上ダウンロードされたとしています。