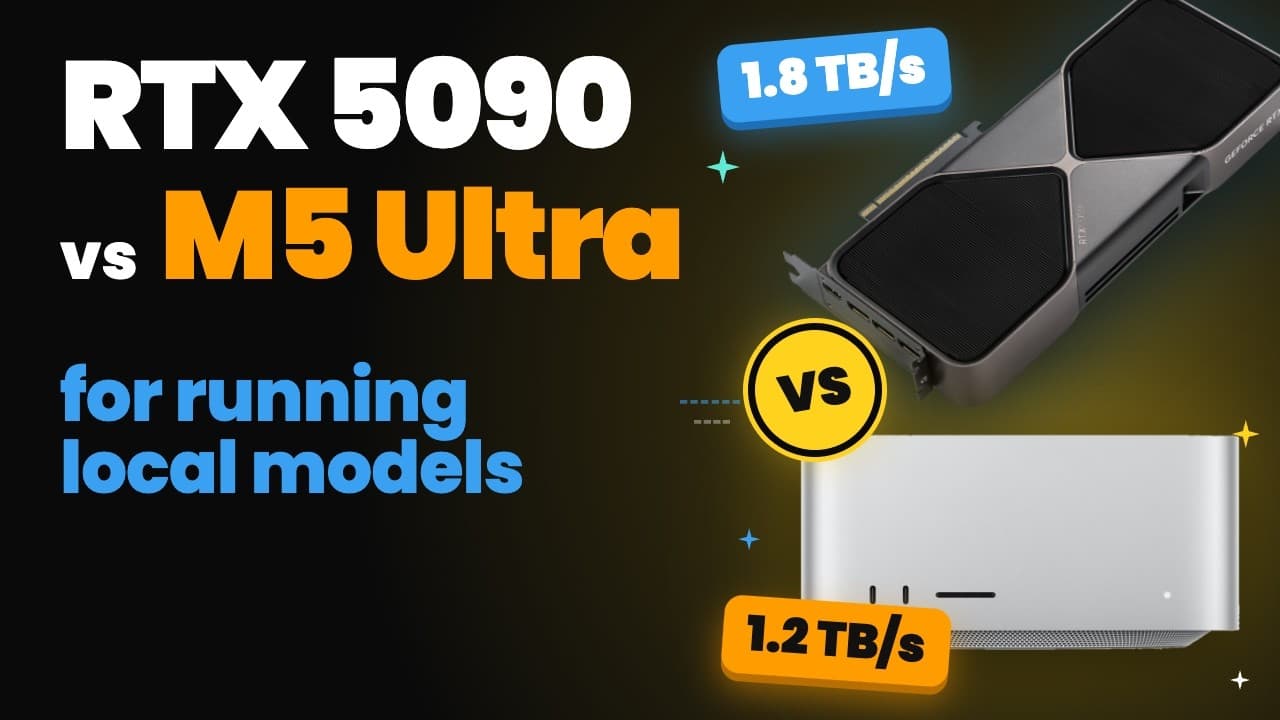
AppleがM5 Ultraを搭載したMac Studioの出荷を開始したことに伴い、Hugging FaceはローカルLLM実行におけるNVIDIAの最高峰GPU「GeForce RTX 5090」との性能比較検証結果を公開しました。同一モデルを用いたベンチマークにより、小規模モデルでの処理速度と大容量メモリを要求する超大型モデルでの実用性という、明確な役割の違いが判明しました。
何が発表されたのか
AppleがM5 Ultraチップを搭載した「Mac Studio」の出荷を開始したことに合わせ、AIモデルプラットフォームを運営するHugging Faceは、ローカル環境における大規模言語モデル(LLM)の実行性能を検証した動画を公開しました。比較対象として選ばれたのは、NVIDIAのデスクトップ向けフラグシップGPUである「GeForce RTX 5090」です。
今回の検証は、研究段階の理論値ではなく、実際に市販されている製品および入手可能なソフトウェアスタックを用いて実施されました。検証では、単なるカタログスペックの提示にとどまらず、同一のAIモデル「Qwen3.8-27B」を動作させた際の実測プロンプト処理速度やトークン生成速度を測定しています。個人開発者や企業の実務担当者がローカルAIワークステーションを構築するにあたり、どちらのハードウェア構成を選択すべきかという課題に対し、客観的なデータに基づく明確な判断材料を提供しています。
発表された機能・アップデートの全容
性能スペックの比較:メモリ帯域幅と浮動小数点演算能力
動画冒頭のスライド「The spec sheet」では、各ハードウェアの基礎スペックが網羅的に比較されています。M5 Ultraのメモリ帯域幅は1,200 GB/sに達し、前世代のM3 Ultra(819 GB/s)から着実な向上を果たしています。一方で、RTX 5090は1,792 GB/sのメモリ帯域幅を誇り、単純な帯域幅の比較ではRTX 5090がM5 Ultraを約49パーセント上回ります。
演算能力(FP16 TFLOPS)においては差がさらに開きます。M5 Ultraの推定演算性能が約110 TFLOPSであるのに対し、RTX 5090は約419 TFLOPSという圧倒的な計算力を示します。ただし、消費電力の面では傾向が逆転します。M5 Ultraを搭載したMac Studio全体でのモデル実行時消費電力が約214 Wに収まるのに対し、RTX 5090単体(グラフィックボードのみ)の消費電力は300 Wから最大575 Wに達します。ワットパフォーマンスの観点では、M5 Ultraの統合型設計の効率性が際立つ結果となっています。
Qwen3.8-27Bでの同一モデル直接対決ベンチマーク
実際のLLM推論処理における性能を測定するため、両環境で「Qwen3.8-27B(4ビット量子化版 Q4_K_M)」を使用し、6,000トークンのコンテキストプロンプトを入力するテストが実施されました。プロンプト処理速度(Prompt processing)において、RTX 5090は毎秒3,031トークンを処理したのに対し、M5 Ultraは毎秒1,701トークンとなりました。
プロンプトを入力してから最初の1トークンが出力されるまでの時間(Time to first token)も測定されています。RTX 5090が2.0秒で処理を開始したのに対し、M5 Ultraは4.0秒を要しました。事前のテキスト読み込みや文脈の解析速度においては、計算資源とメモリ帯域幅で勝るRTX 5090が約2倍の速さを見せる結果となりました。
マルチトークン予測(MTP)有効化時のトークン生成速度
レスポンスの生成速度を示すトークン生成処理(Token generation)の検証では、マルチトークン予測(Multi-token prediction: MTP)機能の有無による違いも可視化されました。MTPが無効な状態(MTP off)では、RTX 5090が毎秒約74トークン、M5 Ultraが毎秒約52トークンを生成します。
MTP機能を有効化(MTP on)すると、両者ともに処理能力が飛躍的に伸びます。RTX 5090は毎秒約136トークンという極めて高速な生成速度を記録し、M5 Ultraも毎秒約100トークンに達しました。動画内では「llama.cpp」やAppleの「MLX」といった推論エンジンの最適化が月単位で進んでいることが注記されており、今後もソフトウェア側のアップデートによって数値が向上する可能性が示唆されています。
32GB VRAMの壁と256GB/512GBユニファイドメモリの容量差
動画中盤の「2x the price, 8x the memory」と題されたセクションでは、グラフィックメモリの容量差がローカルLLMの運用に与える決定的な影響が説明されました。RTX 5090(システム構築費用の目安: 約5,000ドル)が搭載するVRAMは32GBです。これに対し、M5 Ultraを搭載したMac Studio(価格: 約10,799ドル)は現時点で256GBのユニファイドメモリを選択可能であり、将来的には512GB構成の登場も予告されています。
モデルのサイズが32GBを超える場合、RTX 5090ではグラフィックVRAMに入り切らないデータがメインシステムRAMへあふれ出ます(Spill)。この状態に陥ると、システムRAMからのデータ転送がボトルネックとなり、トークン生成速度は毎秒4.6から1.5トークンまで著しく落ち込みます。グラフでは、27BモデルのBF16精度(55GB)、Flash-Next(155GB)、DeepSeek V4(162GB)といった大規模モデルのサイズが示され、これらは32GBのRTX 5090単体では実用的な速度で動作しないことが視覚的に証明されています。
推論速度の計算式と用途に応じた選定基準
結論セクション「The verdict」において、ローカルAIにおける推論速度の基本原理が提示されました。推論速度(tok/s)は、主として「メモリ帯域幅 ÷ モデルサイズ」の公式によって決定されます。
この原則に基づき、ハードウェア選定の基準は極めてシンプルに整理されています。実行したいAIモデルおよび付随するKVキャッシュなどのオーバーヘッドが32GBのVRAM内に収まるのであれば、高い帯域幅と圧倒的な演算能力を持つRTX 5090を選択するのが最適な解となります。一方、非量子化(unquantized)の精密なモデル、巨大なパラメータを持つモデル、あるいはMoE(Mixture of Experts)構成のモデルを外部クラウドに頼らずローカル環境で動かしたい場合は、価格が2倍であっても8倍のメモリ容量を持つM5 Ultraが唯一の実用的な選択肢となります。
性能・ベンチマーク
動画内で公開されたハードウェアスペックおよび「Qwen3.8-27B (Q4_K_M)」を用いた推論ベンチマークの測定結果は以下の通りです。
| 評価項目 |
RTX 5090 |
M5 Ultra |
M3 Ultra(参考) |
出典 |
| メモリ帯域幅 |
1,792 GB/s |
1,200 GB/s |
819 GB/s |
動画内スライド |
| 最大搭載メモリ容量 |
32 GB (VRAM) |
256 GB (最大512 GB) |
512 GB |
動画内スライド |
| FP16 演算性能 |
約419 TFLOPS |
約110 TFLOPS |
約26 TFLOPS |
動画内スライド |
| モデル実行時消費電力 |
300 - 575 W |
約214 W |
< 200 W |
動画内スライド |
| プロンプト処理速度 (6K Prompt) |
3,031 tok/s |
1,701 tok/s |
- |
動画内スライド |
| 最初のトークンまでの時間 |
2.0 秒 |
4.0 秒 |
- |
動画内スライド |
| トークン生成速度 (MTP OFF) |
約74 tok/s |
約52 tok/s |
- |
動画内スライド |
| トークン生成速度 (MTP ON) |
約136 tok/s |
約100 tok/s |
- |
動画内スライド |
| 32GB超過モデルの生成速度 |
1.5 - 4.6 tok/s |
通常速度を維持 |
- |
動画内スライド |
競合サービスとの比較
ローカルLLM環境(RTX 5090 / M5 Ultra)と、大手クラウドAIサービス(OpenAI、Anthropic、Googleなど)との比較を以下に示します(クラウド側の仕様は編集部注に基づく一般的な特徴です)。
| 比較項目 |
ローカル環境(RTX 5090) |
ローカル環境(M5 Ultra) |
クラウドAPI(GPT-4o / Claude 3.5等) |
| 主なターゲットモデル |
8B〜32Bパラメータ以下の量子化モデル |
70B〜数百Bパラメータの大型モデル・MoE |
商用の最先端巨大モデル |
| データプライバシー |
完全ローカル(外部送信なし) |
完全ローカル(外部送信なし) |
運営元の利用規約・プライバシー設定に依存 |
| 初期導入コスト |
約5,000ドル(PC自作/WS) |
約10,799ドル(Mac Studio) |
0ドル(従量課金制) |
| 運用・維持コスト |
電気代(高消費電力) |
電気代(低消費電力) |
トークン数に応じた従量課金 |
| オフライン動作 |
可能 |
可能 |
不可(インターネット必須) |
| 超大型モデルの動作 |
不可(VRAM容量の限界) |
可能(256GB/512GBメモリ) |
クラウド側で完全対応 |
小型〜中型モデルを圧倒的な応答速度でローカル処理したい場合はRTX 5090が優位に立ちます。機密保持が最優先で、超大型モデルや複数のエージェントをローカルで常時並列駆動したいエンタープライズ用途ではM5 Ultraが強力な選択肢となります。初期費用を抑えて最先端モデルの性能を試す段階であれば、従来通りクラウドAPIの利用が適しています。
料金・提供プラン
動画内で提示された各システムの導入コストおよびメモリ仕様の概要は以下の通りです。
- NVIDIA GeForce RTX 5090 搭載システム
- システム全体コスト目安: 約5,000ドル(編集部注: ドライブ、電源、CPU等を含むデスクトップ構成)
- グラフィックメモリ: 32 GB VRAM
- 提供状態: 一般販売中
- Apple Mac Studio (M5 Ultra搭載)
- 本体価格目安: 約10,799ドル(256GBメモリ構成)
- システムメモリ: 256 GB ユニファイドメモリ(標準注文可能)、512 GB 構成(近日登場予定)
- 提供状態: 出荷開始済み
日本から使う方法
日本国内のユーザーがこれらの環境でローカルLLMを試すための一般的な標準手順は以下の通りです。
- ハードウェアの調達
- Apple Store公式オンラインストアまたは取扱店にて、M5 Ultra搭載のMac Studio(256GB以上のメモリ構成を推奨)を注文します。
- RTX 5090の場合は、PCパーツショップ等でグラフィックボード単体または搭載ワークステーションを購入・構築します。
- 推論エンジンのインストール
- Mac環境(M5 Ultra)の場合: ターミナルを開き、Apple Siliconに最適化されたフレームワーク「MLX」または「llama.cpp」をインストールします。
- Windows / Linux環境(RTX 5090)の場合: CUDAドライバを最新化し、CUDAアクセラレーションに対応した「llama.cpp」や「Ollama」をセットアップします。
- モデルファイルのダウンロード
- Hugging Faceの公式リポジトリから、GGUF形式やMLX形式に変換された「Qwen3.8-27B」などのモデル重みファイルをダウンロードします。
- 推論の実行
- コマンドラインまたはローカルWeb UIを起動し、コンテキストサイズやMTP(マルチトークン予測)フラグを指定してモデルを呼び出します。
- 日本語の指示文を入力し、ローカル環境で応答が生成されることを確認します。
誰にどう効くのか
開発者・エンジニア
自社専用モデルファインチューニングや、コード生成AIエージェントの構築において、クラウドの速度制限やAPIコストに悩まされることがなくなります。32B以下の日常的な開発用モデルであればRTX 5090で瞬時にレスポンスを得られ、大規模MoEモデルの実験にはM5 Ultraが威力を発揮します。
企画・マーケティング担当者
未発表の製品情報や顧客の個人情報、社内の機密ドキュメントをAIに読み込ませて分析・テキスト生成を行う際、データを完全に社内ローカル環境に閉じたまま処理できます。情報漏洩リスクを構造的に排除しながら業務効率化を推進できます。
経営層・IT投資責任者
毎月膨らみ続けるクラウドAIサービスの従量課金コストに対し、オンプレミスのAIワークステーション導入による固定資産化という選択肢が生まれます。自社の利用スケールや扱うモデルの大きさに合わせて、RTX 5090(約5,000ドル)かM5 Ultra(約10,000ドル以上)かという明確な基準で投資対効果を試算できます。
まとめ
ローカルLLM環境の選択において、モデルのパラメータサイズとVRAM容量が最大の分かれ目となります。32GBに収まるモデルであればRTX 5090が圧倒的な処理速度を提供し、それを超える超大型モデルの単体実行には大容量ユニファイドメモリを備えたM5 Ultraが不可欠です。まずは自社で運用したいAIモデルのメモリ要求量を算出し、最適なハードウェア構成を選定することをお勧めします。