ホーム / AI・テクノロジー / NVIDIA NVIDIA 2026/08/20
NVIDIA、Vera Rubin 」の NVIDIAは、次世代AIインフラストラクチャプラットフォーム「Vera Rubin」の最新の性能測定データを公開しました。クラウドプロバイダーのCoreWeaveが実機(シリコン)を用いて測定した結果、現行のBlackwell世代と比較して、消費電力1メガワットあたりのトークン生成効率が10倍に向上したことが明らかになりました。本プラットフォームはすでにフル生産の段階に移行しており、AIファクトリーの経済性を劇的に改善する準備が整っています。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: More Tokens per Second per Megawatt: The Economics of NVIDIA Vera Rubin
3秒でわかる要点 1 次世代プラットフォーム「Vera Rubin NVL72」の実機測定で、Blackwell比10倍の電力効率を実証しました。2 新開発の「Vera CPU」は、従来のx86プロセッサと比較してコア単体で最大1.8倍の処理性能を達成しました。3 第6世代NVLinkスイッチの採用により、標準イーサネット比でLLMのデコードスループットが2倍以上に向上しました。この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
NVIDIAのHPC(ハイパフォーマンス・コンピューティング)およびAIインフラストラクチャ担当シニアディレクターであるDion Harris氏は、次世代AIプラットフォーム「Vera Rubin(ヴェラ・ルービン)」の最新アップデートと、実際の半導体チップ(シリコン)を用いた性能測定データを発表しました。今回の発表は、単なるシミュレーションや予測値の提示にとどまらず、AI特化型クラウドプロバイダーであるCoreWeave(コアウィーブ)の実際の稼働環境において測定されたリアルな数値である点が最大の特徴です。
本プラットフォームは、新開発の「Vera CPU」と、次世代GPUである「Rubin GPU」を緊密に統合したシステムです。すでに開発や研究の段階を終え、フル生産(Full Production)のフェーズに移行しています。これにより、ハードウェアからソフトウェア、そしてクラウドインフラに至るエコシステム全体が、市場への本格投入に向けて準備を完了したことが示されました。
発表された機能・アップデートの全容
Vera CPUの性能:x86比で最大1.8倍のコア単体性能
NVIDIAが開発する次世代CPU「Vera」は、従来のx86アーキテクチャを採用するプロセッサと比較して、コアあたりの処理性能を大幅に向上させています。動画内で示された「SPEC CPU 2026(2026年予測値)」のベンチマークデータによると、Vera CPUは、競合となる128コア構成のx86プロセッサ「Turin」(編集部注:AMDの次世代EPYCプロセッサのコードネーム)のシングルスレッド性能と比較して、最大1.8倍の性能を達成しました。
AI処理のワークロードにおいては、GPUの演算性能だけでなく、データのロードや前処理を担うCPUの性能がシステム全体のボトルネックになることが少なくありません。Vera CPUは、特に自律型AIエージェント(Agentic AI)の処理において1.8倍、電子設計自動化(EDA)ツールにおいて1.7倍、データ処理(Data Processing)において1.5倍の性能向上を記録しており、AIワークロードの全般にわたって処理を高速化します。
第6世代NVLinkスイッチによるネットワークの強化:イーサネット比で2倍のデコードスループット
スケールアップネットワークを支える「NVLink 6」を搭載した第6世代のNVLinkファブリックスイッチは、標準的なイーサネット(Off-the-shelf Ethernet)と比較して、LLM(大規模言語モデル)のデコードスループットを2倍以上に引き上げます。GPU1基あたり双方向で毎秒3.6テラバイト(TB/s)という極めて広い帯域幅を提供し、数千から数万基規模のGPUをシームレスに接続します。
動画内のシミュレーションデータでは、210億パラメータのLLMで2.0倍、DeepSeekの「DSR1」で2.1倍、Qwenの230億パラメータモデルで2.3倍のデコードスループット(アクセラレータあたりの1秒間トークン数)を達成しています。さらに、ネットワーク全体の遅延を3分の1に削減し、パケットレートを10倍に高め、スイッチ内部で130 TFLOPSの演算を行う「インネットワークコンピューティング」や、障害発生時に自動復旧する「インテリジェントレジリエンス(回復性)」を備えています。
Vera Rubin NVL72の電力効率:Blackwell比で10倍のTPS/MW
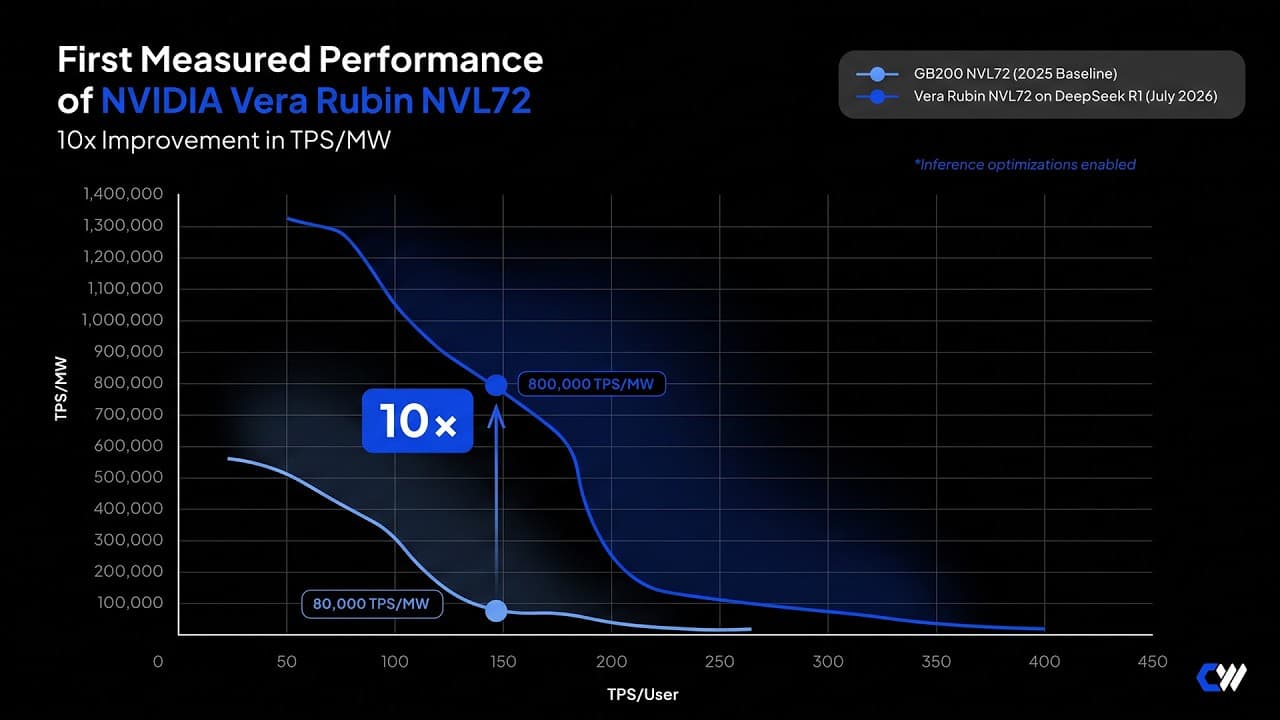
今回の発表で最も顕著な差分として示されたのが、システム全体の圧倒的な電力効率です。次世代の「Vera Rubin NVL72」は、現行のBlackwell世代の「GB200 NVL72(2025年ベースライン)」と比較して、消費電力1メガワット(MW)あたりに生成できる1秒間のトークン数(TPS/MW)が10倍に向上しました。
具体的には、2026年7月を想定したDeepSeek R1(推論最適化を有効化)の実行環境において、GB200 NVL72が80,000 TPS/MWであるのに対し、Vera Rubin NVL72は800,000 TPS/MWに達しています。データセンターの電力供給が世界的なボトルネックとなっている現在、同じ電力枠で10倍のAI推論を実行できるこの効率性は、AIファクトリーの運営コスト(OPEX)を劇的に削減することを意味します。
CoreWeaveでの実機測定:予測値ではない稼働実績
今回の発表における最大のポイントは、これらの数値がシミュレーションや机上の計算値ではなく、AI特化型クラウドプロバイダーであるCoreWeaveのプラットフォーム上で、実際のシリコン(実機チップ)を用いて測定された点です。Dion Harris氏は「予測でも見積もりでもなく、本物のシリコンによる測定値(Not projections, not estimates, but real silicon measurements)」と強調しました。
これはVera Rubinプラットフォームがすでに実用段階に達しており、ハードウェアからソフトウェア、クラウドインフラに至るエコシステム全体が市場投入に向けて完全に稼働していることを証明しています。AIインフラの導入を検討する企業にとって、信頼性の高い実測データが提示されたことは、投資判断を大きく後押しする材料となります。
性能・ベンチマーク
動画内で提示された各ベンチマークの測定条件と結果は以下の通りです。
評価指標・対象ワークロード
比較元(ベースライン)
比較先(Vera Rubin)
改善倍率 / スコア
測定条件・補足
SPEC CPU 2026 シングルスレッド性能 Turin (128C) x86システム
NVIDIA Vera CPU
最大1.8倍 2026年予測値、ロードされたコアあたり
- Agentic AI 処理
Turin (128C)
Vera CPU
1.8倍 同上
- EDA(電子設計自動化)
Turin (128C)
Vera CPU
1.7倍 同上
- データ処理
Turin (128C)
Vera CPU
1.5倍 同上
LLMデコードスループット(NVLink 6) 標準イーサネット
NVLink 6 スイッチ
最大2.3倍 GPUあたり3.6 TB/sの全対全帯域幅
- 21B パラメータモデル
標準イーサネット
NVLink 6 スイッチ
2.0倍 アクセラレータあたりの秒間トークン数
- DeepSeek DSR1
標準イーサネット
NVLink 6 スイッチ
2.1倍 同上
- Qwen 23B
標準イーサネット
NVLink 6 スイッチ
2.3倍 同上
ネットワーク遅延(NVLink 6) 標準イーサネット
NVLink 6 スイッチ
3分の1に削減 3x Lower Latency
パケットレート(NVLink 6) 標準イーサネット
NVLink 6 スイッチ
10倍に向上 10x Higher Packet Rate
電力効率(TPS/MW) GB200 NVL72 (2025)
Vera Rubin NVL72
10倍に向上 DeepSeek R1実行時、推論最適化有効
- GB200 NVL72 スコア
-
-
80,000 TPS/MW 2025年ベースライン
- Vera Rubin NVL72 スコア
-
-
800,000 TPS/MW 2026年7月測定値(CoreWeave上)
競合サービスとの比較
NVIDIA Vera Rubinプラットフォームと、想定される競合半導体メーカーおよびクラウド独自のカスタムASICとの比較分析を行います(以下、競合情報は編集部の知識ベースに基づきます)。
評価項目
NVIDIA Vera Rubin NVL72
AMD Instinct MI350 シリーズ
Google TPU v6e / Custom ASIC
アーキテクチャの統合度 Vera CPUとRubin GPUの超高速密結合。コ・デザインによる最適化。
EPYC CPUとInstinct GPUの組み合わせ。オープンな業界標準に準拠。
Google Cloudに特化したカスタム設計。ホストCPUとの接続はPCIe経由が主流。
インターコネクト(帯域幅) 第6世代NVLinkによる全対全3.6 TB/s。インネットワーク演算対応。
Infinity Fabricによる接続。Ultra Ethernet Consortium(UEC)推進。
TPU 3D Torusトポロジーによる独自ネットワーク。
電力効率(TPS/MW) 極めて高い(800,000 TPS/MW) 。DeepSeek R1などで実証。競合比で高いメモリ帯域を持つが、システム全体の電力効率は未詳。
特定モデル(Gemini等)に最適化されているが、汎用モデルでの効率はNVIDIAに劣る場合あり。
ソフトウェアエコシステム CUDAおよびNVIDIA NIMによる圧倒的なデファクトスタンダード。
ROCmによるオープンソース対応。互換性は向上しているが移行コストあり。
JAX、TensorFlow、PyTorchへの最適化。Google Cloud環境に限定。
導入コスト・ベンダーロックイン 初期投資は極めて高額。NVIDIAエコシステムへのロックインが強い。
比較的安価な選択肢となる可能性。オープンなシステム構成が可能。
クラウドの利用料のみで初期投資は不要だが、他社クラウドへの移行が困難。
取材班の見立て
NVIDIAの強みは、ハードウェアの全レイヤー(CPU、GPU、DPU、スイッチ、トランシーバー、光ケーブル)を自社で設計・統合する「コ・デザイン(共同設計)」にあります。競合他社が個別のチップ性能で追随しようとする中、NVIDIAはシステム全体、さらにはデータセンター規模での最適化を進めることで、競合が容易に真似できない「10倍の電力効率」という圧倒的な差分を生み出しています。
料金・提供プラン
動画内では、Vera Rubinプラットフォームの具体的な販売価格や、クラウドでの提供単価についての直接的な言及はありませんでした。
ただし、スライド内に「July 2026(2026年7月)」というタイムスタンプが明記されていることから、2026年半ばにかけて主要なクラウドプロバイダーで順次インスタンスが提供される見通しです。先行測定を実施したCoreWeaveが最初の提供パートナーになることは確実視されており、初期の利用料金は従来のBlackwell(GB200)搭載インスタンスと同等か、電力効率の向上分を反映した戦略的な価格設定になることが予想されます。
日本から使う方法
日本のユーザーがVera Rubinプラットフォームを導入、またはクラウド経由で利用するための手順は以下の通りです。
CoreWeaveのアカウント開設
今回の実機測定はCoreWeaveのプラットフォーム上で行われました。日本から最速でVera Rubinの演算リソースにアクセスするには、CoreWeaveのクラウドサービスのアカウントを作成し、プレビュー利用の申請を行う必要があります。国内パートナー企業のロードマップ確認
(編集部注)日本国内においては、さくらインターネットやGMOインターネットグループなど、NVIDIAの認定パートナー(NPN)であるデータセンター事業者が、将来的にVera Rubinを国内データセンターへ導入する可能性があります。これらの事業者のプレスリリースやロードマップを注視し、国内リージョンからの低遅延アクセスの提供を待つのが現実的な選択肢です。NVIDIA AI Enterpriseの導入準備
Vera Rubinの圧倒的な性能を引き出すには、ソフトウェアスタックである「NVIDIA AI Enterprise」や「NVIDIA NIM」の活用が不可欠です。既存のHopper(H100/H200)やBlackwell環境でこれらのソフトウェアを用いたパイプラインを構築しておくことで、Vera Rubinへのスムーズな移行が可能になります。
誰にどう効くのか
エンジニア(開発・インフラ)
開発者やインフラエンジニアにとって、Vera CPUのシングルスレッド性能が1.8倍に向上したことは、コンパイル時間の短縮や、データパイプラインの前処理ボトルネックの解消に直結します。また、NVLink 6による2倍以上のデコードスループット向上は、LLMの推論サービングにおける遅延(レイテンシ)を劇的に低下させます。これにより、より複雑なプロンプトエンジニアリングや、リアルタイム性が求められるエージェントAIの構築が容易になります。
企画・マーケティング(ビジネス開発)
ビジネス開発の現場においては、AIサービスのレスポンス速度がユーザー体験(UX)を左右する決定的な要因となります。Vera Rubinがもたらす高速なデコードスループットにより、ユーザーがストレスを感じない超高速なチャットボットや、リアルタイムの音声・映像対話エージェントを企画・展開することが可能になります。また、推論コストの低下に伴い、より安価なサービスプランの設計や、無料枠の拡大といったマーケティング施策を打ち出しやすくなります。
経営層(CIO / CTO / CFO)
データセンターの電気代やファシリティコストの高騰に直面する経営層にとって、「10倍の電力効率(TPS/MW)」は最大の意思決定要因となります。同じ消費電力枠(メガワット)の中で10倍のトークンを生成できるということは、AIサービスの限界利益を10倍に高めることと同義です。AIファクトリーの投資対効果(ROI)を最大化し、競合他社に対して圧倒的なコスト優位性を築くための強力な武器となります。
まとめ
NVIDIAが発表した「Vera Rubin」は、CoreWeaveの実機測定によって、Blackwell世代から10倍という驚異的な電力効率の向上を証明しました。これは単なる理論値ではなく、すでにフル生産体制に入っている現実のハードウェアがもたらす経済的インパクトです。
AIインフラのリーダーや経営層は、今後の設備投資計画において、単にGPUの単体性能を比較するのではなく、「消費電力あたりに生成できるトークン数(TPS/MW)」という新しい経済指標を基準に据えるべきです。まずはCoreWeaveなどの先行プラットフォームでの検証を視野に入れ、次世代インフラへの移行ロードマップを策定することをお勧めします。
動画のタイムテーブル 0:00 NVIDIAのDion Harris氏による挨拶とVera Rubinプラットフォームの概要紹介 0:08 Vera CPUのシングルスレッド性能とx86プロセッサとの比較データの解説 0:18 第6世代NVLinkファブリックスイッチの仕様とイーサネットに対する優位性の提示 0:25 CoreWeaveプラットフォームにおけるVera Rubin NVL72の電力効率(TPS/MW)の測定結果 0:30 実機シリコンによる測定の意義と、フル生産に向けたエコシステムの準備状況の説明 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)