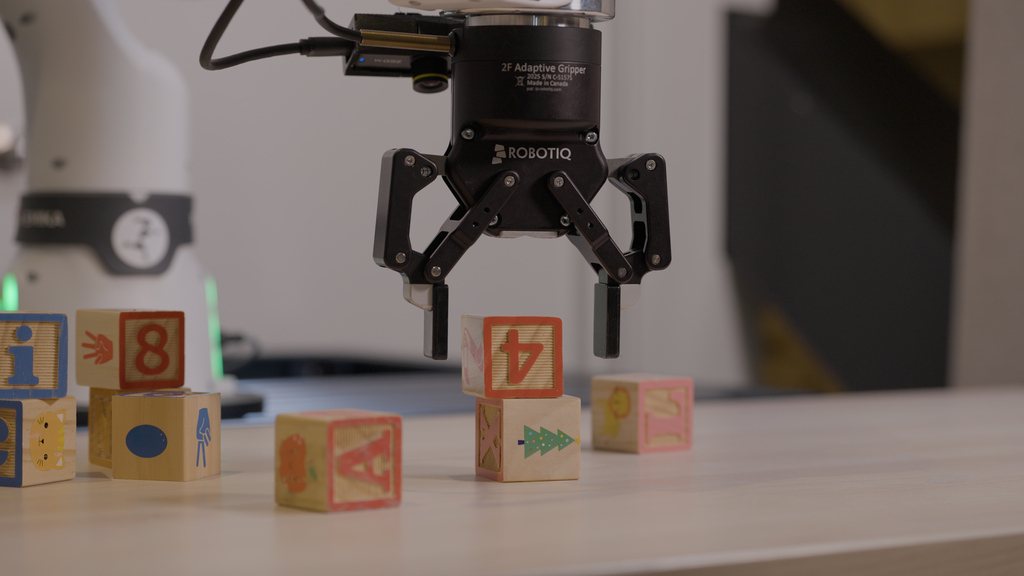
ToyBlocksは、ロボットアームと積み木を机の上に並べた様子を仮想空間に再現した、研究用の学習環境です。ロボットの研究者が、学習の条件を変えても同じ試験を何度でも繰り返せるように作られています。
一般の人の仕事や暮らしに、すぐに変わることはありません。関係するのは、ロボットやAIを開発している人と研究者です。Hugging Faceの公式ブログによると、この環境は米研究所Ai2が公開したものです。
仮想の机の上で、学習データを自動で作る
ロボットに新しい作業を覚えさせるには、人が遠くから操作して、作業の記録を集めることが多くあります。これには時間がかかります。ToyBlocksは、この記録(デモ)を仮想空間の中で自動で作ります。
中心になるのは、押す、ひっくり返す、積むといった短い作業を覚えさせる仕組みです。研究チームは、ものをつかまずに動かす技(非把持)を、強化学習(試行錯誤で行動を覚えさせる方法)で学ばせています。学習には、NVIDIAのオープンソースの学習基盤「Isaac Lab」を使っています。
このとき、ブロックの位置や向きは、カメラ画像から推定せずにシミュレーターから正確な値を直接受け取ります。実際のロボットには得られない情報ですが、これで遠隔操作なしに技を量産できるとしています。
作業の順番と腕の動きを決めるのは、タスクと動作を計画するプランナー(TAMP)です。計画は仮想空間で実行され、どの作業を行ったかのラベル付きの記録になります。ToyBlocksは、この計画を1台のGPU(画像計算用の半導体)で数百本まとめて動かし、実時間の最大24倍の速さでデータを作れるとしています。
研究者は、学習データの量と中身を自分で調整できます。例えば、ひっくり返す作業の練習を増やしたり、積む作業の割合を変えたりできます。ブロックの大きさや机の高さを場面ごとに変えて、動きが変わっても対応できるかを試すこともできます。
評価では、成功率だけを見るわけではありません。動作の速さ、ものにかかった力、作業の進み具合も測れるとしています。どの段階で失敗したかを切り分けやすいのが特徴です。
研究の例として、言葉と画像を受け取ってロボットの動きを出すモデル(VLA)が、新しい配置にどこまで強いかを調べています。試験は、積む、外す、ひっくり返す、回すの4つの作業で行いました。左側の領域だけで学ばせて右側で試すといった、学習時と違う条件で評価します。
結果として、広く使われる動作モデルは、大規模な事前学習をしていても、最初は新しい配置にうまく対応できませんでした。研究チームは改善策を加え、どの工夫がどれだけ効いたかも分析しています。対象にしたのは、ManiFlow、π0.5、MolmoAct 2です。
ほかにも、物の動きを予測する「行動条件付きワールドモデル」を、シミュレーターの代わりに使えるかを試しています。4つの作業で、それぞれ900本の動きの記録を作りました。半分は成功、残りの半分は配置をわずかに変えた失敗です。成功と失敗が半々なので、いつも「成功」と答えるだけのモデルの正答率は50%になります。
上の計画を担う、画像と言葉を理解するモデル(VLM)と、下の動作モデルを組み合わせる試験もあります。「Ai2」の文字を積み木で作る課題では、Molmo 2が次の作業と対象のブロックを選び、ManiFlowが腕を動かします。難しさは3段階で、最も難しいのは文字が最初は見えない場合です。
最新の生成AIは、計画や空間の理解、探索では目立つ力を見せます。一方で、ブロックの面や向きを見誤る知覚の誤りを起こしやすいと、公式ブログの続きの部分で報告されています(Hugging Face公式ブログの続きの部分、11/7確認)。
シミュレーションだけで学んだモデルを、実機に直接載せる試験もあります。Franka FR3というアームとRobotiqのグリッパーを使い、30通りの配置で試しました。
日本の研究者が使えるものと、公開の中身
公開されるのは、次の5つです。
- シミュレーションの素材(ロボットアームとブロックの仮想空間)
- 課題と学習データを自動で作る生成ツール
- 自動で作ったデモデータ
- 学習コード・評価コードと、検証用のデータ
- 学習済みモデル2つ(Molmo 2ベースとManiFlowベース)
データの公開ページでは、学習用データの「easy_train」が約2,760万行とされています(Hugging Faceのデータセットページ、11/7確認)。
Webの画面からClaudeなどの最新AIモデルを接続すると、自然な言葉でロボットに指示を出せます。ロボットの専門知識がなくても試せるとしています。