bycloud
DeepSeek、
DeepSeekが新モデル「DeepSeek-V4.1-Flash」の技術論文とAPIを公開。総パラメータ数5520億でありながら、新規アーキテクチャCEDやCSA2等の導入によりKVキャッシュを従来の4分の1へ圧縮し、100万トークンの長文脈推論コストを飛躍的に抑制しました。
TOPIC
機械学習 に関連するAI・テクノロジーの動画をAIが映像・音声ごと解析し、要点・数字・注意点まで日本語でまとめた記事が7 本あります。
DeepSeekが新モデル「DeepSeek-V4.1-Flash」の技術論文とAPIを公開。総パラメータ数5520億でありながら、新規アーキテクチャCEDやCSA2等の導入によりKVキャッシュを従来の4分の1へ圧縮し、100万トークンの長文脈推論コストを飛躍的に抑制しました。
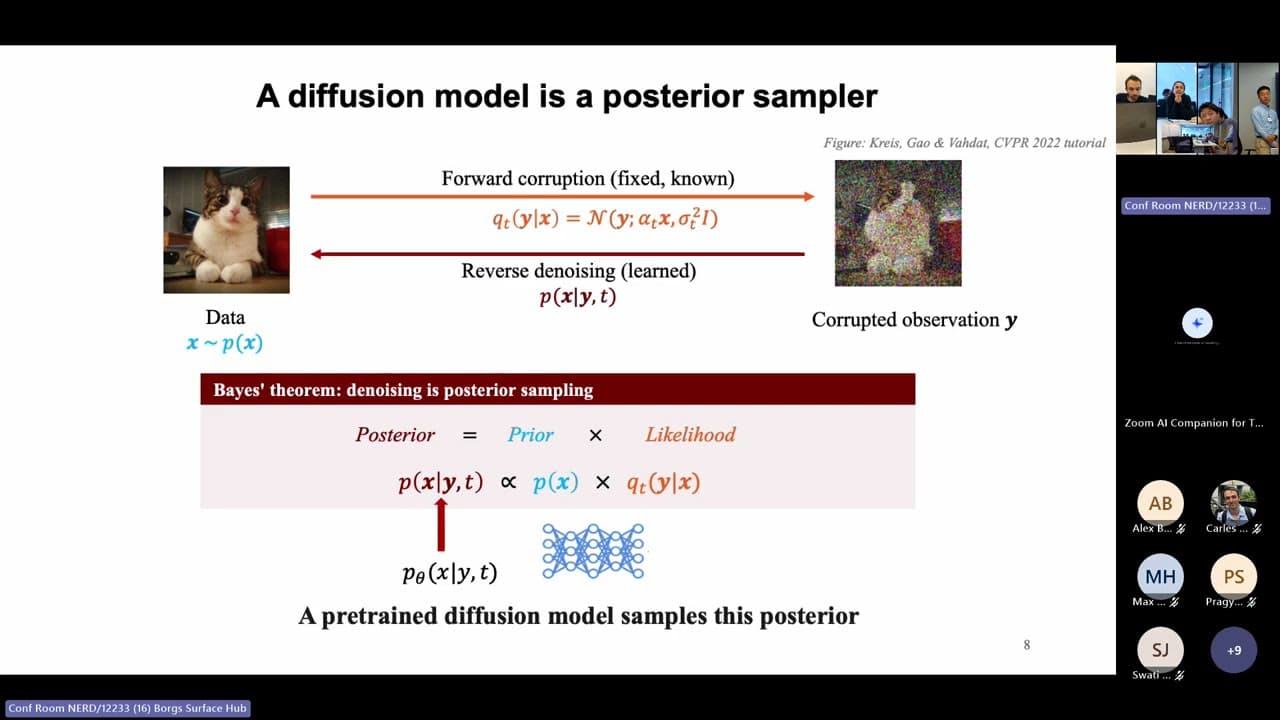
シカゴ大学らの研究チームが物理法則と拡散モデルを推論時に統合する「生成ギブスサンプリング」を発表。事前学習モデルを再学習せず物理コンテキストと結合し、液体水の量子統計サンプリングで従来手法比32倍超の高速化を実証しました。
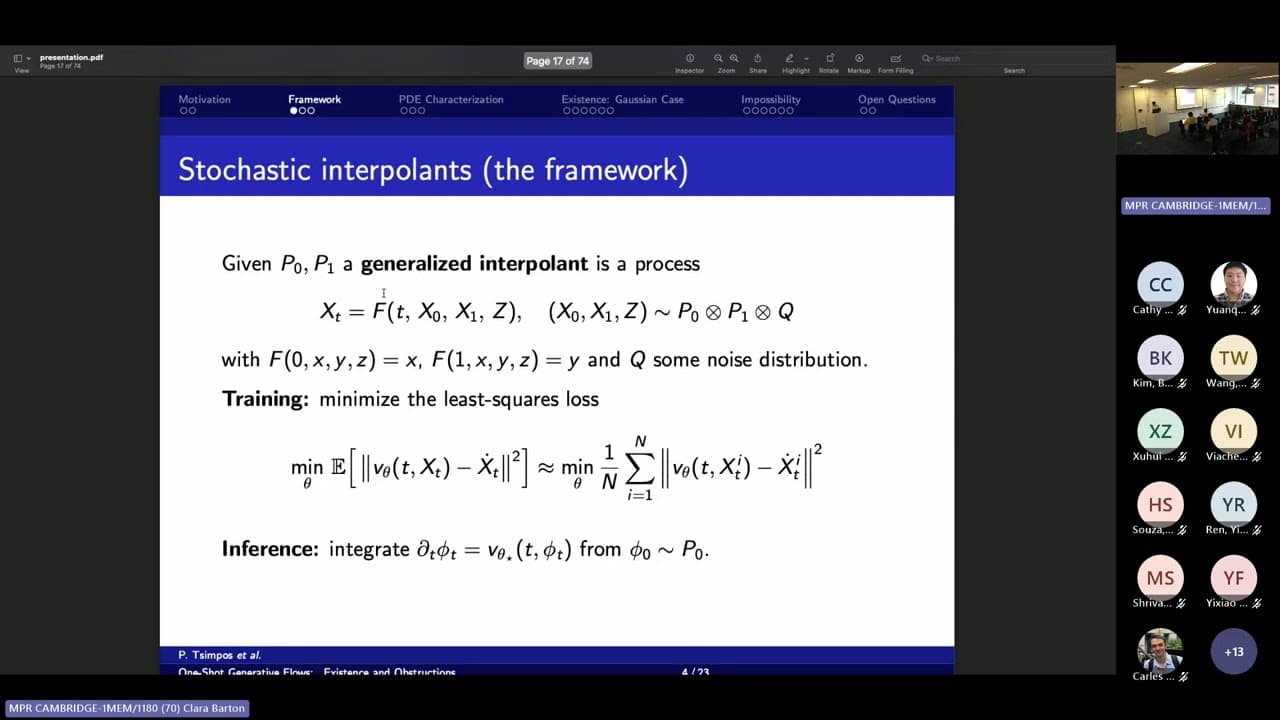
MITとMSRの研究チームが、生成AIのサンプリングを1ステップ化する「直線フロー」の存在条件と数学的限界を発表。ガウス分布での存在証明と多峰性での不可能性定理を解説します。
scikit-learn創設陣によるProbablが、GPUアクセラレーション対応と新開発のML統合ツール「Skore」を発表。NVIDIAとの技術提携により構造化データ処理を高速化し、AIエージェント時代の統計的機械学習基盤を構築します。
米TypeSafe AIが超高速・低価格の意思決定特化型モデル「Jev」を公開しました。文章生成を行わず、構造化データに対する超低遅延な判定処理に絞り込むことで、Web要素の自動削除や動的UI構築、メール優先度判定などを圧倒的なコスト効率で実現します。
米OpenAIが新モデル「GPT-6 Sol」と「GPT-6 Luna」を発表しました。前世代比50%の値下げを行い、100万トークンあたり最安0.10ドルから利用可能です。各種ベンチマーク結果やClaude Opus 5.5との比較を詳しく解説します。
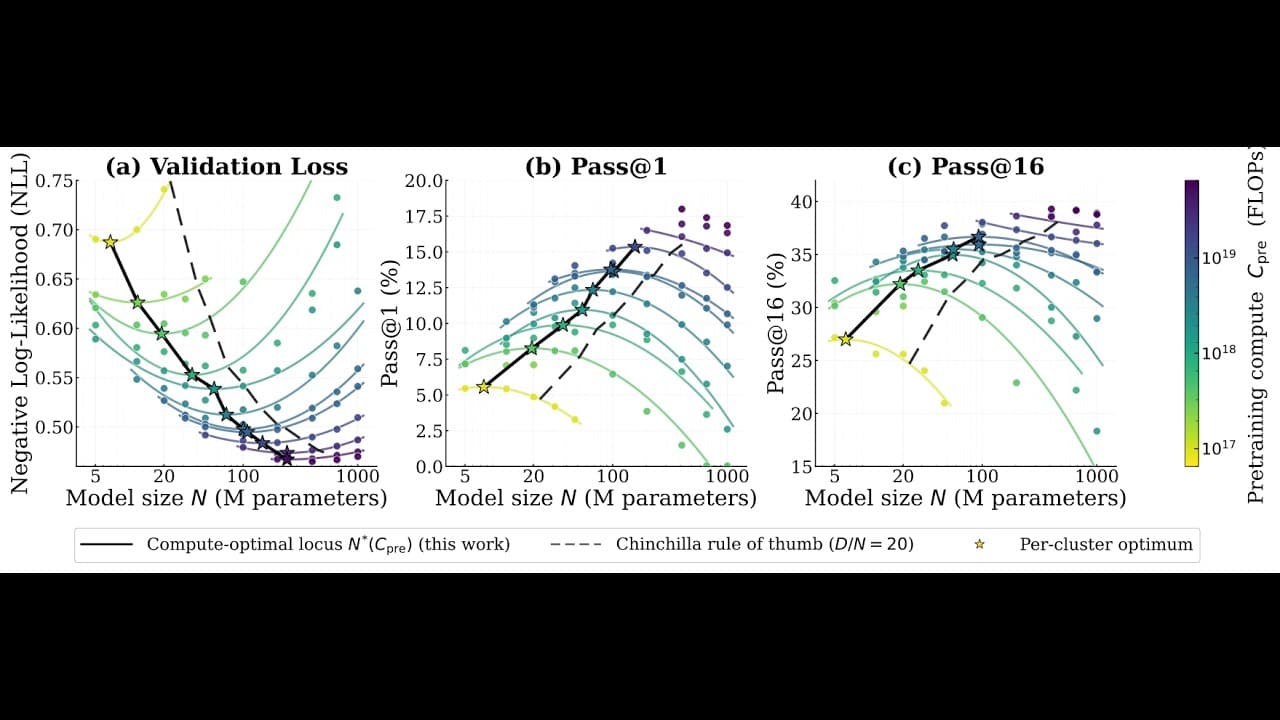
Hugging Faceが解説する最新論文により、強化学習(RL)はLLMに新たな推論能力を授けるのではなく、事前学習で得た潜在能力を「鋭鋭化(引き出し・強化)」するプロセスであることが判明。事前学習とRLの最適な計算資源配分を示す共同スケーリング則を解説します。