公式発表Hugging Face

AIエージェントの長期記憶フレームワーク「Mem0」の内部アーキテクチャを徹底解説

AIエージェントの実用化において、セッションやシステムを跨いでユーザーの情報を記憶し続ける「長期記憶」の重要性が高まっています。本記事では、オープンソースの記憶管理フレームワーク「Mem0(メンバーゼロ)」の内部アーキテクチャについて、3つのデータベース構造、インジェクション(取り込み)パイプライン、そしてセマンティック検索とBM25、エンティティブーストを組み合わせた高度なハイブリッド検索アルゴリズムを徹底的に解説します。

AI解析: gemini-3.5-flash本ページはプロモーションを含みます
まとめこの話題の全体像はこちらAIエージェント実用化の分水嶺:長期記憶「Mem0」、コスト9割減のプロンプトキャッシュ、smolagentsによる自律検証を徹底統合

元動画: Agent Memory EXPLAINED - Complete Architecture

3秒でわかる要点

  1. 1Mem0はメインメモリ、エンティティメモリ、SQLiteの3つのデータベースを併用して高度な長期記憶を実現します
  2. 2インジェクション時はLLMを用いて会話から構造化されたJSON形式で新しい事実のみを自動抽出します
  3. 3検索時はセマンティック検索、BM25、およびリンク数に応じたエンティティブーストを合算してリランキングします

何が発表されたのか

AIエージェントの自律的な動作や、ユーザーに最適化された対話を実現するためには、過去の対話内容やユーザーの好みを永続的に保持する「記憶システム」が不可欠です。本動画では、AIエージェント向けのオープンソース記憶管理フレームワーク「Mem0(メンバーゼロ)」の技術的な内部アーキテクチャが詳細に解説されました。

Mem0は、単なるベクトル検索によるコンテキストの追加にとどまらず、情報のインジェクション(取り込み)、構造化、そして複数のアルゴリズムを組み合わせたハイブリッドな検索(リトリーバル)を統合したシステムです。本発表は、学術的な研究段階ではなく、すでにGitHubで広く公開されており、プロダクション環境での利用を想定した一般提供(GA)レベルの技術解説として位置づけられています。


発表された機能・アップデートの全容

動画内では、プレゼンターの手書きスライドを交えながら、Mem0の設計思想と具体的な処理フローが順を追って説明されました。その主要な機能とアーキテクチャの全容を5つの要素に分けて解説します。

会話記憶と長期記憶の決定的な違い

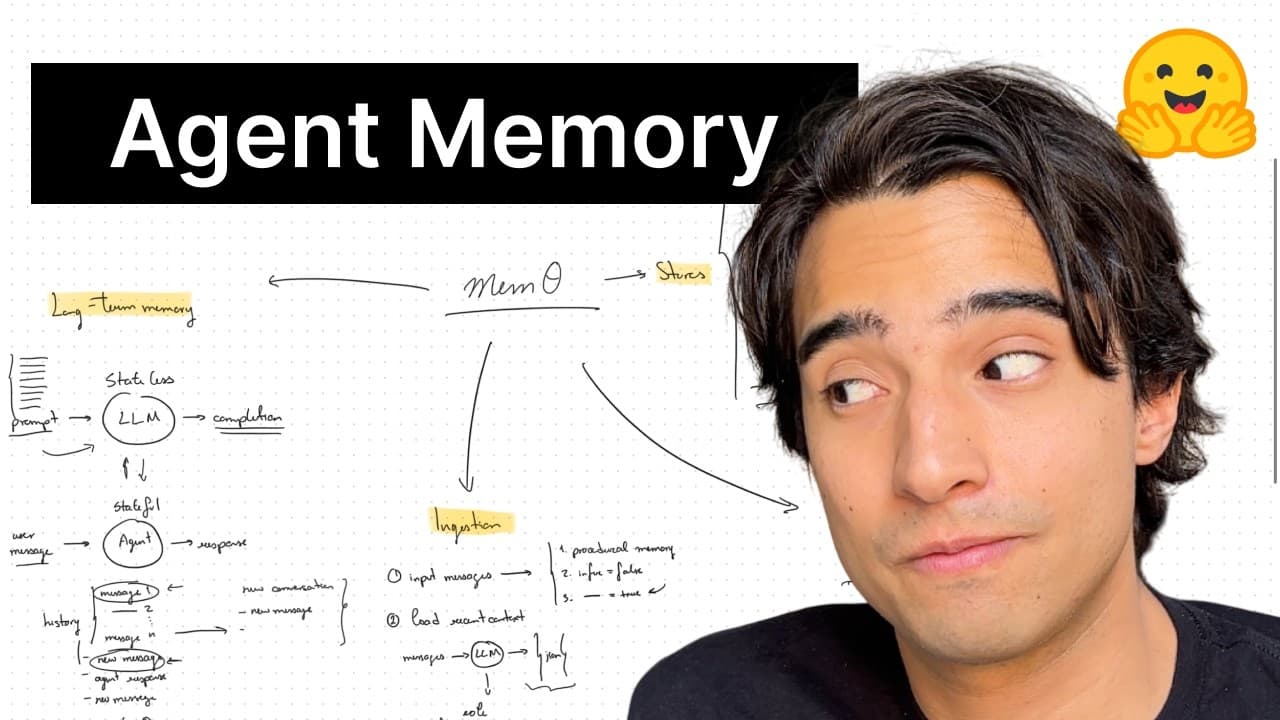
LLM自体は、入力を受け取って出力を生成する「ステートレス」なシステムです。従来のチャットアプリなどでは、会話履歴をすべてプロンプトに含めてLLMに送信する「会話記憶(Conversational Memory)」が用いられてきました。しかし、この方法では新しい会話セッションが開始されると、過去のコンテキストはすべて失われてしまいます。また、履歴が増えるにつれてコンテキストウィンドウを圧迫し、APIコストの増大や処理速度の低下を招きます。

これに対し、Mem0が提供する「長期記憶(Long-term Memory)」は、会話の外部に完全に独立したデータベースとして構築されます。ユーザーが「ヴィーガンレストランを好む」といった事実を対話の中で述べた場合、システムはその事実だけを抽出して永続的に保存します。これにより、セッションを跨いでも、あるいは異なるAIエージェント(ChatGPTやClaudeなど)を利用していても、同じユーザーの好みを共有し続けることが可能になります。

Mem0を構成する3つのデータベース構造

Mem0は、記憶を効率的に管理するために役割の異なる3つのストアを併用しています。動画内では、この多層的なストレージ構成がMem0の強力なハイブリッド検索を支えていることが示されました。

  1. メインメモリ(Main Memory) ベクトルデータベース(Vector DB)として構築され、抽出された記憶のテキスト本体(「ユーザーはヴィーガンレストランを好む」など)と、それに紐づく豊富なメタデータを保存します。メタデータには、記憶の作成・更新日時、ユーザー/エージェントの識別子、重複排除のためのテキストハッシュ、キーワード検索用のレンマ化(原形化)されたテキスト、有効期限、アトリビューション(どのエージェントが書き込んだか)などが含まれます。

  2. エンティティメモリ(Entity Memory) メインメモリとは別のベクトルデータベースとして管理されます。メインメモリから抽出された特定の「エンティティ」(場所、人物、固有名詞など。例:パリ、モンマルトルなど)を個別のベクトルとして保存し、それらがメインメモリのどの記憶とリンクしているかを管理します。このエンティティメモリが、後述する「エンティティブースト」において極めて重要な役割を果たします。

  3. SQLiteデータベース リレーショナルデータベースとして機能し、主に2つの役割を担います。1つは、ベクトルストアに対するすべての変更履歴を記録するロギングシステムです。もう1つは、直近に送信された10件のメッセージ履歴の保持です。この直近履歴は、代名詞(「それ」「彼」など)が指す対象を正しく理解するためのコンテキストとして、インジェクション時に利用されます。

記憶のインジェクション(取り込み)パイプライン

対話から新しい記憶をデータベースに格納する「インジェクション」のフェーズでは、3つの異なるアプローチが用意されています。1つ目はエージェントのアクションを要約する手続き型記憶(Procedural Memory)、2つ目はメッセージを処理せずにそのまま埋め込んで保存する簡易モード(infer = false)、そして3つ目がLLMを用いて構造化された記憶を抽出する高度なモード(infer = true)です。

動画では、最も洗練されたアプローチである infer = true の詳細なフローが解説されました。エージェントのターンが終了すると、以下の情報がコンテキストとしてLLMパイプラインに送られます。

  • ユーザーの基本情報サマリー
  • 新しい入力メッセージ
  • メインメモリから取得した最近の記憶および関連する記憶
  • SQLiteから取得した直近10件の会話履歴
  • 会話の日時および現在の日時

LLMはこれらの膨大なコンテキストを分析し、新しい事実のみを抽出して、構造化されたJSON形式で出力します。例えば、「昨日はヴィーガンピザを食べた。本当に美味しかった」という会話から、「ユーザーはヴィーガンレストランを好む」という明確な事実を抽出し、メインメモリとSQLiteに保存します。このとき、すでに全く同じ記憶が存在する場合はハッシュ値によって重複排除が行われます。

ハイブリッドリトリーバル(検索)と3段階のスコアリングシステム

Mem0の最大の特徴は、検索クエリに対して関連する記憶を呼び出す「リトリーバル」のアルゴリズムにあります。単純なベクトル類似度検索だけでは、文脈的に似ているだけの無関係な記憶を拾ってしまう課題があります。これを解決するため、Mem0は3つのスコアを統合したリランキング処理を行います。

まず、クエリを受け取ると、指定された top-k の4倍(または最低60件)の候補を、メインベクトルDBから近似最近傍探索(ANN)によって抽出します。取得した各候補に対し、以下の3つのスコアを計算します。

  1. ベクトル類似度スコア(Vector Similarity Score) クエリと記憶テキストのベクトル空間におけるコサイン類似度。値の範囲は 0.0 から 1.0 です。

  2. キーワードマッチングスコア(BM25) クエリと記憶の「レンマ化(原形化)されたテキスト」を比較し、単語の重複度を測定します。これにより、固有名詞や特定のキーワードが正確に一致している記憶の優先度を上げます。値の範囲は 0.0 から 1.0 です。

  3. エンティティブースト(Entity Boost) クエリから抽出されたエンティティと、エンティティメモリを照合します。ここで、そのエンティティにリンクされているメモリの数($n_{linked}$)に基づいて重み付けを行います。数式は以下の通りです。

$$W_{memory} = \frac{1}{1 + 0.001 \times (n_{linked} - 1)^2}$$

この仕組みにより、「パリ」のように多くの記憶にリンクされている広範なエンティティよりも、「モンマルトル」のように特定の少数の記憶にしかリンクされていない具体的なエンティティの方が、高いブースト値を得られます。エンティティブーストのスコア範囲は 0.0 から 0.5 です。

最終的に、これら3つのスコア(ベクトル類似度 + BM25 + エンティティブースト)を合算し、最大値である 2.5 で除算することで、0.0 から 1.0 の範囲に正規化された「最終スコア」を算出します。この最終スコアでソートし、上位 top-k 個の記憶のみをエージェントのコンテキストとして返します。

ローカル環境での実行に適したオープンソースLLMの選定

Mem0はデフォルトでOpenAIのAPIなどの商用クローズドモデルを使用しますが、完全にローカルな環境でオープンソースモデルを用いて運用することも可能です。動画では、インジェクションにおけるLLMベースの構造化抽出タスクには、10億(1B)から120億(12B)パラメータ程度の小規模なモデルが適していると説明されました。

具体的には、Metaの「Llama 3」やAlibabaの「Qwen 3(特にQwen3-8B)」などが推奨されています。記憶の抽出タスクは比較的単純な構造化タスクであるため、80億パラメータクラスのモデルであれば、十分な精度を保ちながらローカルマシン上で高速かつ実質無料で実行可能です。

性能・ベンチマーク

動画内において、特定のハードウェア環境における具体的な処理ミリ秒数や、標準データセットを用いたベンチマークスコアの数値の提示はありませんでした。ただし、埋め込みモデルの選定においては、Hugging Face上で公開されている「MTEB(Massive Text Embedding Benchmark)リーダーボード」を参照することが強く推奨されました。MTEBの医療分野や多言語分野など、自社のユースケースに合致したカテゴリで上位にランクインしているモデルを選ぶことが、システムの検索精度を最大化するための鍵となります。


競合サービスとの比較

長期記憶の管理において、Mem0と既存の競合技術・アプローチとの比較を以下の表にまとめます。競合側の情報は、編集部の知識ベースに基づき補足しています。

評価項目 Mem0(本発表) LangChain(会話履歴管理) OpenAI Assistants API
主なアプローチ 独立した永続データベースによる長期記憶管理 メモリコンポーネントによる会話履歴の保持 プラットフォーム側でのスレッドと状態の管理
データベース構成 メイン(Vector)、エンティティ(Vector)、SQLiteの3層構造 基本的に単一のベクトルDBまたはメモリ内バッファ 非公開(OpenAIのクラウドインフラ)
検索アルゴリズム ベクトル類似度 + BM25 + エンティティブースト(ハイブリッド) 基本的なベクトル類似度検索(コサイン類似度など) セマンティック検索 + キーワード検索(詳細非公開)
環境の柔軟性 完全にオープンソース、ローカルモデルで実行可能 オープンソースだが、高度な記憶ロジックは自作が必要 クローズドAPI、OpenAIのクラウドへの依存が必須
エージェント間共有 容易(同一データベースを複数のエージェントで参照可能) 実装次第で可能だが、標準の仕組みは限定的 同一プラットフォーム内でのみ完結

取材班の見立てでは、Mem0の最大の優位性は「オープンソースでありながら、ベクトル類似度だけに頼らない洗練されたリランキングロジックを標準で備えている点」にあります。LangChainなどで同等の仕組みを構築しようとすると、リランキングやエンティティ抽出のロギングを自前で実装する必要があり、開発コストが大幅に上昇します。


料金・提供プラン

Mem0はオープンソースプロジェクトとして公開されており、GitHubからソースコードをクローンして利用する場合、ライセンス費用は一切かかりません。ローカルLLMやローカルのベクトルデータベースを使用すれば、完全無料でシステムを構築・運用できます。

なお、自前でインフラを管理したくない企業向けには、マネージドサービスである「Mem0 Platform」が提供されています(編集部注:具体的なプラットフォームの料金プランや無料枠の詳細は、Mem0の公式ドキュメントを参照してください。動画内では価格に関する直接の言及はありませんでした)。


日本から使う方法

日本の開発者がMem0を今日から試すための具体的な手順は以下の通りです。

  1. Python環境の準備 ターミナルを開き、以下のコマンドを実行してMem0のSDKをインストールします。

    pip install mem0ai
    
  2. ローカル実行用のモデル選定 Hugging Faceの「Feature Extraction」タグから、用途に合った埋め込みモデルをダウンロードします。動画内では、ローカルリトリーバルに適した実用的なモデルとして以下が提示されました。

    • BAAI/bge-m3(多言語対応、高密度・低密度ハイブリッド)
    • intfloat/e5-large-v2(英語検索に強力)
    • nomic-ai/nomic-embed-text-v1.5(長いコンテキストに対応)
    • gte-Qwen2-1.5B-instruct(指示追従型の埋め込み)
  3. コードの実装 公式ドキュメント(https://docs.mem0.ai/)に従い、SDKをインポートして初期化します。日本語の対話メッセージを入力として送信した場合でも、埋め込みモデルが多言語対応(`bge-m3` など)であれば、問題なく日本語の長期記憶として機能します。


誰にどう効くのか

エンジニア(開発現場)

エージェントの記憶維持のために、複雑なベクトルDBの設計やリランキングロジックをゼロから実装する手間が省けます。オープンソースであるため、セキュリティやデータプライバシーの観点から外部APIを使えないオンプレミス環境でも、ローカルLLMと組み合わせて安全に導入できます。

企画・マーケティング(ビジネス創出)

顧客一人ひとりの対話コンテキストをセッションやチャネルを跨いで記憶する、高度な「パーソナライズされたAIアシスタント」を企画・提供できます。過去の会話に基づいた文脈理解により、ユーザー体験とエンゲージメントを劇的に向上させることが可能です。

経営層(意思決定)

自社データや顧客データの流出リスクを抑えつつ、エージェント技術の内製化を推進できます。商用APIの従量課金コストを抑え、ローカルインフラへの移行によるランニングコストの予測可能性とコントロールを確保できます。


まとめ

Mem0は、単なるベクトル検索を超えた3層のデータベース構造と、BM25やエンティティブーストを組み合わせた高度なハイブリッド検索により、実用的なAIエージェントの長期記憶を実現する強力なフレームワークです。まずは手元の環境で pip install mem0ai を実行し、Hugging Faceのオープンソースモデルと組み合わせたローカルでの動作検証から始めてみることを推奨します。

動画のタイムテーブル

  • 0:00イントロダクションと本日のアジェンダ紹介
  • 0:55会話記憶と長期記憶の違い、ステートレスなLLMの課題
  • 3:28複数エージェント間における永続メモリの重要性
  • 4:26Mem0が使用する3つのデータベース(メイン、エンティティ、SQLite)の解説
  • 8:06記憶のインジェクション(取り込み)パイプラインの3つの手法
  • 15:30リトリーバル(検索)のパラメータと埋め込みモデルの選定
  • 19:19BM25とエンティティブーストを用いたハイブリッドリランキングアルゴリズム
  • 25:38ローカルLLMの推奨パラメータとまとめ

記事で紹介したツール

この機能を、いま自分の環境で試す

記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。

公式サイトで試す

提供: OpenAI

この記事に関連するツール・サービス

PR

※ 上記リンクはアフィリエイトリンクを含みます。リンク経由で申し込まれた場合、 当サイトに紹介料が支払われることがあります。価格・提供条件は各公式サイトをご確認ください。

本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.5-flash)