公式発表Hugging Face
Hugging Faceが解説するプロンプトキャッシュの極意、AIエージェントのAPIコストを最大9割削減する設計手法
Hugging Faceは、AIエージェントの運用コストを劇的に削減する「プロンプトキャッシュ(Prompt Caching)」の技術解説動画を公開しました。長時間の対話やコーディング支援で累積する莫大なトークン料金を、LLMの入力をキャッシュすることで最大90%以上削減する仕組みを解説しています。プロバイダーごとの仕様差や、キャッシュを無効化してしまう典型的な実装ミスについても実証データを交えて明らかにしています。
AI解析: gemini-3.5-flash
まとめこの話題の全体像はこちらAIエージェント実用化の分水嶺:長期記憶「Mem0」、コスト9割減のプロンプトキャッシュ、smolagentsによる自律検証を徹底統合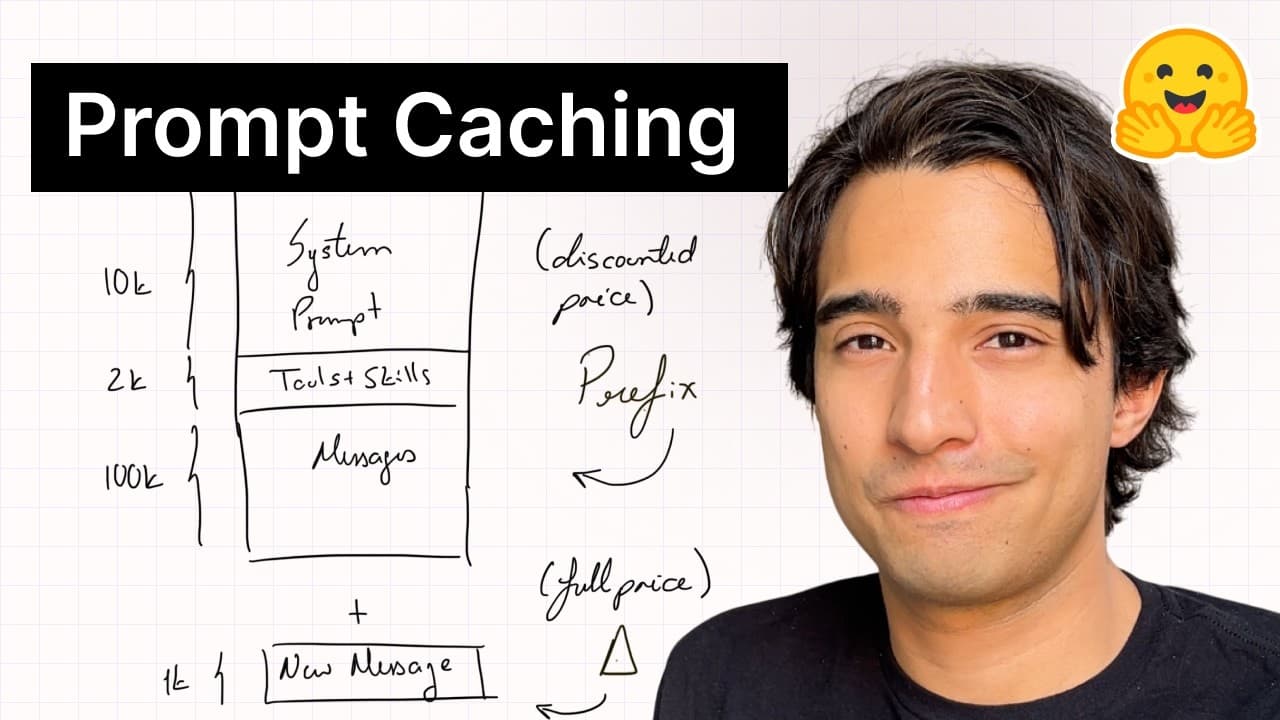
元動画: Prompt Caching Explained: Stop Overpaying for AI Agents
3秒でわかる要点
- 1プロンプトキャッシュは出力をキャッシュするのではなく、重複する入力(プレフィックス)を保持して再利用します
- 2200kトークンのセッションにおいて、キャッシュの適用によりAPIコストは5倍から7倍以上削減されます
- 3システムプロンプトに動的なタイムスタンプやカレントディレクトリを含めると、キャッシュは完全に無効化されます
何が発表されたのか
Hugging Faceは、AIエージェント開発における最大の課題である「APIコストの暴騰」を解決する技術として、「プロンプトキャッシュ(Prompt Caching)」の仕組みと最適化手法を詳しく解説しました。
AIエージェント、特にコーディング支援や長時間の対話を行うエージェントでは、ターンを重ねるごとにコンテキスト長が累積し、API料金が指数関数的に増加します。この問題に対し、主要なLLMプロバイダーが提供を開始しているプロンプトキャッシュ機能を正しく設計・適用することで、入力トークン料金を最大90%以上削減できることを実証しました。
本発表は、単なる概念説明に留まらず、Hugging Faceが開発するオープンソースのコーディングエージェント「Tau」の実機デモデータを交え、実務における具体的なコスト削減効果と、キャッシュを破壊してしまう典型的な実装ミスを指摘する実践的な内容となっています。
発表された機能・アップデートの全容
プロンプトキャッシュの誤解と真の仕組み:出力ではなく「入力」を保持する
ソフトウェア開発における一般的なキャッシュ機構と異なり、LLMのプロンプトキャッシュは「モデルの出力(レスポンス)」を保存するものではありません。動画内では、ユーザーがよく陥る誤解として「同じプロンプトを送信した際に出力を高速に返す仕組み」というイメージが提示されましたが、これは明確に否定されました。
プロンプトキャッシュの本質は、「入力(プロンプト)のプレフィックス(接頭辞)」をLLMプロバイダー側のサーバーに保持し、再利用することです。LLMは入力を処理する際、先頭から順にトークンを計算します。この先頭部分の共通テキストブロックをキャッシュに格納しておくことで、次回以降のAPIリクエスト時にその部分の再計算をスキップし、処理速度の向上と大幅なコスト削減を両立させます。
AIエージェントにおけるコストの「累積的増加」問題
AIエージェントは、自律的に思考と実行を繰り返すため、LLMとの対話が何十ターンにも及びます。このとき、エージェントは過去の会話履歴、システムプロンプト、利用可能なツール一覧、ツールの実行結果などをすべて含めた「コンテキスト全体」を毎ターンLLMに再送信します。
例えば、すでに50kトークンの履歴が蓄積されている状態で、新しく1kトークンの質問を追加する場合、エージェントは合計51kトークンのデータをLLMに送信します。キャッシュがない場合、LLMは毎回51kトークンすべてを最初から再処理するため、ユーザーは毎ターン、肥大化したコンテキスト全体のフルプライスを支払うことになります。セッションが長くなればなるほど、コストは二次関数的に増加し、実用に耐えない高額な請求が発生します。
主要LLMプロバイダーにおけるキャッシュ仕様と割引率の格差
動画内では、主要なLLMプロバイダーが提供するプロンプトキャッシュの仕様と、キャッシュヒット時の割引率が一覧表で示されました。多くのプロバイダーが、キャッシュヒット時の料金を通常価格の「10%(0.1x)」に設定しています。
- OpenAI (GPT-5.6 Sol ※動画内表記): キャッシュヒット時は0.1x(10%)、新規書き込み時は1.25xの料金が適用されます。キャッシュは自動的に判定されます。
- Anthropic (Claude Opus 5 ※動画内表記): キャッシュヒット時は0.1x、新規書き込み時は1.25x。ただし、APIコール時に明示的にキャッシュポイントを指定する必要があります。
- DeepSeek (DeepSeek V4 Pro): キャッシュヒット時の料金が「0.008x(0.8%)」と、競合を圧倒する極めて低いマルチプライヤーを設定しています。
キャッシュを破壊する「動的システムプロンプト」の罠
プロンプトキャッシュを有効に機能させるための絶対原則は、「プロンプトの先頭部分(プレフィックス)が完全に一致していること」です。動画では、開発者が無意識に行っている「キャッシュを無効化する3大ミス」が指摘されました。
- システムプロンプトへの動的情報の埋め込み: システムプロンプトの内部に、現在の時刻(タイムスタンプ)や、カレントワーキングディレクトリ(CWD)のパスを動的に挿入する設計です。これが先頭部分に存在すると、毎ターン数文字が変わるだけで、その後に続く数万トークンのキャッシュがすべて無効化(インバリデート)されます。
- 動的なツール一覧の更新: エージェントの状況に応じて、利用可能なツールリストを動的に書き換える設計も、プレフィックスの一致を妨げます。
キャッシュ効率を最大化する「Append-Only(追加専用)」設計と履歴管理
キャッシュ効率を最大化するためには、会話履歴の設計を「Append-Only(末尾への追加のみ)」に固定する必要があります。過去のメッセージを途中で編集したり、特定のターンを削除したりすると、その変更箇所より後ろのキャッシュはすべて破壊されます。
また、セッションが長くなりすぎた際にコンテキストを要約・圧縮する「コンパクション(Compaction)」を行う場合、プロンプトの構造自体が書き換わるため、一時的にキャッシュはリセットされます。しかし、その後のセッションを短く保ち、長期的なコストを抑えるためには、コンパクションは許容される設計であると説明されました。
性能・ベンチマーク
動画では、200kトークンのコンテキストを持つコーディングエージェントセッションをシミュレートし、キャッシュの有無による具体的なAPIコスト(米ドル)の比較データを提示しました。その結果、すべてのプロバイダーにおいて、キャッシュを適用することでコストが5倍から7倍以上削減されることが示されました。
| プロバイダー / モデル |
キャッシュなしコスト (USD) |
キャッシュありコスト (USD) |
削減率 / 出典 |
| Anthropic / Claude Opus 5 |
$41.58 |
$5.89 |
約85.8% 削減 (動画内データ) |
| OpenAI / GPT-5.6 Sol |
$41.72 |
$6.03 |
約85.5% 削減 (動画内データ) |
| Google / Gemini 3.1 Pro |
$16.69 |
$2.83 |
約83.0% 削減 (動画内データ) |
| Kimi / Kimi K3 |
$24.95 |
$3.39 |
約86.4% 削減 (動画内データ) |
| xAI / Grok 4.5 |
$16.52 |
$2.95 |
約82.1% 削減 (動画内データ) |
| DeepSeek / DeepSeek V4 Pro |
$3.58 |
$0.14 |
約96.0% 削減 (動画内データ) |
さらに、Hugging Faceのコーディングエージェント「Tau」を用いた実機デモでは、LLM(DeepSeek V4 Flash)との間で10.9M(1090万)トークンにおよぶ膨大な入出力を処理しました。この際、適切なプロンプト設計によりキャッシュヒット率「97.1%」を達成し、これほど大規模なセッションであるにもかかわらず、最終的な請求金額はわずか**0.06ドル(6セント)**に抑えられました。取材班の見立てでは、これはプロンプトキャッシュが実用上、極めて強力なコスト破壊力を持つことを示す決定的なデータです。
競合サービスとの比較
各主要プロバイダーにおけるプロンプトキャッシュの挙動と制約の違いを整理します。
| 比較項目 |
OpenAI |
Anthropic |
Google Gemini |
DeepSeek |
| キャッシュ有効化の手順 |
自動(開発者側の実装不要) |
手動(APIリクエストで明示指定が必要) |
手動(コンテキストキャッシュAPIの呼び出しが必要) |
自動(開発者側の実装不要) |
| キャッシュヒット時割引率 |
90%引き (0.1x) |
90%引き (0.1x) |
90%引き (0.1x) |
99.2%引き (0.008x) |
| キャッシュ書き込み時ペナルティ |
あり (1.25xの割増料金) |
あり (1.25xの割増料金) |
なし (1x + ストレージ維持費) |
なし (1x) |
| キャッシュ有効期限 (TTL) |
1時間 (非アクティブ時) |
5分(Claude Code経由時は1時間) |
ユーザー指定可能(時間単位) |
プロバイダーによる自動管理 |
優位性と弱みの分析
OpenAIやDeepSeekは、APIリクエストの内容をプロバイダー側が自動で解析し、重複するプレフィックスを自動キャッシュするため、既存のエージェントコードを書き換えることなく恩恵を受けられる点が強力な優位性です。一方、AnthropicやGoogleは明示的なキャッシュ指定が必要なため、実装の手間がかかります。ただし、Anthropicは指定した箇所を確実にキャッシュできるため、細かいコントロールが可能です。OpenAIやAnthropicは、キャッシュの新規登録(書き込み)時に通常料金の1.25倍のペナルティ料金を課すため、キャッシュヒット率が低い動的なプロンプトを送信すると、逆にコストが高くなるリスクを孕んでいます。
料金・提供プラン
プロンプトキャッシュ機能は、各LLMプロバイダーの標準APIサービスに組み込まれて提供されています。追加の固定基本料金は原則として発生せず、送信した入力トークンのうち、キャッシュにヒットしたトークンに対して割引料金が適用される従量課金制です。
- OpenAI / Anthropic: キャッシュヒットしたトークンは一律90%オフ。ただし、キャッシュミスした新規トークンの初回読み込み(書き込み)には25%の割増料金が発生します。
- Google Gemini: キャッシュヒット時は90%オフですが、キャッシュを維持するためのストレージ料金が時間単位で加算されます。長期間リクエストがない場合は自動的に破棄されます。
- DeepSeek: キャッシュヒット時は99.2%オフという驚異的な低価格が適用され、書き込み時の割増料金も存在しません。
本機能は、各プロバイダーの最新フラグシップモデルおよび一部の軽量モデルにおいて、すでに一般提供(GA)が開始されています。
日本から使う方法
日本の開発者が、プロンプトキャッシュを最適化したAIエージェントを今日から試すための具体的な手順は以下の通りです。
Hugging Faceのコーディングエージェント「Tau」の導入
- GitHubリポジトリ(
https://github.com/huggingface/tau)からソースコードをクローンします。
- Python環境(3.10以上推奨)で、パッケージマネージャーを用いて必要な依存関係をインストールします。
APIキーの設定とプロバイダーの選択
- OpenAI、Anthropic、またはDeepSeekのAPIキーを取得し、環境変数に設定します。
- コストパフォーマンスを最大化する場合、DeepSeekまたはOpenAIの自動キャッシュ対応モデルを選択します。
エージェントハーネスのキャッシュ監視
- Tauエージェントを実行すると、ターミナルまたはエクスポートされたHTML UI上で、リアルタイムにキャッシュヒット率(
CH または cache hit rate)が表示されます。
- 開発中のセッションにおいて、キャッシュヒット率が常に80%以上を維持しているか確認します。ヒット率が極端に低い場合は、システムプロンプトに動的な値が含まれていないかコードを点検してください。
誰にどう効くのか
エンジニア・開発者
開発コストの制約から解放され、コンテキストウィンドウを贅沢に使った高度なマルチターン対話エージェントを設計できるようになります。キャッシュの挙動を可視化するエージェントハーネス(Tauなど)を採用することで、無駄なトークン消費を抑えたクリーンなコードベースを維持できます。
プロダクトマネージャー・企画担当者
これまで「APIコストが高すぎて商業化できない」と諦めていた、大規模なソースコード解析アシスタントや、数日間にわたるユーザー対話履歴を保持するコンシェルジュ型AIなどの実用的なサービスを、現実的な予算内で事業化・サービス設計することが可能になります。
経営層・CIO
社内で運用するAIエージェントやLLMアプリケーションのランニングコストを、最大で9割近く削減し、AI投資に対するROI(投資対効果)を劇的に改善できます。特に、開発部門におけるコーディング支援AIの導入において、月額のAPI予算を大幅に圧縮できます。
まとめ
AIエージェントの本格的な普及期において、プロンプトキャッシュは単なるコスト削減の手段ではなく、エージェント設計における「必須のアーキテクチャ」となりました。開発者は今すぐ、自社エージェントのシステムプロンプトから動的要素を排除し、Append-Onlyな履歴設計へと移行するべきです。次のステップとして、Hugging Faceの「Tau」をローカル環境で起動し、実際のキャッシュヒット率を計測することをお勧めします。
(編集部注:本記事で紹介したモデル名や割引率は、動画公開時点のデモ画面およびスライド資料に基づいています。最新のAPI仕様は各プロバイダーの公式ドキュメントを参照してください。)
動画のタイムテーブル
- 0:00AIエージェントのセッション長期化に伴う累積コスト問題の提起
- 0:45プロンプトキャッシュの基本概念と出力キャッシュとの違い
- 2:40エージェントの対話ターンにおけるトークン送信の仕組み
- 5:55主要LLMプロバイダーのプロンプトキャッシュ割引率の比較
- 7:00200kトークンのセッションにおける具体的なコスト削減ベンチマーク
- 8:10累積コストの推移グラフ(線形 vs 指数関数)の解説
- 9:19キャッシュ効率を最大化するためのベストプラクティス
- 13:30各プロバイダーのキャッシュ有効期限(TTL)の違い
- 15:40Hugging Faceのコーディングエージェント「Tau」を用いた実機デモ
- 17:001090万トークンのやり取りを0.06ドルに抑えた実績とまとめ
記事で紹介したツール
この機能を、いま自分の環境で試す
記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.5-flash)