Googleは、開発者向けYouTubeチャンネルにおいて、生成AI「Gemini」と「Google AI Studio」を活用したユニークな物理デバイス「Journal Receipts」のプロトタイプを公開しました。このデバイスは、ユーザーが話しかけた音声の感情やトーンをGeminiで直接解析し、その内容を象徴するイラストと要約テキストを感熱紙のレシートとして出力する革新的なランプ型IoT機器です。
何が発表されたのか
Googleは、開発者向けのショーケースとして、同社の最高峰AIである「Gemini」および開発プラットフォーム「Google AI Studio」を活用したIoTデバイス「Journal Receipts」のプロトタイプを公開しました。開発者のGayatri Kalra氏が主導したこのプロジェクトは、音声という形のないメディアを、感熱紙のレシートという「触れることができる物理的な成果物」へと変換する試みです。
本プロジェクトは、単なるソフトウェアのアップデートではなく、Geminiの持つ高度なマルチモーダル音声解析能力と、物理的なハードウェア(IoT)を融合させた実用的な開発事例として位置づけられています。現在は研究およびプロトタイプ開発の段階であり、Google AI StudioのAPIおよびSDK(@google/genai)を用いて実装されています。開発者は、既存の技術では困難であった「音声のトーンや感情の直接的な解釈」を、Geminiを用いることで極めてシンプルなコードで実現できることを証明しました。
発表された機能・アップデートの全容
音声から感情・トーンを直接抽出するマルチモーダル解析
動画内で最も注目すべき技術的要素は、Geminiが備える「ネイティブな音声解析能力」です。従来の音声認識システムでは、一度音声をテキストデータに変換(Speech-to-Text)した上で、そのテキストをテキスト解析モデルに入力して感情を推測するという、2段階のプロセスを踏むのが一般的でした。しかし、この方法では音声に含まれる「話し方のペース」「声のピッチ」「ため息や笑い声といった非言語的要素」がすべて脱落してしまいます。
これに対し、本プロジェクトで使用されているGeminiは、音声ファイルをマルチモーダル入力として直接受け取ります。動画内のスライド資料および解説によると、Geminiは音声の「トーン(音色)」「ペース(話す速度)」「エモーショナル・ケイデンス(感情的な抑揚)」を直接分析します。これにより、ユーザーが言葉にしていなくても、声の震えや明るさから「Happy(嬉しい)」「Surprised(驚き)」「Loved(愛されている)」といった感情データを高精度に抽出することができます。この直接的な解析プロセスが、後述するアートワーク生成の極めて重要なインプットとなっています。
物理デバイス「Journal Receipts」のハードウェア構造と動作デモ
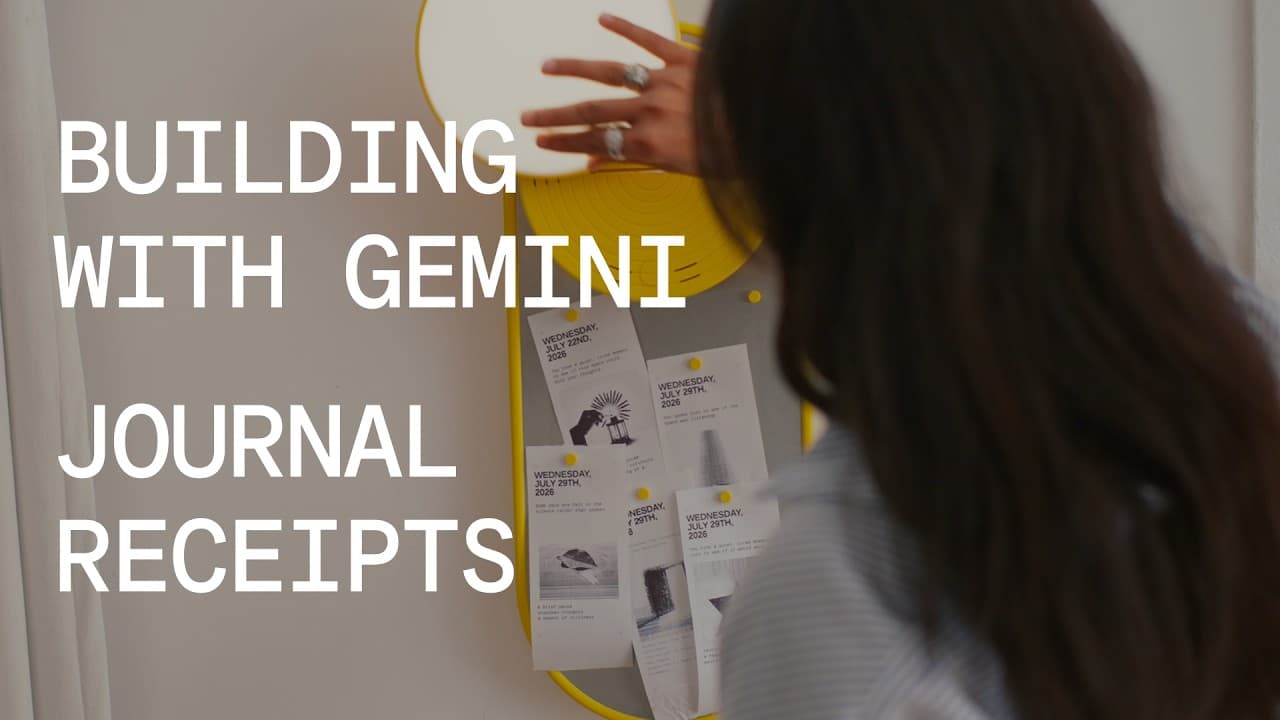
「Journal Receipts」は、壁に取り付けられた黄色い楕円形のモダンなランプのような外観をしています。このデバイスは、単なるインテリアではなく、マイク、マイクロコントローラー、そして感熱紙レシートプリンターを内蔵した自律型のIoT機器です。
Gayatri Kalra氏によるデモ映像では、ランプの上部にある丸いカバーをパカッと開けると、内部にマイクの受音スリットと、レシートの排出口が現れる様子が映し出されています。ユーザーがデバイスの下部にある丸いボタンを押し、ランプに向かってその日の出来事や感じたことを話しかけると、デバイスが音声を録音します。話し終えてボタンを離すと、録音データがAPI経由でGeminiに送信されます。数秒後、ランプの排出口から「ジー」という音とともに、感熱紙のレシートが自動的に送り出されてきます。ユーザーはこれを引きちぎり、ボードに磁石で留めてコレクションすることができます。この「話しかけるだけで、自分の記憶が物理的な紙として手元に残る」というシームレスなユーザー体験が、本デバイスの最大の特長です。
生成AIによるシンボリックなアートワークの自動生成とNano Banana連携
出力されるレシートには、単にテキストが印刷されるだけでなく、その日のムードを象徴するモノクロのイラスト(アートワーク)が印刷されます。この画像生成プロセスは、「Nano Banana」と呼ばれるシステムとの連携によって実現されています。
具体的な処理フローは以下の通りです。まず、Geminiが音声から感情やテーマを抽出します。例えば、動画内のデモ画面に表示されたWebUIのアーカイブでは、「a simple request / thinking of the ocean / a moment of quiet curiosity(シンプルな願い/海を想う/静かな好奇心の瞬間)」といった、詩的な要約テキストが生成されています。このテキストと抽出された感情パラメータがNano Bananaに渡され、それに基づいた象徴的なイラスト(ドット絵や線画調のモノクロ画像)が生成されます。レシートの実物には、日付(例:「THURSDAY / JULY 16th / 2026」)、検出されたトーン(例:「overall tone: Happy / surprised / loved」)、その日の出来事の箇条書き(例:「madison square park, iced coffee, thrifted in bk...」)、そしてセーターや砂時計、光の差し込む扉などを描いた美しいモノクロイラストが印刷されています。
Google AI StudioとTypeScript SDKによる迅速なプロトタイピング
ハードウェアとAIを統合する開発は通常、極めて高い技術的ハードルが存在します。しかし、本プロジェクトでは「Google AI Studio」と、公式のJavaScript/TypeScript用SDK(@google/genai)を利用することで、開発プロセスが劇的に簡略化されています。
動画の0:50付近で公開されたソースコード画面からは、非常にシンプルな実装でこの複雑なパイプラインが構築されていることがわかります。開発者はNode.js環境において、以下のようなコードを用いて音声ファイルを直接Geminiに送信しています。
import { GoogleGenAI } from '@google/genai';
import fs from 'fs';

const ai = new GoogleGenAI({ apiKey: process.env.GEMINI_API_KEY });
const audioData = fs.readFileSync('audio.wav');

async function extractSymbolicSubjectFromAudio() {
  const response = await ai.models.generateContent({
    model: 'gemini-1.5-flash',
    contents: [
      {
        role: 'user',
        parts: [
          { inlineData: { data: audioData.toString('base64'), mimeType: 'audio/wav' } },
          { text: 'Extract the overall emotion, tone, and mood of what I am saying, and generate a symbolic representation.' }
        ]
      }
    ]
  });
  console.log(response.text);
}
このように、音声を文字列に変換する面倒な処理を挟むことなく、数行のコードで「音声ファイルの読み込み」と「Geminiへのマルチモーダル送信」を完結させています。Gayatri Kalra氏は、「Geminiを使用することで、技術的に非常に重いプロセスの最初のハードルを簡単に乗り越えることができた」と語っており、開発プラットフォームとしてのGoogle AI Studioの優秀さを強調しています。
性能・ベンチマーク
動画内において、従来のモデルや競合モデルとの定量的なベンチマークスコア(処理速度や認識精度などの数値)の提示は行われませんでした。しかし、デモ映像から読み取れる定性的なパフォーマンスとして、以下の点が確認できます。
| 評価項目 |
動作状況(動画内での描写) |
出典(動画内 or 編集部注) |
| 音声認識および解析速度 |
ユーザーが話し終えてから、レシートの印刷が開始されるまで数秒程度(ほぼ遅延を感じさせない速度) |
動画内デモ映像(0:21〜0:24) |
| 音声マルチモーダル処理 |
Speech-to-Textを介さず、ネイティブ音声入力から直接感情(Tone, Pace, Cadence)を抽出 |
動画内スライド(0:49) |
| ハードウェア制御の安定性 |
マイクロコントローラーを介したレシートプリンターのシリアル通信と、APIレスポンスの統合が正常に機能 |
動画内デモ映像(0:43) |
(編集部注:Gemini 1.5 Flashモデルは、軽量かつ高速な処理を特徴としており、このようなリアルタイム性が求められるIoTエッジデバイスとの通信において、極めて適した性能を発揮していると推察されます。)
競合サービスとの比較
今回の「音声直接解析による物理デバイス連携」というアプローチについて、他社の主要な生成AIサービス(OpenAI、Anthropic)の同等機能との比較を行います。(※競合側の情報は編集部の知識ベースに基づきます。)
| 比較項目 |
Google Gemini (本発表) |
OpenAI (GPT-4o / Realtime API) |
Anthropic (Claude 3.5 Sonnet) |
| 音声の直接解析能力 |
極めて高い
音声のピッチやトーン、非言語要素をネイティブに解析可能。 |
高い
Realtime APIにより低遅延な音声対話と感情表現が可能。 |
限定的
現時点では音声入力はテキスト変換を伴うか、限定的な対応。 |
| 開発プラットフォーム |
Google AI Studio
プロトタイピングが容易で、APIキーの取得や管理がシンプル。 |
OpenAI Platform
開発者向けドキュメントが豊富だが、Realtime APIはコストが高い。 |
Anthropic Console
テキストや画像分析は強力だが、音声のリアルタイム処理は未整備。 |
| IoT・エッジ連携の容易さ |
極めて容易
軽量なGemini 1.5 FlashとシンプルなSDKにより、マイコン連携が容易。 |
容易
Websocketを用いた双方向通信が可能だが、実装の難易度はやや高い。 |
普通
テキストベースのAPIを仲介する必要があり、リアルタイムIoTには不向き。 |
| 総合評価(IoTプロトタイプ向け) |
最有力候補
開発の速さとコストパフォーマンスのバランスが良い。 |
高性能だが高コスト
高度な双方向対話には向くが、一方通行の解析にはオーバースペック。 |
今後のアップデート待ち
音声ネイティブ対応の強化が待たれる。 |
取材班の見立てでは、Google Gemini(特にGemini 1.5 Flash)は、音声データのマルチモーダル処理におけるコストパフォーマンスと実装のシンプルさにおいて、競合他社の一歩先を行っています。特に、複雑なWebsocketサーバーを立てることなく、シンプルなHTTPSのPOSTリクエスト(またはSDKのメソッド呼び出し)だけで音声ファイルを丸ごと送信して解析できる手軽さは、ハードウェア開発者にとって大きなアドバンテージです。
料金・提供プラン
動画内では、本プロジェクトで使用されたAPIの具体的な利用料金やプランについての言及はありませんでした。しかし、本プロジェクトの基盤となっている「Google AI Studio」および「Gemini API」の一般的な料金体系(編集部注、2025年現在)は以下の通りです。
- 無料プラン(Free Tier):
- Gemini 1.5 FlashおよびGemini 1.5 Proは、Google AI Studioを通じて一定の制限内(1分あたりのリクエスト数や1日あたりのリクエスト数に上限あり)で無料で利用可能です。プロトタイプの開発や個人プロジェクトであれば、料金を支払うことなくすべての機能を試すことができます。
- 従量課金プラン(Pay-as-you-go):
- 無料枠を超えた場合、または商用利用の場合は、入力・出力トークン数に応じた従量課金が適用されます。Gemini 1.5 Flashは、100万トークンあたり数セントという極めて安価な価格設定がなされており、音声データを頻繁に送信するIoTデバイスでも、極めて低いランニングコストで運用可能です。
日本から使う方法
日本のユーザーが、今日からGemini APIを使って同様の音声解析IoTデバイスを開発するための具体的な手順は以下の通りです。
- Google AI Studioにアクセスする:
- APIキーの発行:
- 画面上の「Create API key」ボタンをクリックし、プロジェクトに関連付けるAPIキーを生成・コピーします。
- 開発環境の準備:
- コードの実装と実行:
- コピーしたAPIキーを環境変数(
GEMINI_API_KEY)に設定し、動画内で紹介されたような音声解析スクリプトを実行します。
- 日本語への対応状況:
- Geminiは日本語の音声認識・解析にも完全に対応しています。プロンプトを「音声の感情や内容を日本語で要約してください」と指定するだけで、日本語の音声を解析して日本語のテキストを出力させることが可能です。
- 注意点:
- 音声ファイルをAPIに送信する際は、サポートされているフォーマット(WAV、MP3、AACなど)かつ、ファイルサイズ制限内に収める必要があります。また、無料枠での利用時はレートリミット(APIの呼び出し頻度制限)に注意してください。
誰にどう効くのか
エンジニア・開発者にとってのインパクト
複雑な音声処理ライブラリや感情分析モデルを個別に組み込む必要がなくなり、Gemini APIを呼び出すだけで「音声のコンテキスト理解」が完結します。これにより、ハードウェアの制御やUI/UXのデザインといった、プロダクトの本質的な開発にリソースを集中させることができます。TypeScript/JavaScriptなどのWeb標準技術でIoT開発のバックエンドを完結できる点も大きなメリットです。
企画・マーケター・デザイナーにとってのインパクト
「画面を見ないユーザー体験(スクリーンレス・インタラクション)」の新しい可能性が広がります。スマートスピーカーのような「声で答える」デバイスだけでなく、今回のランプのように「声が物理的なアートに変わる」といった、エモーショナルで温かみのある新しいプロダクトカテゴリの企画が可能になります。ホテルの客室、店舗のインタラクティブな展示、スマートホーム機器など、応用範囲は無限です。
経営層・新規事業責任者にとってのインパクト
生成AIを活用したエッジデバイスやスマートプロダクトのプロトタイピング期間を、これまでの数ヶ月から「数日」のレベルへ劇的に短縮できます。低コストで市場の反応を確かめるMVP(実用最小限の製品)を開発し、素早くイノベーションを創出する体制を構築できます。
まとめ
Googleが公開した「Journal Receipts」は、Geminiのマルチモーダル能力が、画面の中のチャットボットを超えて「物理世界」へと溶け出す未来を提示しました。音声から直接感情を読み取り、それを形のあるレシートとして出力するという体験は、AIと人間の新しい関係性を示唆しています。開発者の皆様は、ぜひ今日からGoogle AI StudioでAPIキーを取得し、身の回りにある物理デバイスとGeminiを繋ぐ一歩を踏み出してみてはいかがでしょうか。