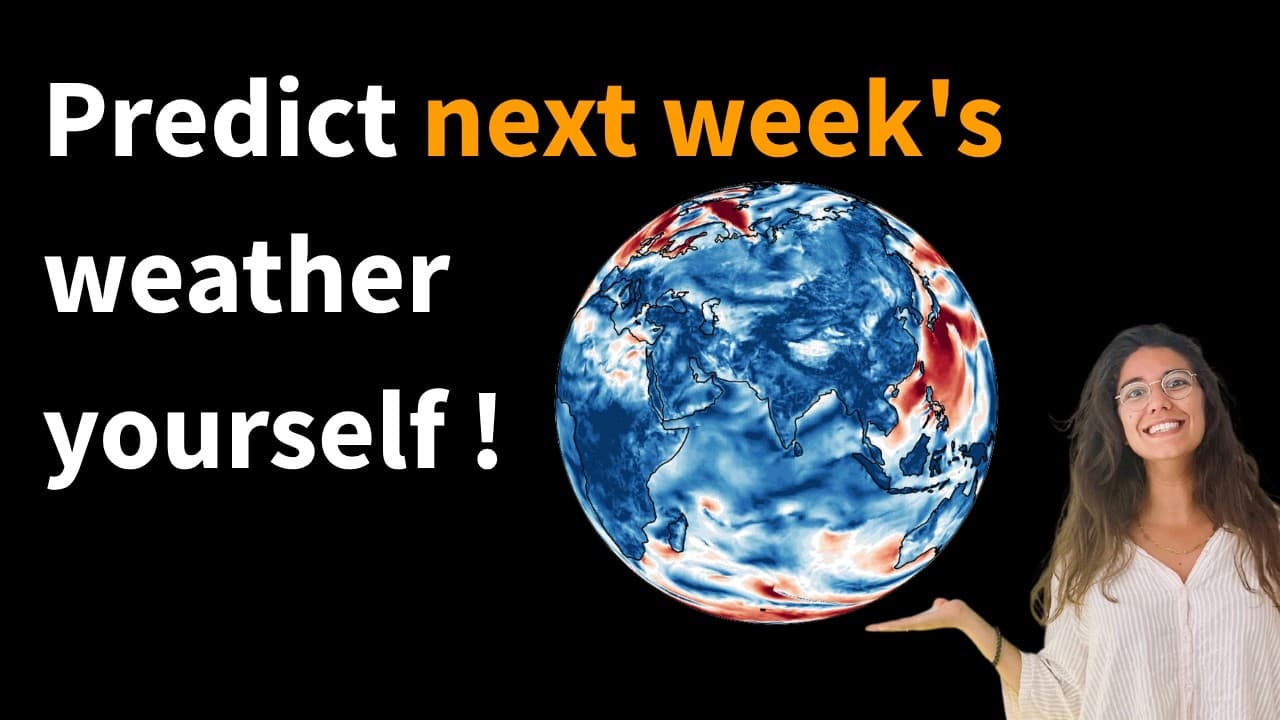
Hugging Faceは、オープンソースのAI気象予測モデルを誰でも簡単に実行・評価できる新しいエコシステムを構築したと発表しました。データプラットフォーム「Earthmover」との連携により、テラバイト級の気象データをローカル環境にダウンロードすることなく、必要なデータだけをオンデマンドで部分取得してシミュレーションを実行できます。Microsoftが開発した13億パラメータの地球システム基盤モデル「Aurora」をJupyter Notebook上で動作させるデモも公開され、従来の物理モデルと比較して計算時間を大幅に削減できることが実証されました。
何が発表されたのか
Hugging Faceは、オープンソースのAI気象予測モデルを容易に実行・評価・共有するための新しい統合エコシステムを発表しました。本発表は、従来の物理方程式に基づく気象予測から、ニューラルネットワークを用いたデータ駆動型の予測モデルへの移行を強力に支援するものです。
具体的には、科学データ向けクラウドプラットフォームを提供する「Earthmover Data」と緊密に連携し、ヨーロッパ中期予報センター(ECMWF)の高品質な気象再解析データ「ERA5」などの初期条件データを、必要な箇所だけオンデマンドで部分取得(ストリーミング)できる仕組みを構築しました。これにより、テラバイト級のデータをローカル環境にダウンロードする手間を完全に排除しています。
さらに、Microsoftが開発した13億パラメータの地球システム基盤モデル「Aurora」を、Hugging Faceのクラウドコンピュート環境「Hugging Face Jobs」およびオブジェクトストレージ「Hugging Face Buckets」を用いて、数行のPythonコードだけで実行・保存するワークフローが実証されました。本機能はすでに一般提供(GA)されており、開発者や気候科学の研究者はすぐに試すことができます。
発表された機能・アップデートの全容
物理ベースモデルからAIベース気象予測へのパラダイムシフト
気象予測の分野において、2018年以前は物理方程式(流体力学や熱力学の支配方程式)に基づく数値予報モデルが主流でした。物理モデルは極めて高い精度を持つ一方で、実行には気象機関が保有するスーパーコンピュータなどの膨大な計算資源が必要でした。さらに、膨大な電力消費と計算時間を要するため、個々の研究者が手軽に実験を行うことは困難でした。
これに対し、近年登場したニューラルネットワークに基づくAI気象予測モデルは、従来の物理モデルと比較して計算時間を10分の1に、消費エネルギーを1000分の1に削減することに成功しました。これにより、研究者は手元のローカル環境や一般的なクラウド環境で迅速にシミュレーションを実行し、新しいアイデアの実験や検証を繰り返すことが可能になりました。
気象予測における自己回帰モデルとLLMの技術的類似性
AIベースの気象予測モデルは、技術的なアプローチにおいて大規模言語モデル(LLM)と多くの共通点を持っています。LLMがテキストの文脈から「次のトークン(単語)」を自己回帰的(autoregressive)に予測するのと同様に、気象予測モデルは「次の大気の状態」を予測します。
具体的には、特定の時刻における地球全体の大気状態(気温、風速、湿度、気圧など)を入力として受け取り、6時間後の大気状態を予測して出力します。さらに先の未来、例えば1週間後や2週間後の天気を予測する場合には、モデルが出力した予測結果を再び次のステップの入力としてフィードバックするループを繰り返します。この自己回帰的なプロセスにより、中長期的な気象シミュレーションが可能になります。
Earthmoverとの連携による科学データの効率的なオンデマンド取得
気象シミュレーションを実行する上での最大の課題の一つは、入力となる初期値データの膨大さです。地球全体の大気データを高解像度で保持すると、テラバイト級のファイルサイズになります。これを研究者が個々にダウンロードしてローカルマシンで処理することは現実的ではありません。
この課題を解決するため、Hugging Faceはデータプラットフォーム「Earthmover」と連携しました。Earthmoverは、クラウドストレージ上に構築された科学データ向けの効率的なデータ管理レイヤーを提供します。多次元配列データを効率的に扱う「Zarr」フォーマットを採用することで、ユーザーは必要な変数(例:2メートル気温、10メートル風速など)や特定の領域のデータだけを、クラウドからオンデマンドで部分的にストリーミング取得できます。これにより、ローカル環境のメモリ消費量を数ギガバイト程度に抑えつつ、高速なデータロードが可能になりました。
Microsoft Aurora(1.3Bパラメータ)をHugging Face Jobsで動かすデモ
動画内では、Microsoftが開発した1.3B(13億)パラメータを持つ地球システム向けの基盤モデル「Aurora」を実際に動作させるデモが披露されました。Jupyter Notebook上で、Earthmoverから取得したERA5再解析データを初期条件としてロードし、Auroraモデルに入力して24時間後(6時間×4ステップ)の気象予測を行うプロセスが実演されました。
このデモでは、実行デバイスによるパフォーマンスの差が明確に示されました。GPU(NVIDIA CUDA環境)を使用した場合、1ステップ(6時間分の予測)の計算は1秒未満で完了します。一方、CPU環境で実行した場合は、1ステップあたり約100秒(約1分半)の時間を要します。Apple Silicon(Mシリーズチップ)には現時点でAuroraが対応していないため、実務においてはCUDA対応のGPU環境、またはHugging Faceが提供するクラウドコンピュート資源「Hugging Face Jobs」の利用が推奨されます。
アンサンブル予測による大気の不確実性の可視化
大気はカオス理論における「バタフライ効果」に代表されるように、初期条件の極めて微小な違いが将来の予測結果に巨大な差をもたらす性質を持っています。そのため、単一の決定論的(deterministic)な予測だけでは、予測の信頼性を十分に評価できません。
これに対応するため、動画では「アンサンブル予測(Ensemble forecasting)」の実行デモが示されました。これは、初期条件に意図的に微小なノイズを加えた複数のシミュレーション(デモでは10個のメンバー)を並列で実行する手法です。出力された複数の予測結果から、平均値(Ensemble mean)と予測のばらつき(Ensemble spread)を算出します。チューリッヒにおける気温予測のグラフでは、10個の予測ラインが実際の観測データ(Ground Truth)の推移を高い精度で包摂している様子が確認され、アンサンブル予測が気象予測の信頼性を向上させる上で不可欠な手法であることが示されました。
性能・ベンチマーク
動画内で提示された、Microsoft Auroraモデルを実行した際のデバイス別推論速度のベンチマーク数値は以下の通りです。測定条件は「1ステップあたり(大気の6時間分の予測に相当)」の処理時間です。
| 実行デバイス |
処理時間(1ステップあたり) |
出典・測定条件 |
| GPU (NVIDIA CUDA) |
1秒未満(less than a second) |
動画内実演(Microsoft Auroraモデル) |
| CPU |
約100秒(around 100 seconds) |
動画内スライドおよび発言(Microsoft Auroraモデル) |
| Apple Silicon (M1/M2/M3) |
実行不可(Not supported) |
動画内発言(Auroraモデルのライブラリ未対応のため) |
取材班の見立てでは、気象予測モデルの学習(Training)には依然として膨大なGPUクラスターが必要であるものの、一度学習されたモデルの推論(Inference)フェーズにおいては、上記の通り一般的なGPU環境があればリアルタイムに近い超高速な予測が可能となっています。
競合サービスとの比較
気象予測分野におけるAIモデルの適用は、大手テック企業の間で激しい開発競争が繰り広げられています。今回のHugging Faceの取り組みおよびAuroraモデルを、競合する主要なAI気象予測モデルと比較します(競合情報は編集部注の知識ベースに基づきます)。
| 項目 |
Hugging Face + Microsoft Aurora |
Google DeepMind (GraphCast) |
NVIDIA (FourCastNet) |
| 開発主体 |
Microsoft(モデル)/ Hugging Face(ツール) |
Google DeepMind |
NVIDIA |
| モデル規模 |
1.3B (13億) パラメータ |
非公開 |
約2.4億パラメータ |
| 特徴 |
地球システム全体の多角的なタスクに対応する基盤モデル |
ヨーロッパ中期予報センターの物理モデルを超える高い予測精度 |
フーリエニューラルオペレータを採用した超高速な推論 |
| データ連携 |
Earthmoverを介したZarr形式の部分ストリーミング取得に対応 |
Google Cloud Storageを介したデータアクセス |
専用のデータローダーを使用 |
| エコシステム |
HF Jobs/Bucketsによる実行・保存の標準化を推進中 |
Google独自のインフラに最適化 |
NVIDIA Modulusプラットフォームに統合 |
Hugging Faceの最大の優位性は、特定のクラウドベンダーやハードウェアに依存せず、オープンソースモデルを標準的なインターフェースで実行・評価できる「ツールチェーンの標準化」を目指している点にあります。
料金・提供プラン
本機能およびデータの利用に関する料金体系は以下の通りです。
- モデルの重み(Weights): 無料(Hugging Face Hubからオープンソースライセンスでダウンロード可能)
- 初期条件データ(Earthmover): 無料プランあり(Earthmoverに無料のアカウントを登録することで、ERA5などの主要なデータセットにアクセス可能)
- コンピュート資源(Hugging Face Jobs): Hugging Faceのプロプランまたはエンタープライズプランに応じたコンピュート料金が適用されます(ローカル環境のGPUで実行する場合は無料)。
日本から使う方法
日本のユーザーが今日からこのAI気象予測環境を試すための具体的な手順は以下の通りです。
- Hugging Faceアカウントの作成: Hugging Faceの公式サイトでアカウントを作成し、APIトークン(HF_TOKEN)を発行します。
- Earthmoverアカウントの作成: Earthmoverのプラットフォームにアクセスし、無料アカウントを登録して「ARRAYLAKE_TOKEN」を取得します。
- ライブラリのインストール: ローカル環境またはクラウド環境(Jupyter Notebookなど)で、必要なパッケージをインストールします。
pip install arraylake xarray microsoft-aurora huggingface_hub matplotlib
- データの取得とモデルの実行: ブログ記事に掲載されている公式コードを参考に、EarthmoverからERA5データをロードし、Hugging Face HubからAuroraの重みをダウンロードして推論を実行します。
- 日本語対応について: コードおよびドキュメントはすべて英語ですが、出力される気象データは数値配列(Xarray形式)であるため、日本国内の任意の座標(緯度・経度)を指定して日本語の可視化グラフを作成することが可能です。
誰にどう効くのか
エンジニア(AI・データサイエンティスト)
テラバイト級の気象データをローカルにダウンロードする手間が省け、Zarr形式での効率的なデータパイプラインを即座に構築できます。また、Hugging Faceの標準的なインターフェースを介して、モデルのファインチューニングや推論コードの記述が容易になります。
企画・マーケティング(エネルギー・農業・流通業界)
超高速かつ低コストで動作する高精度な中期気象予測(最大2週間先)を自社システムに組み込むことができます。需要予測や在庫最適化、防災計画などの意思決定プロセスを、従来の物理シミュレーションを待つことなく、リアルタイムにアップデート可能になります。
経営層
気象予測システムの運用にかかるインフラコスト(スーパーコンピュータの維持費や莫大な電気代)を大幅に削減できます。オープンソースのAIモデルを自社のプライベートなインフラ上で安全に運用できるため、データガバナンスを維持しながらESG経営や持続可能な事業計画を推進できます。
まとめ
Hugging FaceとEarthmoverの連携は、これまで専門の気象機関や巨大テック企業に独占されていた高精度なAI気象予測技術を、一般の研究者や企業に民主化する画期的な一歩です。読者の皆様におかれましては、まずは公開されているJupyter Notebookを動作させ、自社のビジネスに関連する地域の中期予測シミュレーションを試してみることをお勧めします。