何が発表されたのか
マイクロソフト・リサーチ・ニューイングランドが主催した「生成モデリング&サンプリングセミナー」において、ENSAE Parisの博士候補生(2026年11月よりパリ高等師範学校ポストドック研究員)であるニーナ・ヴェスロン(Nina Vesseron)氏が、単一の凸ポテンシャルからサンプリングと最適輸送の双方を実行する新たな生成モデル技術「共役モーメント測度(Conjugate Moment Measures, CMM)の因数分解」に関する論文成果を発表しました。
従来の生成モデリング(GAN、VAE、拡散モデル、フローモデルなど)では、事前分布からのノイズサンプリングと、そのノイズをデータ分布へ変換する輸送マップの学習が独立した2つの手順として扱われてきました。これに対しヴェスロン氏らの研究チームは、2015年に証明されたモーメント測度の因数分解定理に着目しつつ、従来のモーメント測度がそのままでは生成AIに適さない理由を幾何学的に解明しました。その上で、輸送関係をルジャンドル変換によって反転させた新たな共役モーメント測度を定式化し、単一の凸ポテンシャル $w$ のみを用いて事前ノイズのサンプリングとデータ空間への最適輸送を同時に制御する理論的枠組みと実装アルゴリズムを提示しました。本発表は研究段階の理論的・実験的検証であり、論文公開および専門セミナーでの発表という位置づけになります。
発表された機能・アップデートの全容
従来のモーメント測度が生成モデルで抱える分散逆転問題の解明
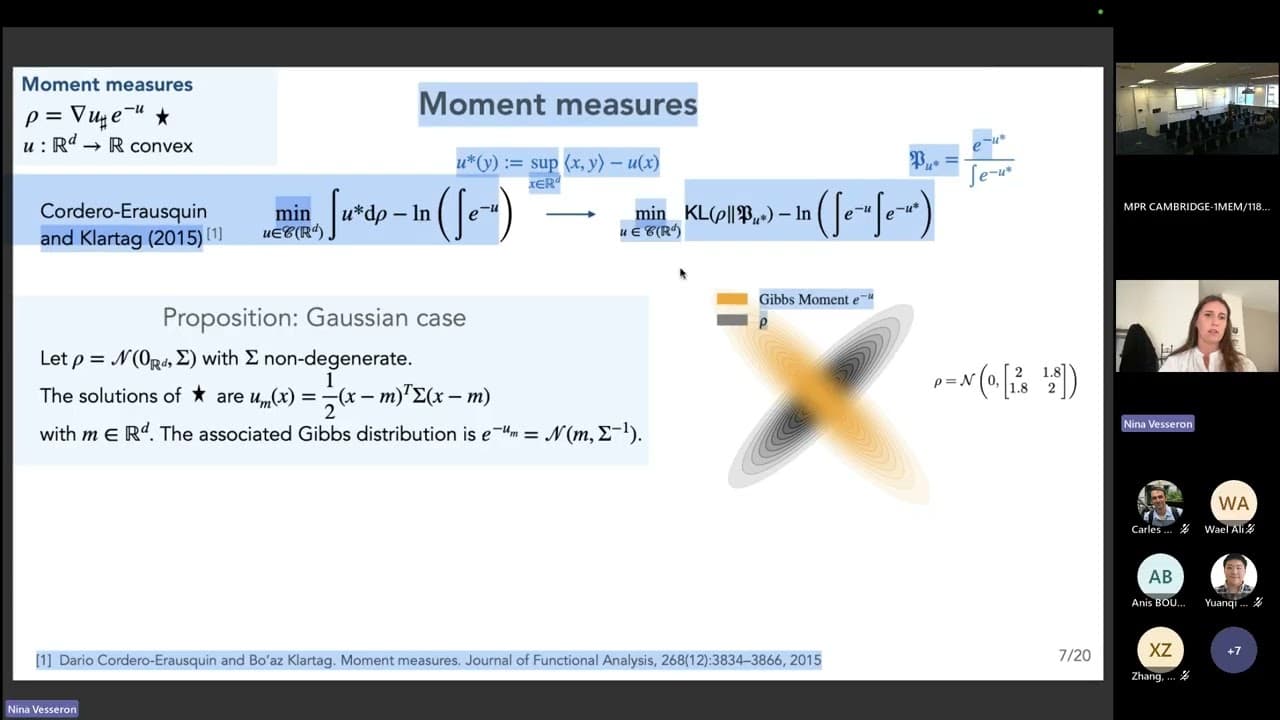
ヴェスロン氏は、まず2015年にCordero-ErausquinおよびKlartagによって提示された従来のモーメント測度因数分解定理($\rho = \nabla u_\sharp e^{-u}$)を生成モデリングへ適用しようとする際の根本的な欠点を数式と図で証明しました。この定理では、目標データ分布 $\rho$ に対し、ある凸関数 $u$ が存在し、ギブス分布(対数凹分布) $e^{-u}$ からのサンプルを $u$ の勾配 $\nabla u$ で輸送することで $\rho$ が得られると示されています。一見するとサンプリングと輸送が単一の関数 $u$ で統合された理想的な構造です。しかし、データ分布がガウス分布 $\rho = \mathcal{N}(m, \Sigma)$ である場合を解析すると致命的な構造問題が生じます。
このとき導出されるギブス分布の共分散行列は $\Sigma^{-1}$ となり、目標データの共分散 $\Sigma$ と完全な逆数関係になります。すなわち、データ空間で分散が大きく広がっている軸(特徴量のバリエーションが大きい方向)に対して、事前ノイズであるギブス分布は原点付近に極めて強く集中(共分散が小さく)してしまいます。逆にデータが集中している軸ではノイズが広く拡散します。このように事前ノイズと目標データの形状が垂直に直交・反転する「分散逆転現象」が発生するため、高密度に濃縮されたノイズを広大なデータ領域へ伸長させる移動マップ $\nabla u$ のリプシッツ定数が著しく増大(爆発)し、数値的な学習や勾配計算が極めて不安定になることが明らかになりました。
サンプリングと輸送を反転統合する共役モーメント測度の定式化
分散逆転問題を解決するため、研究チームはルジャンドル変換(凸共役)を活用した「共役モーメント測度(Conjugate Moment Measure)の因数分解定理」を新たに提示しました。この定理では、目標測度 $\rho$ を $\rho = \nabla w^_\sharp e^{-w}$ と定式化します。ここで $w$ は凸ポテンシャル関数、$w^$ はその凸共役関数(ルジャンドル変換)であり、$\nabla w^*$ が最適輸送マップとして機能します。
ガウス分布 $\rho = \mathcal{N}(m, \Sigma)$ における解を解析すると、ポテンシャル $w(x) = \frac{1}{2}(x-r)^T \Sigma^{-1/3} (x-r)$ が得られ、対応する事前ノイズ分布は $e^{-w} = \mathcal{N}(r, \Sigma^{1/3})$ となります。従来のモーメント測度では共分散が $\Sigma^{-1}$ と反転していたのに対し、共役モーメント測度では共分散が $\Sigma^{1/3}$ となり、目標データ $\Sigma$ と同一の主軸方向へ緩やかに分散します。これにより、事前ノイズ分布の形状がデータ分布の形状と自然にアライメント(極性が一致)し、輸送マップ $\nabla w^*$ に要求される変形量が大幅に低減されます。結果としてリプシッツ定数の爆発が回避され、学習の安定性と生成精度が飛躍的に向上します。
ICNNとランジュバン・モンテカルロ法による多次元ポテンシャル推定量学習
2次元以上の高次元空間においてポテンシャル $w$ をデータサンプルから推定するため、入力凸ニューラルネットワーク(Input Convex Neural Network: ICNN)とランジュバン・モンテカルロ法(Langevin Monte Carlo: LMC)を組み合わせた固定点繰り返しアルゴリズムが開発されました。ポテンシャル $w$ は、入力に対して出力が常に凸になるよう重みに非負制約を設けたICNN $w_\theta$ としてパラメータ化されます。
アルゴリズムの各ステップでは、まずデータ分布 $\rho$ からミニバッチサンプル $x_i$ を抽出し、同時に現在のポテンシャル $w_\theta$ に基づくログコンケイブギブス分布 $e^{-w_\theta}$ からLMCを用いてノイズサンプル $y_j$ を生成します。このときLMCのステップサイズは、ICNNのヘシアンの最大固有値の逆数に基づいて動的に調整されるアダプティブステップが導入されました。理論上はステップごとに厳密なブレニエポテンシャルを計算する必要がありますが、実験の結果、Monge目的関数に対する1回の勾配ステップ(ノイズを含む近似値)を適用するだけでアルゴリズムが安定して収収することが実証されました。
構造化事前ノイズからの属性予測可能な高次元画像生成デモ
動画内では、解像度 $32 \times 32$ のカラー画像(3072次元空間)を用いたアニメ顔画像(Cartoon dataset)の生成デモが示されました。本手法によって学習されたギブス分布 $e^{-w_\theta}$ からLMCでノイズサンプルを抽出すると、従来のガウスノイズのような完全な無秩序画像ではなく、顔の輪郭や髪型、眼鏡などの粗い大域的構造がすでに浮かび上がっている「構造化された事前ノイズ」が得られることが画像で示されました。
さらに、ルジャンドル変換に基づく輸送マップ $y \mapsto \nabla w^*(y) = \arg\max_x (\langle x, y \rangle - w(x))$ を用いてノイズから生成画像へマッピングするプロセスにおいて、ノイズ画像段階で「赤い髪とサングラス」の要素を持つサンプルは、輸送後も確実に「赤髪でサングラスを掛けたアニメ顔画像」へと変換される対応関係が示されました。これは、単一のポテンシャル $w$ によってサンプリング過程と輸送過程が密に結合されているため、事前ノイズの空間における位置や属性情報がそのまま生成画像の属性へとダイレクトに決定される性質を示しています。
モンジュ・アンペール方程式の誘導による画像再構成と未正規化密度推定
研究チームは、共役モーメント測度に関連するモンジュ・アンペール方程式(Monge-Ampère Equation)を誘導し、確率密度の評価(Density Estimation)や画像再構成への応用手法も示しました。密度関数表現 $\mathcal{E}_w^*(x) = w(\nabla w(x)) - \ln(\det H_w(x)) + \ln(C_w)$(ここで $H_w$ は $w$ のヘシアン)を用いることで、生成モデルでありながら対数確率密度の計算が可能になります。
この性質を利用した画像再構成デモでは、一部のピクセルが欠損・汚損された画像に対し、汚損ピクセルの値を対数確率密度が最大化する方向へ勾配上昇(Gradient Ascent)させることで、元の鮮明な顔画像を復元するインペインティング処理が実演されました。また、確率密度関数が正規化定数を除いて既知である物理シミュレーション等のサンプリング文脈においても、未正規化密度 $\rho(x) \propto e^{-E(x)}$ に対してICNNでポテンシャル $w$ を学習し、効率的なサンプル抽出を行うフレームワークが示されました。