公式発表Microsoft Research

物理AIの新潮流、事前学習モデルを推論時に物理法則と結合する生成ギブスサンプリング

シカゴ大学とニューヨーク大学の研究チームは、Microsoft Research主催のセミナーにおいて、複数の事前学習済み生成モデルと明示的な物理コンテキストを推論時に統合する新手法「Generative Gibbs Sampling(生成ギブスサンプリング)」を発表しました。複合系全体の学習データが不足する科学計算の課題に対し、部分系のモデルを再利用して結合することで、水分子の量子シミュレーションにおいて従来比32倍以上の計算効率を達成しています。

AI解析: gemini-flash-latest

元動画: Generative Gibbs sampling: Composing generative models with explicit physical context

3秒でわかる要点

  1. 1複合系全体の学習を行わず、部分系の事前学習モデルを推論時に物理法則と結合する新手法
  2. 2部分系間の相互作用が二次形式の場合、拡散時間有限の条件下でも数学的に厳密なサンプリングを実現
  3. 3液体水の量子シミュレーションにおいて、従来の経路積分分子動力学比でサンプリング速度32倍を達成

何が発表されたのか

シカゴ大学大学院生のWeizhou Wang氏(指導教官:Aaron R. Dinner教授、ニューヨーク大学Jonathan Weare教授)は、Microsoft Research New England主催のセミナーにおいて、事前学習済みの生成モデルと明示的な物理法則を推論時に結合する枠組み「Generative Gibbs Sampling(生成ギブスサンプリング、略称GG-PA)」を発表しました。本発表は査読前論文(arXiv:2405.10642)およびオープンソース実装(GitHubリポジトリ:wwz171/GG-PA)に基づく基礎研究の成果報告です。

近年、タンパク質アンサンブルを生成する「BioEmu」や無機材料構造を生成する「MatterGen」など、科学計算分野における生成AIの適用が進んでいます。しかし、対象系全体を単一のニューラルネットワークで直接生成する「エンドツーエンド学習」には、組合せ爆発によるデータ不足や、環境条件の変更に伴う再学習コスト、既知の物理法則を活用できないという構造的課題が存在していました。今回提案された生成ギブスサンプリングは、単量体などの部分系で個別に学習した拡散モデルを再学習することなく、推論段階で力場や境界条件、相互作用といった物理的コンテキストと数学的に厳密に統合するサンプリング技術です。

発表された機能・アップデートの全容

既存エンドツーエンド学習が直面する「3つの壁」の打破

Wang氏はまず、分子や物質を対象とする生成モデルが直面する本質的なボトルネックを提示しました。第一に「データ問題(Combinatorial Scarcity)」です。単量体のデータは豊富に存在しても、二量体や多量体、複合体の探索空間は組合せ論的に爆発するため、複合系全体の学習データを網羅することは不可能です。さらに、目的とする分布からサンプリングするためにモデルを訓練したいにもかかわらず、訓練データを集めるためにサンプリングが必要になるという循環依存が生じます。

第二に「モジュール性の欠如(Modularity Problem)」です。標準的な水溶液環境で訓練されたモデルは、イオンの追加や結合パートナーの存在、温度変化といった異なるコンテキストに直接適応できません。環境が変わるたびに再学習やファインチューニングを要求されます。第三に「物理知識の喪失(Knowledge Problem)」です。力場や密度汎関数理論(DFT)、対称性といった既存の精密な物理法則が数式として判明しているにもかかわらず、エンドツーエンドモデルはそれらをデータからゼロから再学習しようとするため、ネットワーク容量を浪費します。生成ギブスサンプリングは、これらすべての問題を「推論時における分割と再構成」によって解決します。

拡散モデルを「事後確率サンプラー」として再定義する数学的構造

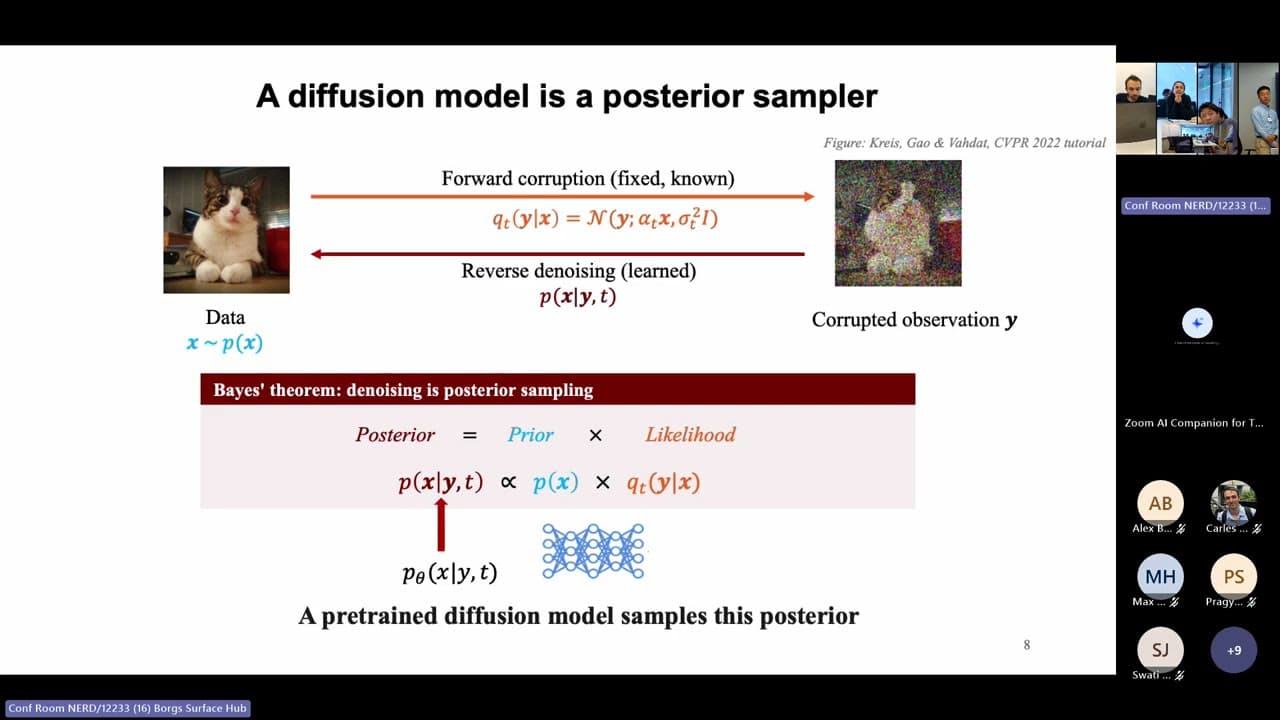
本手法の中核にあるのは、拡散モデルのデノイズ処理をベイズの定理における事後確率サンプラーと見なす着想です。拡散過程において、ノイズ付加カーネルにより破損した観測値が与えられたとき、デノイザーは事前分布と尤度の積である事後分布からサンプリングを行います。研究チームはこの性質を利用し、系全体の状態空間を明示的に保持した拡張ターゲット分布を定式化しました。

系全体の状態ベクトルから各部分系に対応する自由度を読み出す射影関数を定義し、各部分系が保持する事前学習済み拡散モデルの潜在変数とフォワードノイズカーネルを介して結合します。これにより、未学習の物理環境や相互作用エネルギーを「物理コンテキスト」として外付けし、部分系ごとのデノイザーと物理制約の間で交互にサンプリングを行う2ブロックのギブスサンプラーを構築しました。

二次結合における有限時間厳密性(Exactness)の証明

従来のスコア合成手法や拡散ガイダンス技術では、有限の拡散ノイズレベルにおいてサンプリング結果にバイアスが生じることが知られていました。これに対し、本研究は「部分系間の相互作用が二次形式(調和結合)で記述できる場合、有限の拡散時間であっても生成ギブスサンプリングの周辺分布が目標とする物理分布と数学的に厳密に一致する」という命題を証明しました。

逆畳み込みの原理に基づき、拡散ノイズによる平滑化効果を物理コンテキスト側の共分散行列で正確に相殺するスケジューリングを導出しています。この結果、バイアスを完全にゼロに保ったまま有限のノイズ下でサンプリングを実行できるようになり、サンプリング効率と精度のトレードオフを解消しました。

線形逆問題におけるSplit Gibbsサンプラーのバイアス解消

画像再構成や信号処理で広く用いられる線形逆問題において、事前分布とガウス尤度を結合する手法として「Split Gibbs」や「Plug-and-Play」が存在します。しかし、従来のSplit Gibbsでは分割パラメータに起因する共分散の膨張(Covariance Inflation)が発生し、得られる推論結果に不可避の系統的バイアスが含まれていました。

研究チームが導出した共分散整合条件(Proposition 2)を適用することで、Split Gibbsの定式化を修正し、有限の分割パラメータにおいてもバイアスが厳密にゼロとなるサンプラーを導出しました。ガウス混合モデルを用いた数値実験では、従来手法がパラメータ増加に伴って真の分布から乖離したのに対し、提案手法はパラメータ全域において真の分布との完全な一致を維持することを実証しました。

古典統計モデルから水分子の量子核効果を復元

本手法の有用性を示す実証実験として、バルク液体水(216水分子、300K)における量子核効果の計算が行われました。量子統計力学では、ファインマンの虚時間経路積分法を用いることで、1つの量子粒子をバネで環状に結合されたP個の古典的レプリカ(ビーズ)として表現します。このビーズ間相互作用は厳密に調和振動子(二次形式)となるため、本手法の有限時間厳密性の枠組みがそのまま適用できます。

研究チームは、古典的な分子動力学シミュレーションで得られたデータのみで学習した単一の拡散モデルを用意し、推論時に32ビーズの環状ポリマー構造として結合しました。その結果、量子効果を一切学習していないモデルから、軽水(H2O)、重水(D2O)、超重水(T2O)における同位体効果による構造変化や、運動量分布、運動エネルギーの温度依存性が正確に復元されました。

アラニンペプチド単量体モデルからの二量体・複合体構造の自発的形成

相互作用が非二次形式となる一般的な分子間相互作用系への適用例として、真空中のアラニンペプチド(Alanine dipeptide)が検証されました。単一分子のデータのみで学習した拡散モデルに対し、推論時にナトリウムイオン(Na+)との相互作用ポテンシャルを物理コンテキストとして外付けしたところ、イオンがペプチドの2つの酸素原子を配位する正しいキレート構造が生成されました。

さらに、単量体モデルのコピーを2つ用意し、分子間力場を介して推論時に結合させた実験では、ペプチド二量体における平行βシート様配座と反平行βシート様配座の双方が自発的に形成されました。二面角の差の分布において、反平行配座ではゼロ付近に集中し、平行配座では2つの準安定状態に分かれるという集団的挙動が、複合体としての学習を一切行うことなく再現されています。
性能・ベンチマーク

動画内で提示された、300Kにおけるバルク水(216水分子×9座標×32ビーズ=62,208次元)の量子アンサンブルサンプリングに関する定量的ベンチマーク結果は下表のとおりです。比較対象は、古典力場による経路積分分子動力学(PIMD)およびニューラルネットワーク力場(DNN6MB)を用いたMDシミュレーションです。

項目・手法 有効サンプル生成時間(h) 相対効率(ESS/sec) 加速比(Speedup) 測定条件・出典
従来手法(Zundol力場 PIMD) 約18.6時間 1.07 17倍(基準比) CPU(32コア)実行、動画52分付近スライド
従来手法(DNN6MB力場 PIMD) (動画内未記載) 0.0636 1倍(基準) GPU実行、動画52分付近スライド
提案手法(GG-PA、前処理・学習含む) 約1.1時間 0.11 約42倍(CPU比換算で32倍) 1個の事前学習モデルを推論時に32並列呼出し、動画52分付近スライド
提案手法(サンプリング単体) (動画内未記載) 2.0 約32倍 純粋な推論サンプリング時間のみを評価、動画52分付近スライド

バルク水のシミュレーションにおいて、提案手法は6万次元を超える超多自由度系であるにもかかわらず、PIMDと比較して有効サンプルサイズ(ESS)あたりの計算時間を劇的に短縮しました。また、相転移を伴うスカラー場モデル(φ4格子模型、32×32格子)の検証では、臨界点近傍でサンプリングが著しく遅延する「臨界減速」に対し、拡散時間を媒介とするレプリカ交換法を導入することで、緩和時間を桁違いに短縮できることが示されています。

競合手法との比較

本手法と、生成モデルを物理系や逆問題に適用する既存のアプローチとの比較は以下のとおりです。

手法 事前分布(Priors)の扱い コンテキスト(相互作用・制約) 有限ノイズ時の厳密性 空間の共有要件
エンドツーエンド生成(BioEmu, MatterGen等) 複合系全体を単一モデルで直接生成 モデル内部に固定化(暗黙的) 訓練データの質に依存 全自由度を単一空間で処理
ガイダンス / スコア合成 複数モデルのスコアを加算 任意のエネルギー関数 非厳密(自由エネルギー計算が不可解) 全モデルが同一空間で動作必須
Split Gibbs / Plug-and-Play 1つの事前分布モデル ガウス尤度 従来は非厳密(共分散膨張によりバイアス発生) 同一空間
提案手法(Generative Gibbs Sampling) 部分系ごとの事前学習モデルを複数利用 評価可能な任意の物理エネルギー 二次結合において厳密、一般結合で漸近的 射影を介した異種空間の結合が可能

従来の手法では、すべての事前学習モデルが同一の状態空間上で定義されている必要がありました。これに対し、生成ギブスサンプリングは射影関数(Φ)を導入することで、部分空間ごとに学習された異種モデルを、系全体の統一的な状態空間へと統合できる点が根本的な差分です。さらに、物理コンテキストの自由エネルギーを直接計算することなく、2段階の交互更新によってサンプリングを実行できるため、計算困難性に陥らない利点があります。

料金・提供プラン

本発表は大学および研究所によるオープンな学術研究の成果発表であり、商用サービスとしての料金設定やAPIプランの言及はありません。アルゴリズムのソースコードはGitHub上(wwz171/GG-PA)で公開されており、研究・開発目的であれば無償で利用および検証が可能です。

日本から使う方法

日本の研究者やエンジニアが本手法を環境構築して検証するための手順は以下のとおりです。

  • リポジトリの取得: GitHub上の公開リポジトリ(wwz171/GG-PA)をローカルまたはクラウド環境にクローンします。
  • 実行環境の準備: PyTorchが動作するPython環境(CUDA対応GPU推奨)を構築します。バルク水シミュレーションなど大規模系を扱う場合は、十分なVRAM(16GB以上推奨)を備えた計算資源が必要です。
  • 依存ライブラリの導入: 論文内で使用されている分子シミュレーション支援ツールやテンソル計算ライブラリを環境設定ファイル(requirements.txt等)からインストールします。
  • 事前学習済みモデルのロード: リポジトリで提供されているデモスクリプト(真空中のアラニンペプチド単量体や古典水分子の学習済み重み)を使用するか、独自に訓練した拡散モデルのチェックポイントを用意します。
  • サンプリングの実行: スクリプト内の物理コンテキストパラメータ(結合行列、イオンの電荷や力場パラメータ、温度など)を設定し、ギブスサンプリングスクリプトを実行して軌跡を生成します。

誰にどう効くのか

機械学習エンジニア・研究者への影響

複合系全体のデータを集めることなく、単量体や単純な構成要素のデータだけで学習した小型モデルを組み合わせ、大規模なターゲットをサンプリングできるようになります。モデルをゼロから再学習するコストを大幅に抑制でき、モジュール化されたAI開発が可能になります。

計算化学・マテリアルズインフォマティクス実務者への影響

量子核効果を含むシミュレーションや、溶媒・対イオンを含む現実的な溶液環境のモデリングにおいて、従来のPIMDやab initio計算で数週間を要していたサンプリングを、数時間から数分の一の計算リソースで完了できる可能性があります。同位体置換効果や相図の探索が劇的に加速します。

研究開発マネジメント・経営層への影響

新薬開発や機能性材料探索における計算機のインフラコストを最適化できます。条件が変わるたびに発生していた大規模なAIモデルのファインチューニング費用を削減し、既存の学習済み資産を複数の開発プロジェクト間で柔軟に再利用する投資対効果の最大化が期待できます。

まとめ

生成ギブスサンプリングは、データ駆動型の生成モデルと演繹的な物理法則を推論時に分離・統合する、科学計算AIの新たな設計指針を提示しました。今後は非調和結合における高次補正手法の確立や、超巨大生体分子複合体へのスケールアップが焦点となります。創薬や材料開発の現場においては、公開リポジトリの検証を通じて、自社の既存モデル資産を物理コンテキストと結合する実証に着手することが推奨されます。

動画のタイムテーブル

  • 0:00登壇者Weizhou Wang氏の紹介と発表テーマの提示
  • 1:05科学分野における生成AIの現状とエンドツーエンド学習の限界
  • 3:11モジュール性問題と既存物理法則を活用できない知識問題の整理
  • 8:20推論時コンポジションと物理コンテキストの基本概念
  • 11:55拡散モデルの逆過程を事後確率サンプラーとして扱う定式化
  • 15:00結合ターゲット分布の構築と2ブロック生成ギブスサンプラーの導出
  • 18:21ゼロ時間極限における厳密性と有限拡散時間における厳密性の定理
  • 27:34二次相互作用における有限時間厳密性(命題2)の解説
  • 36:08応用例1:線形逆問題におけるSplit Gibbsのバイアス解消
  • 43:00応用例2:φ4格子模型による対称性の破れと臨界緩和の加速
  • 46:33応用例3:古典統計モデルから液体水の量子核効果を復元
  • 57:50応用例4:アラニンペプチド単量体モデルからの二量体・イオン複合体生成
  • 62:38まとめと今後の研究展望、質疑応答

記事で紹介したツール

この機能を、いま自分の環境で試す

記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。

公式サイトで試す

提供: OpenAI

本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-flash-latest)