ホーム / AI・テクノロジー / NVIDIA NVIDIA 2026/09/19
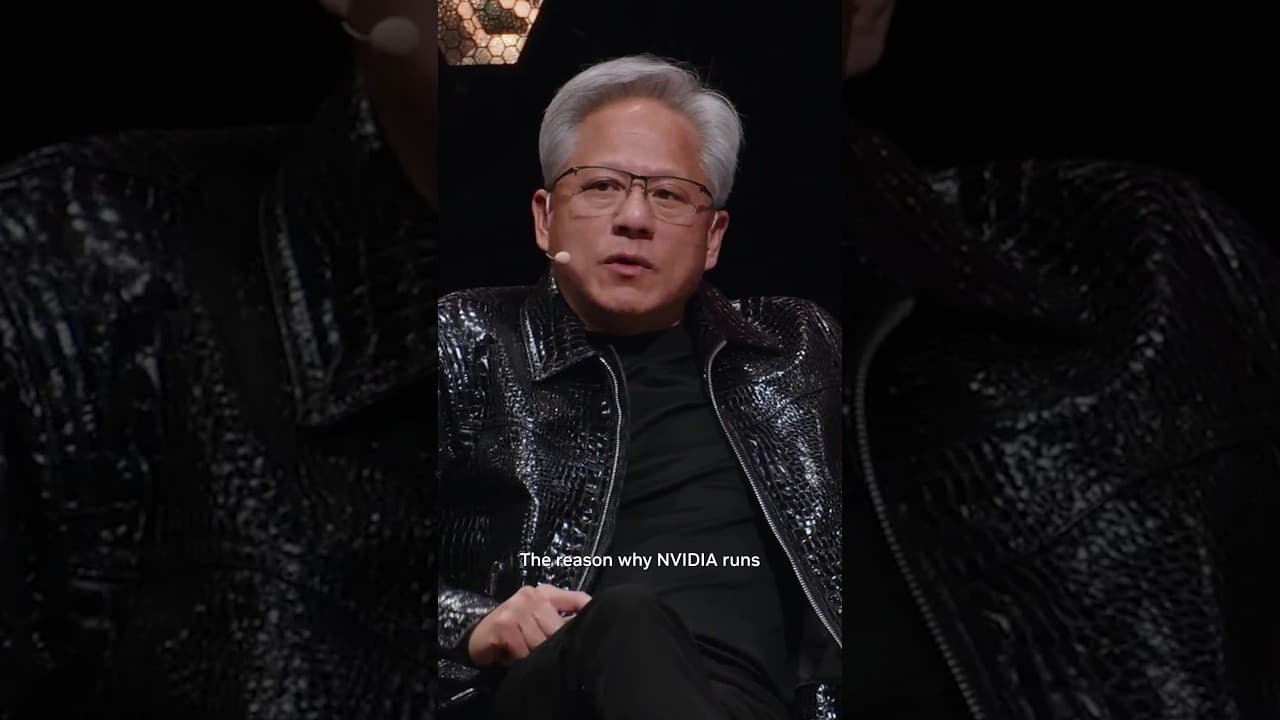
NVIDIAが 米NVIDIAのCEOであるジェンセン・フアン氏が「All-In Summit」に登壇し、同社のAIプラットフォームが世界の主要なAIモデルを網羅するに至った背景と、その基盤にあるエコシステム支援の哲学を語りました。わずか1年半前にはOpenAIの支援に特化していた状況から、現在はGoogleのGemini、MetaのLlama、xAIのGrok、Anthropic、さらにはPhysical Intelligenceなどの新興ロボティクスAIまでを包括する巨大なインフラへと進化を遂げています。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: Why the AI Ecosystem Builds on NVIDIA - Jensen Huang at the All-In Summit
3秒でわかる要点 1 わずか1年半前のOpenAI単一依存から、主要なフロンティアAIモデルすべてを稼働させる基盤へ急拡大を遂げた。2 Google Gemini、xAI Grok、Anthropic、Metaのモデルに加え、新興の物理AI(ロボティクス)ラボもNVIDIA上で構築。3 自社で市場を独占するのではなく、エコシステム全体の成功を最優先にするプラットフォーム哲学を表明。この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
2026年9月に公開された動画において、米NVIDIAの共同創業者兼CEOであるジェンセン・フアン(Jensen Huang)氏が、ビジネスカンファレンス「All-In Summit」に登壇し、同社のAIプラットフォーム戦略について言及しました。今回の発言は、特定の新しいハードウェア製品の発表ではなく、同社が世界のAIエコシステムにおいて果たしている役割と、その急速な市場変化を振り返る総括的な位置づけとなります。
フアン氏は、わずか1年半前(2025年初頭から2024年中期を指す)にはNVIDIAのインフラ上で実質的に稼働していたのはOpenAIのモデルのみであったと明かしました。そこから現在では、業界の主要なフロンティアAIモデルのほぼすべてが同社のプラットフォーム上で稼働、あるいはスケールアップしている現状を説明しました。この発言は、NVIDIAが単なる半導体メーカーではなく、AIソフトウェアおよびインフラストラクチャにおける絶対的なデファクトスタンダード(事実上の業界標準)としての地位を確立したことを改めて強調するものとなっています。
発表された機能・アップデートの全容
フアン氏が語った内容は、同社のハードウェアおよびソフトウェアがどのようにして多様なAIモデルのインフラとなったのか、そのエコシステム拡大の全容を示しています。具体的なポイントを4つの側面に分けて解説します。
OpenAI単一依存からの脱却とマルチモデル対応
フアン氏は、約1年半前の状況を「私たちが動かしていた唯一のものはOpenAIだった(the only thing we ran was OpenAI)」と振り返っています。当時はChatGPTのブームに伴い、OpenAIのGPTシリーズがAI市場の需要を独占しており、NVIDIAの計算資源もその大半がOpenAIのトレーニングおよび推論に割り振られていました。しかし、現在ではその状況が劇的に変化し、特定の企業やモデルに依存しない「マルチモデル基盤」としての地位を確立しています。これは、NVIDIAのGPUおよびソフトウェアスタックが、多様なアーキテクチャを持つ異なるAIモデルに対して、高い汎用性と最適化能力を提供できていることを示しています。
フロンティアAIモデルおよびオープンモデルの急増
現在、NVIDIAのプラットフォーム上で稼働している具体的なモデルとして、フアン氏は複数の主要なフロンティアAIモデルを列挙しました。Metaが開発する「Llama」(動画内では文字起こしの都合上「Meta Muse」と表現されていますが、文脈上はMetaのLlamaシリーズ等のAIモデルを指します)、xAIが開発する「Grok(Grok Bot)」、Googleの「Gemini」、および「Anthropic」のClaudeシリーズが同社プラットフォーム上でスケールアップしていると言及されました。これらのモデルは、クローズドソースの商用APIから、オープンに利用可能なオープンウェイトモデルまで多岐にわたります。NVIDIAは、これらの異なるライセンス形態や配布モデルを持つすべての企業に対して、等しく高性能な計算基盤を提供しています。
新興AIスタートアップや物理AI(ロボティクス)への対応
フアン氏は、既存の巨大IT企業だけでなく、次世代のAIラボやスタートアップが急速に台頭している現状にも焦点を当てました。「Ineffables(インエファブルズ)」や「Reflections(リフレクションズ)」、さらにはロボティクスや物理的な世界を理解するAIを開発する「Physical Intelligence(フィジカル・インテリジェンス)」などの具体的な新興ラボの名前を挙げ、これらすべての組織がNVIDIAのインフラ上で自社のAIモデルを構築していることを明らかにしました。特に物理AIの分野は、従来のテキスト生成AIとは異なり、リアルタイムのセンサー処理や物理シミュレーションを必要とするため、NVIDIAのシミュレーションプラットフォーム(Omniverseなど)とGPUの組み合わせが不可欠な要素となっています。
エコシステム全体を勝者にするプラットフォーム哲学
NVIDIAがなぜこれほど多くの競合するAI企業から支持されるのかについて、フアン氏は企業の根本的な哲学を説明しました。「私たちは自ら市場のシェアを切り取る(a slice)のではなく、エコシステムに関わる全員が成功するのを支援したい(help everybody succeed)」という姿勢です。NVIDIAは、自社で独自の消費者向け汎用LLMを開発して競合するのではなく、インフラ、ライブラリ、最適化ツールを提供することに徹しています。この中立的かつ支援的なスタック提供の姿勢があるからこそ、競合関係にあるOpenAI、Google、Meta、Anthropicなどの企業が、安心してNVIDIAのプラットフォーム上で自社の最先端モデルをスケールアップさせることができるのです。
性能・ベンチマーク
動画内では、具体的なハードウェアのベンチマーク数値や測定条件についての提示はありませんでした。しかし、フアン氏の発言の背景として、NVIDIAの最新GPUアーキテクチャ(Hopper世代のH100/H200、およびBlackwell世代のB200/GB200)が、業界のデファクトスタンダードとして機能していることが挙げられます(編集部注)。
以下に、NVIDIAが提供する主要なAIインフラの現行世代における位置づけを整理します。
項目名
特徴・役割
出典(動画内 or 編集部注)
Hopperアーキテクチャ (H100/H200)
1年半前にOpenAIなどのトレーニングを支えた主力のGPUシリーズ。
編集部注
Blackwellアーキテクチャ (B200/GB200)
現在各フロンティアAIラボがスケールアップのために導入を進めている次世代GPU。
編集部注
CUDAプラットフォーム
競合他社が追従できない、NVIDIA製GPU専用のソフトウェア開発環境。
編集部注
NIM (NVIDIA Inference Microservices)
各種オープンモデル(Llamaなど)を即座にデプロイするための最適化コンテナ群。
編集部注
競合サービスとの比較
NVIDIAのAIインフラストラクチャプラットフォームを、競合となる独自のAIチップ(ASIC)を開発するハイパースケーラー(Google、Meta、Microsoftなど)のインフラと比較します(本比較は編集部知識に基づく分析を含みます)。
比較項目
NVIDIA プラットフォーム
競合インフラ(Google TPU / AWS Trainium等)
対応モデルの柔軟性 極めて高い。OpenAI、Gemini、Grok、Llamaなど、あらゆるアーキテクチャに即座に対応。
限定的。自社サービスや特定のフレームワーク(TensorFlow、JAX等)に最適化されていることが多い。
ソフトウェアエコシステム CUDAおよびNIMによる圧倒的な開発者コミュニティとライブラリの蓄積。
独自SDKの整備が進むものの、開発者の習熟度やライブラリの豊富さではNVIDIAに及ばない。
導入の容易さ 主要なクラウドベンダー(AWS、Azure、GCP、OCI)すべてで共通して利用可能。
特定のクラウド環境(例:TPUはGoogle Cloudのみ)にロックインされる。
コスト効率 ハードウェア単価は極めて高価。ただし、開発速度と学習効率の面で相殺される場合が多い。
自社開発チップのため、特定のタスクにおいてはコストパフォーマンスが非常に高い。
中立性 自社で競合する汎用LLMサービスを直接展開しないため、AIスタートアップとの利害衝突が少ない。
自社でGeminiやClaude(出資関係)を抱えており、顧客であるAI企業と競合関係になりやすい。
取材班の見立てでは、NVIDIAの最大の優位性は、単なる半導体の処理能力(TFLOPS)ではなく、「中立的なプラットフォームとして、すべてのAI開発者に共通の最適化環境を提供する」というビジネスモデルにあります。これにより、AI開発企業はインフラの心配をすることなく、モデルのアルゴリズム開発に専念できます。
料金・提供プラン
今回の動画はカンファレンスにおける対談であり、具体的なGPUの販売価格やAPIの料金プランについての言及はありませんでした。
一般に、NVIDIAの計算資源は、Microsoft Azure、Amazon Web Services (AWS)、Google Cloud Platform (GCP)、Oracle Cloud Infrastructure (OCI) などの主要なパブリッククラウドを通じて、時間貸しのインスタンス形式で提供されています。また、AIスタートアップ向けには、NVIDIA Inceptionプログラムを通じて、割引や技術支援が提供されています(編集部注)。
日本から使う方法
日本の開発者や企業が、NVIDIAのAIエコシステムを活用して自社のモデルを構築・実行するための具体的な手順は以下の通りです。
クラウドGPUインスタンスの確保 : 独自のモデル訓練や大規模な推論を行う場合、AWS(東京リージョン)、Google Cloud、Microsoft Azure、または国内のGPUクラウドプロバイダー(さくらインターネットやハイレゾなど)から、NVIDIA H100やA100を搭載したインスタンスを起動します。NVIDIA NGC(GPU Cloud)へのアクセス : NVIDIAが提供する公式のコンテナレジストリ「NGC」にアカウントを作成します。ここから、PyTorchやTensorFlowなどの最適化済みフレームワーク、あるいは各種LLMのデプロイ用コンテナ(NVIDIA NIM)を無償または有償で取得できます。CUDA環境のセットアップ : ローカルのGPU環境(RTXシリーズなど)またはクラウドインスタンス上で、最新のCUDA ToolkitおよびcuDNNライブラリをインストールします。日本語のドキュメントも豊富に用意されています。オープンモデルの実行 : フアン氏が言及したMetaのLlamaシリーズなどのオープンモデルは、NVIDIAの最適化ライブラリ(TensorRT-LLM)を利用することで、最小限の遅延で日本語環境での推論を実行可能です。
誰にどう効くのか
NVIDIAのマルチモデル戦略とエコシステム支援は、各ビジネスレイヤーに以下のようなインパクトをもたらします。
エンジニア(開発・運用担当者)
特定のAIベンダーにロックインされるリスクを回避できます。NVIDIAの共通基盤(CUDA/NIM)を習得しておけば、OpenAIからLlama、Gemini、Anthropicなど、どのような最新モデルが登場しても、同一のインフラスキルで対応・デプロイが可能です。モデルの移行や、複数モデルを組み合わせたハイブリッド構成の構築が容易になります。
企画・マーケティング層
最先端のAI技術トレンド(テキスト、画像、ロボティクス、物理AI)を、インフラの制約なく自社のサービスに組み込むことができます。NVIDIAのプラットフォーム上で動作する多様なスタートアップのソリューションを迅速に選択・検証できます。これにより、新しいAIサービスの市場投入までの時間(Time to Market)を劇的に短縮できます。
経営層・意思決定者
特定のAIモデル開発企業の盛衰に左右されない、強固なITインフラ戦略を構築できます。NVIDIAが中立的な立場であらゆるAIスタートアップを支援しているため、どのAI企業が勝者になっても、自社のシステム基盤は揺らぎません。AI投資における地政学的リスクやベンダーリスクを最小限に抑え、長期的な成長戦略を描くことができます。
まとめ
NVIDIAは、わずか1年半でOpenAIの単一支援から、世界の主要なAIモデルすべてを稼働させる「AIエコシステムの共通インフラ」へと進化を遂げました。同社の中立的なプラットフォーム哲学は、競合するAI企業同士を同じ基盤の上に共存させることに成功しています。開発者や経営層は、特定のモデルに依存するのではなく、NVIDIAのプラットフォーム上で稼働する多様な選択肢を柔軟に組み合わせるシステム設計を検討すべき時期に来ています。
動画のタイムテーブル 0:00 NVIDIAが世界中のあらゆるAIモデルを動かしている現状についての言及 0:04 1年半前の状況(OpenAIのみを動かしていた時期)の振り返り 0:09 Meta、Grok、Gemini、Anthropicなど主要モデルの対応状況の解説 0:22 フロンティアAIモデルのオープン化とモデル数・ラボ数の増加について 0:38 Physical Intelligenceなどの新興物理AIラボの台頭と言及 0:47 NVIDIAがすべてのラボを支援し、エコシステム全体を成功させる哲学の表明 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)