ホーム / AI・テクノロジー / NVIDIA NVIDIA 2026/10/01
NVIDIAがFungible(融通性) 」とは NVIDIAは、同社のAIインフラストラクチャにおける重要な設計思想として「Fungible(融通性・代替可能性)」という概念を提示しました。これは、特定のAIモデルや処理に依存せず、あらゆるAIワークロードや一般計算を同一のハードウェアで柔軟に処理できる能力を指します。本記事では、この概念が企業のAI投資にどのようなメリットをもたらすのか、技術的背景と投資対効果(ROI)の観点から詳しく解説します。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: What does “fungible” mean for AI infrastructure?
3秒でわかる要点 1 Fungible(融通性)とは、同一のNVIDIA GPUで多様なAIモデルや一般計算を処理できる能力を指します。2 すべてのワークロードを並列計算という共通の数学的処理にマッピングし、CUDA-Xライブラリで最適化します。3 Productive(生産的)とDurable(長寿命)を組み合わせることで、企業のAI投資のROIを最大化します。この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
NVIDIAは、同社が提供するAIインフラストラクチャの価値を再定義する概念として「Fungible(ファンジブル:融通性・代替可能性)」を提唱しました。これは特定のAIモデルや処理手法に固執せず、多様なアクセラレーテッド・ワークロードを柔軟に処理できる能力を指します。本発表は、新製品のリリースではなく、同社が長年築き上げてきたGPUハードウェアと「CUDA」ソフトウェアエコシステムの優位性を、投資対効果(ROI)の観点から体系化したものです。急速に変遷するAI技術において、ハードウェアの陳腐化を防ぎ、企業の巨額なインフラ投資を保護するための基本方針として、すでに一般提供(GA)されているすべてのNVIDIAプラットフォームに適用される考え方です。
発表された機能・アップデートの全容
多様なワークロードを同一インフラで処理する「Fungibility」の定義
NVIDIAが強調する「Fungible」という言葉は、本来金融分野で「代替可能」や「融通がきく」という意味で使われる用語です。動画内では、CNBCのインタビューにおいて、ジェンセン・フアンCEOがこの言葉を繰り返し使用している様子が紹介されています。AIインフラにおけるFungibilityとは、単一のハードウェアプラットフォーム上で、あらゆる種類のAIモデル、AIのライフサイクルにおけるすべてのフェーズ、さらにはAI以外の一般的な計算処理までを、設定や構成の変更なしに柔軟に実行できる能力を指します。
具体的には、大規模言語モデル(LLM)の学習から、画像生成モデルのファインチューニング、リアルタイムの音声認識の推論処理、さらには流体力学シミュレーションや金融工学のデータ解析といった、非AIのアクセラレーテッド・ワークロードまでが、同一のNVIDIA GPUクラスター上でシームレスに動作します。これにより、特定のAIモデルが急速に陳腐化し、新しいアーキテクチャのモデルが登場した場合でも、導入したインフラを丸ごと新しいワークロードに転用することができます。
基礎となる数学的処理の並列化とGPUの設計思想
なぜNVIDIAのGPUがこれほど多様なワークロードに対応できるのか、その技術的な要因について、動画の担当者は「すべてのワークロードは、最終的に同じ基礎となる数学(underlying math)にマッピングされる」と説明しています。この「同じ数学」とは、数百万もの計算を同時に、かつ独立して実行する「並列計算」を指します。ディープラーニングにおける行列乗算、画像処理におけるピクセルごとの演算、科学シミュレーションにおける格子点ごとの物理量計算などは、すべてこの並列計算という共通の数理モデルに帰着します。
NVIDIAのGPUは、この大量の並列計算を極めて効率的に処理することに特化したマイクロアーキテクチャを備えています。特定のアルゴリズムをハードウェア回路として固定する「ASIC(特定用途向け集積回路)」とは異なり、汎用的な演算器(CUDAコアやTensorコア)を大量に配置し、それらをソフトウェアで柔軟に制御できるように設計されているため、処理の内容が変わっても、高い演算効率を維持したまま対応できるのです。
ソフトウェアレイヤー「CUDA」と数千の「CUDA-X」ライブラリの役割
ハードウェアの並列演算能力を、具体的なアプリケーションの高速化へと結びつける架け橋となるのが、NVIDIAのソフトウェアスタックです。動画内では、GPUをプログラミングするための基盤となるソフトウェアレイヤーとして「CUDA」が紹介されています。さらに、そのCUDAの上で動作する「数千のCUDA-Xライブラリ(thousand CUDA-X libraries)」の存在が、NVIDIAインフラのFungibilityを支える決定的な要素として挙げられています。
CUDA-Xライブラリは、特定の処理分野に最適化されたソフトウェアモジュールの集合体です。例えば、ディープラーニング演算を高速化する「cuDNN」、LLMの推論を最適化する「TensorRT-LLM」、データ分析や前処理を高速化する「cuDF」、物理シミュレーション用の「Modulus」などがあります。開発者は、低レベルのGPUアーキテクチャを意識することなく、これらの高度に最適化されたライブラリをAPI経由で呼び出すだけで、自社のワークロードを即座に高速化できます。この膨大かつ成熟したソフトウェアエコシステムがあるからこそ、NVIDIAのインフラは多様な処理に対して即座に適応できるのです。
投資効率を高める「Productive」と「Durable」の相乗効果
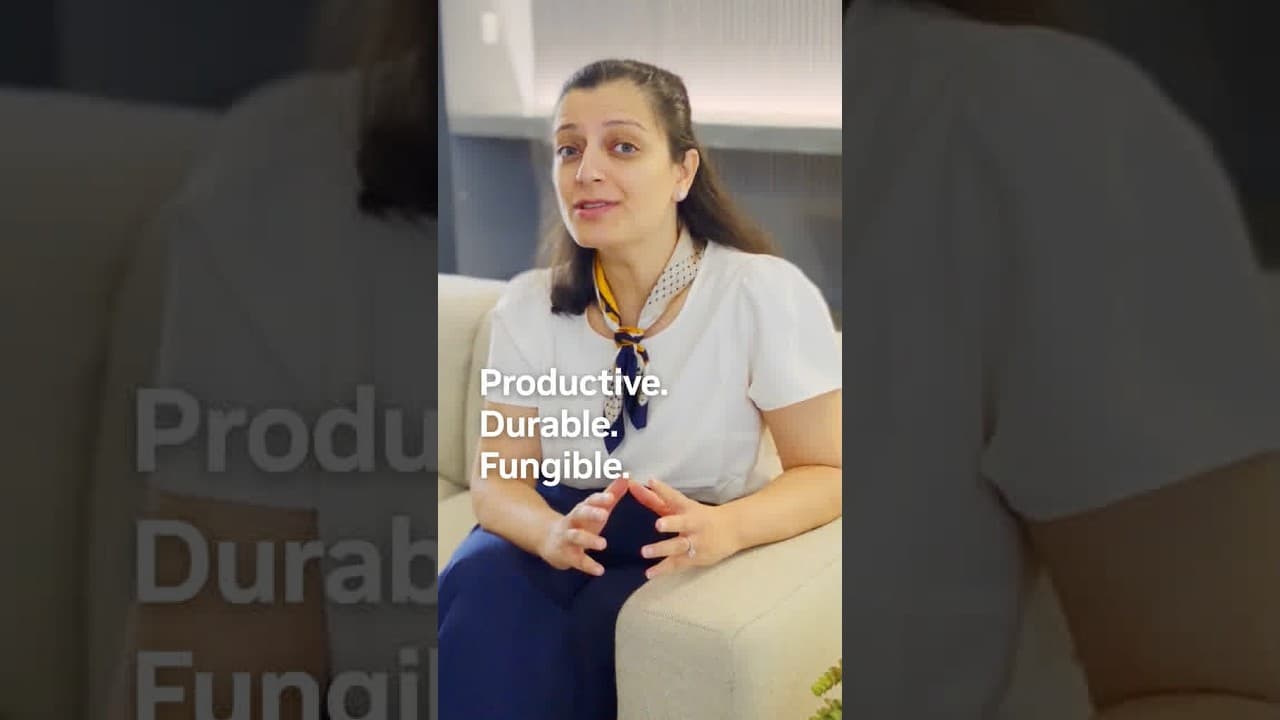
動画では、AIインフラの価値を評価する3つの重要な評価軸として「Productive(生産的)」「Durable(耐久性がある)」「Fungible(融通性がある)」が提示されています。これらは独立した要素ではなく、互いに相乗効果を発揮して、企業の投資収益率(ROI)を最大化します。
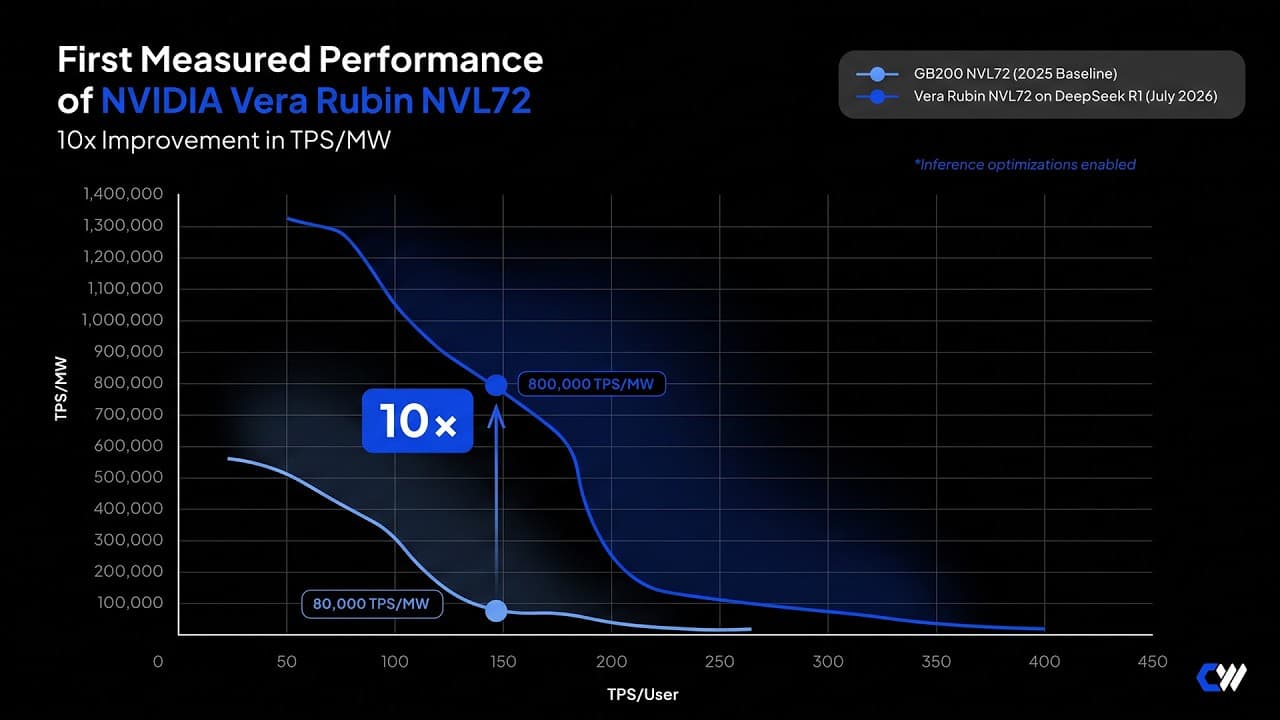
まず「Productive」について、動画内では「メガワット(MW)あたりのスループットを最大化し、収益を最大化する」と説明されています。データセンターの運営において最大の制約となるのは電力消費です。NVIDIAのインフラは、単位電力あたりに処理できるデータ量やトークン数を極限まで高めるよう設計されています。これにより、サービスの運営コスト(トークンコスト)を最小化し、企業の利益率を最大化します。
次に「Durable」は、導入したハードウェアが長年にわたって価値を維持し続けることを意味します。AIの技術トレンドは数ヶ月単位で激変しますが、NVIDIAのGPUはソフトウェア(CUDAおよびCUDA-X)の継続的なアップデートによって、最新のアルゴリズムにも適応し続けます。これにより、ハードウェアを頻繁に買い換える必要がなくなり、数年間にわたって高い稼働率を維持することができます。そして「Fungible」によって、昼間は顧客向けのリアルタイム推論処理にGPUを割り当て、夜間はAIモデルの再学習や社内のデータ解析にリソースを振り分けるといった、柔軟なリソース運用が可能になります。これら3つの要素が組み合わさることで、「1ワットあたりの作業量(more work per watt)」「稼働年数(more years of work)」「作業の種類(more kinds of work)」がすべて向上し、インフラ投資の価値が最大化されるのです。
性能・ベンチマーク
動画内で具体的なベンチマークスコアの数値は提示されていませんが、NVIDIAが主張するパフォーマンス指標と測定条件の考え方を以下のように整理できます。
評価指標
測定条件・定義
出典(動画内 or 編集部注)
メガワットあたりのスループット
消費電力(メガワット)に対する処理能力の最大化
動画内(0:40)
トークンコスト
生成AIの推論処理における1トークンあたりのコスト最小化
動画内(0:45)
ワークロードの多様性
同一GPU上でのAI学習、推論、AI以外の計算処理の互換性
動画内および概要欄
(編集部注:NVIDIAの最新GPUアーキテクチャ「Blackwell」などでは、前世代のHopperと比較してLLM推論の電力効率が大幅に向上していることが公表されており、動画で語られている「メガワットあたりのスループット最大化」はこれらのハードウェア進化とCUDAの最適化によって裏付けられています。)
競合サービスとの比較
NVIDIAの「Fungible(汎用・融通性)」なインフラというアプローチを、特定のタスクに特化したASIC(特定用途向け集積回路)や、他社のクラウドAIアクセラレータと比較します。
比較項目
NVIDIA GPU + CUDA(本発表の対象)
競合TPU / ASIC(Google TPU, AWS Trainium等)
専用ASIC(特定モデル専用チップ)
出典・補足
柔軟性(Fungibility) 極めて高い 。あらゆるAIモデル、フェーズ、一般計算に対応。中〜高 。主要フレームワークに対応するが、最適化範囲は限定的。極めて低い 。特定のアルゴリズムやモデル構造に固定。(編集部注)NVIDIAのCUDAエコシステムによる優位性。
ソフトウェアの厚み 圧倒的 。数千のCUDA-Xライブラリと膨大な開発者コミュニティ。中 。TensorFlowやPyTorchの対応は進むが、ライブラリ数は劣る。低い 。専用のSDKのみ、開発者の確保が困難。動画内「数千のCUDA-Xライブラリ」に基づく比較。
投資の耐久性(Durability) 高い 。数年後の新モデルもソフトウェア更新で高速実行可能。中 。アーキテクチャの世代交代で古いチップの活用が制限される場合あり。低い 。モデルのトレンドが変わるとチップ自体が陳腐化。動画内「より長い稼働年数(more years of work)」に基づく。
初期導入コスト 高い 。GPU本体およびライセンス費用が高額。中〜低 。クラウド経由での利用が主で、初期投資を抑えやすい。個別見積もり 。開発コストが高く、量産効果が出にくい。(編集部注)一般的な市場価格に基づく。
(編集部注:GoogleのTPUやAWSのTrainium/Inferentiaは、特定のディープラーニングフレームワークにおいて高いコストパフォーマンスを発揮しますが、NVIDIAのように「AI以外の一般的なシミュレーションやデータ解析まで同一インフラで高速にこなす」というレベルの汎用性(Fungibility)や、数千規模の最適化ライブラリ群(CUDA-X)の蓄積には及びません。NVIDIAはこの「汎用性とエコシステムの厚み」を最大の防御壁としています。)
料金・提供プラン
動画内では、具体的なGPUの販売価格やクラウドでの利用料金についての言及はありません。
(編集部注:NVIDIAのAIインフラは、DGXシステムなどのオンプレミスサーバーとして購入するか、Microsoft Azure、AWS、Google Cloud、Oracle Cloud、あるいは日本国内のさくらインターネットなどの主要なクラウドプロバイダーを通じて「GPUインスタンス」として時間単位でレンタルする形で提供されています。CUDAおよび主要なCUDA-Xライブラリは、NVIDIA GPUの利用者に無償またはエンタープライズサポート契約(NVIDIA AI Enterprise)の一部として提供されます。)
日本から使う方法
NVIDIAの「Fungible」なAIインフラおよびCUDAエコシステムを日本国内から利用するための手順は以下の通りです。
クラウドプロバイダーの選択
AWS(Amazon Web Services)、Microsoft Azure、Google Cloud、または国内のクラウド事業者(さくらインターネットなど)のアカウントを作成します。
NVIDIA GPU搭載インスタンスの起動
H100、A100、または最新のBlackwell世代のGPUが搭載されたインスタンス(例: AWSの「p5」インスタンスなど)を選択して起動します。
CUDA環境のセットアップ
多くのクラウドでは「Deep Learning AMI」などのプリインストールイメージが用意されており、これを選択することでCUDAおよび主要なドライバーがセットアップされた状態で開始できます。
CUDA-Xライブラリの導入
開発するアプリケーションに応じて、NVIDIA NGC(NVIDIA GPU Cloud)カタログから、cuDNN、TensorRT、Triton Inference Serverなどの最適化コンテナやライブラリをプルして利用します。
日本語対応と制限事項
CUDAおよび開発ツール群はグローバル標準の英語ドキュメントが主ですが、日本語のコミュニティや代理店によるサポートも充実しています。利用するクラウドのリージョンによっては、最新GPUの在庫制限(クォータ制限)があるため、事前に利用申請(上限緩和申請)が必要です。
誰にどう効くのか
エンジニア(開発・運用担当者)へのインパクト
開発するAIモデルの構造やフレームワーク(PyTorch、TensorFlow、JAXなど)が変化しても、基礎となるCUDAおよびCUDA-Xライブラリが抽象化してくれるため、ハードウェアの選定や低レイヤーの最適化に煩わされることなく、最先端のアルゴリズム実装に集中できます。また、AI以外のデータ前処理(cuDF等を利用)も同一のGPUインフラ上で高速化できるため、データパイプライン全体のボトルネックを解消できます。
企画・マーケティング担当者へのインパクト
「Fungible」なインフラであるため、新規のAIサービス(画像生成、音声認識、LLMなど)を立ち上げる際、既存のインフラリソースをそのまま流用して迅速にPoC(概念実証)や本番展開を行うことができます。インフラ調達のリードタイムが不要になり、市場のトレンド変化に合わせた迅速なサービスローンチが可能になります。
経営層・CIOへのインパクト
数千万円から数十億円規模にのぼるAIインフラ投資において、「数年後に現在のAIモデルが使われなくなったら、この投資は無駄になるのではないか」という技術陳腐化リスク(技術的負債)を大幅に低減できます。NVIDIAのGPUは「Durable(長寿命)」であり、ソフトウェアのアップデートによって5年後、10年後の未知のAIモデルにも対応できるため、投資対効果(ROI)を最大化し、資本効率を高めることができます。
まとめ
NVIDIAが提示した「Fungible(融通性)」という概念は、単なるハードウェアの性能アピールにとどまらず、急激に変化するAI市場において企業の投資リスクを最小化するための極めて合理的なアーキテクチャ論です。1ワットあたりの処理量を増やし、稼働年数を延ばし、対応するワークロードを多様化することで、ROIを最大化します。企業のIT決定者は、単なるチップ単体の価格性能比だけでなく、この「融通性」と「持続性」を評価軸に加えてインフラ選定を行うべきです。
動画のタイムテーブル 0:00 AIインフラにおける「Fungible」というキーワードの提示 0:07 Fungibleが意味する「多様なアクセラレーテッド・ワークロードの実行」の解説 0:15 共通の数学的処理(並列計算)とNVIDIA GPUの設計思想の関係 0:27 ソフトウェアレイヤー「CUDA」と「CUDA-X」ライブラリの役割 0:36 投資効率を高める「Productive」「Durable」の概念とROI最大化の仕組み 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)