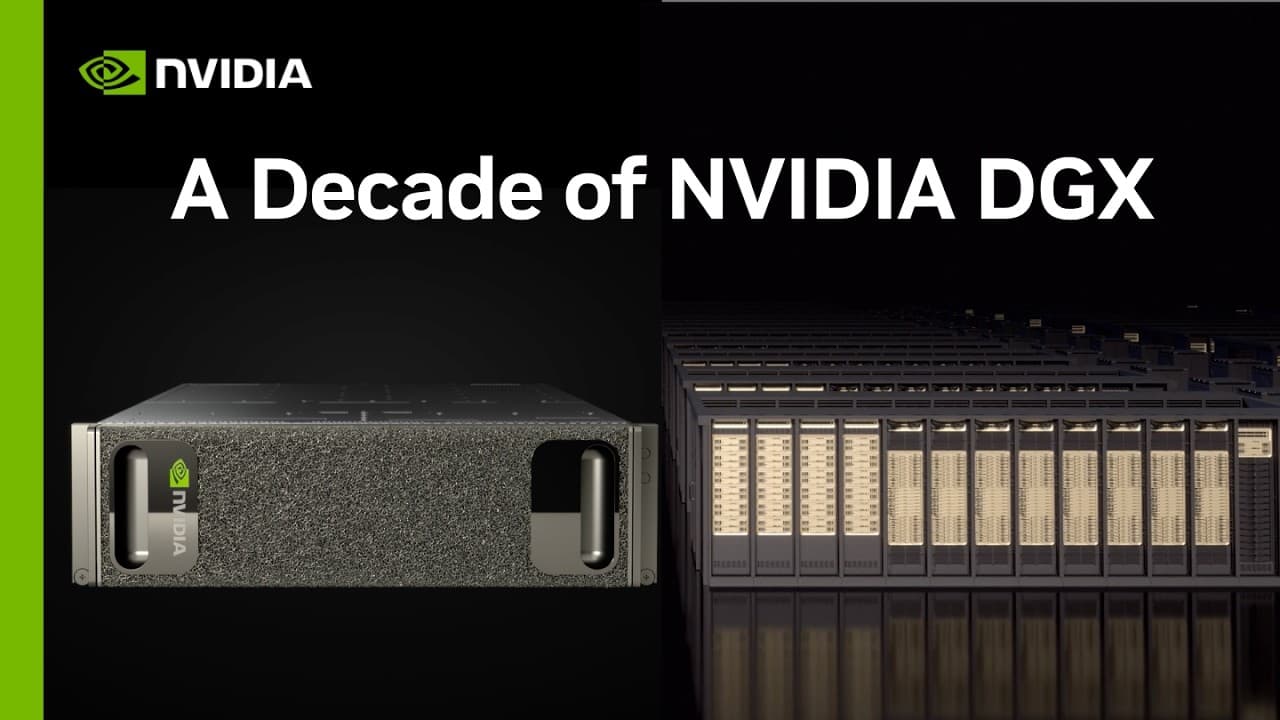
米エヌビディアは、AI専用スーパーコンピューティング基盤「NVIDIA DGX」シリーズの登場から10年間にわたる進化の軌跡と今後の展望を公開しました。2016年の初代「DGX-1」提供から始まった同システムは、個別のサーバーからデータセンター全体を統合する「AIファクトリー」へと拡大を続けています。次世代アーキテクチャ「Vera Rubin」に基づくラック規模システムでは、推論トークンコストを最大10分の1に削減する見通しです。
何が発表されたのか
米エヌビディア(NVIDIA)は、同社のAI専用スーパーコンピューティング基盤「NVIDIA DGX」プラットフォームが歩んだ10年の歴史と、次世代アーキテクチャの展望を発表しました。同社でDGXシステム部門のバイスプレジデントを務めるチャーリー・ボイル(Charlie Boyle)氏が登壇し、これまでの技術的マイルストーンを振り返りつつ、次世代プラットフォームに関する重要指標を明らかにしました。
今回の発表は単なる歴史の回顧にとどまりません。次世代GPUアーキテクチャ「Vera Rubin」に基づくラック規模(Rack-scale)システムにおいて、自律型AI(エージェンティックAI)ワークロードの推論トークンコストを最大10分の1(10x reduction)に低減できる見通しを示しました。研究開発用途の単体アプライアンスから始まったDGXが、製造・金融・創薬を支える「AIファクトリー」の標準アーキテクチャへと昇華したことを公式に宣言する内容です。
発表された機能・アップデートの全容
初代「DGX-1」から始まった統合AIアプライアンスの原点
2016年の年次カンファレンス「GTC 2016」で発表された初代「NVIDIA DGX-1」は、独自インターコネクト規格「NVLink」を初めて本格採用したシステムでした。当時、ディープラーニングの研究現場では、研究者自身が複数の汎用パーツやGPUボードを寄せ集めて配線し、動作環境を手探りで構築していました。発熱や帯域幅の制限により、実験規模の拡大には限界が生じていました。
エヌビディアはこの課題を打破するため、8基のGPUを高帯域NVLinkで直結し、ソフトウェアスタックを完全に事前統合した単一の筐体としてDGX-1を市場に投入しました。2016年当時、ジェンスン・フアンCEO自らが設立間もないOpenAIへ初号機を手渡しで納入した場面は、生成AI革命の端緒として記録されています。単一筐体で圧倒的な計算密度を提供したDGX-1は、その後の大規模言語モデル研究を物理的に支える標準機となりました。
「DGX SuperPOD」によるターンキー型大規模クラスタの実現
単一サーバーの提供にとどまらず、エヌビディアはクラスタ規模の拡張モデルとして「DGX SuperPOD」を定義しました。従来、数千基規模のGPUクラスタを構築するには、ネットワーク設計、電源設計、熱対策の検証に数カ月から数年を要していました。DGX SuperPODは、計算ノード、InfiniBandスイッチ、ストレージファブリックを設計図(ブループリント)として規格化しました。
これにより、あらゆる規模の組織が最高水準のAIインフラをわずか数日または数週間で展開できるようになりました。動画内では、米フロリダ大学の「HiPerGator」やスウェーデン・リンショーピン大学の「Berzelius Supercomputer」、世界のスーパーコンピュータランキング「TOP500(2023年11月)」で世界第9位にランクインしたエヌビディア自社クラスタ「Eos」が、DGX SuperPODを基盤として稼働している様子が紹介されています。
HopperからBlackwellへ:自律型AIを支える超広帯域と大容量メモリ
「NVIDIA Hopper」から最新の「NVIDIA Blackwell」アーキテクチャに至る過程で、DGXの開発思想は大規模コンテキストの処理へと大きく舵を切りました。従来の単純な対話型チャットボットから、自律的に意思決定を下すエージェンティックAIへの進化に伴い、メモリ容量と帯域幅の不足が最大のボトルネックとなっていたためです。
エヌビディアは第5世代NVLink技術や広帯域メモリ(HBM)をDGX基盤へ密統合することで、巨大モデルにおける通信遅延とメモリ制限を排除しました。動画内では、米製薬大手イーライリリー(Eli Lilly & Company)が創薬におけるインシリコ(コンピュータ上)での分子設計に導入し、数年かかっていた研究開発期間を数週間に短縮した事例や、翻訳プラットフォームのDeepLがウェブ全体の翻訳処理時間を90%削減した実績が示されています。
デスクトップから超巨大ラックへ:「DGX Spark」と次世代「Vera Rubin」
システム規模の両極端に向けたポートフォリオ展開も明示されました。パーソナルな開発環境に向けては、データセンター級の処理性能をエンジニアの手元に届ける卓上型筐体「DGX Spark」が紹介されました。ジェンスン・フアンCEOが片手で掲げられるコンパクトなフォームファクタであり、オフィス環境でのローカルモデル開発を支援します。
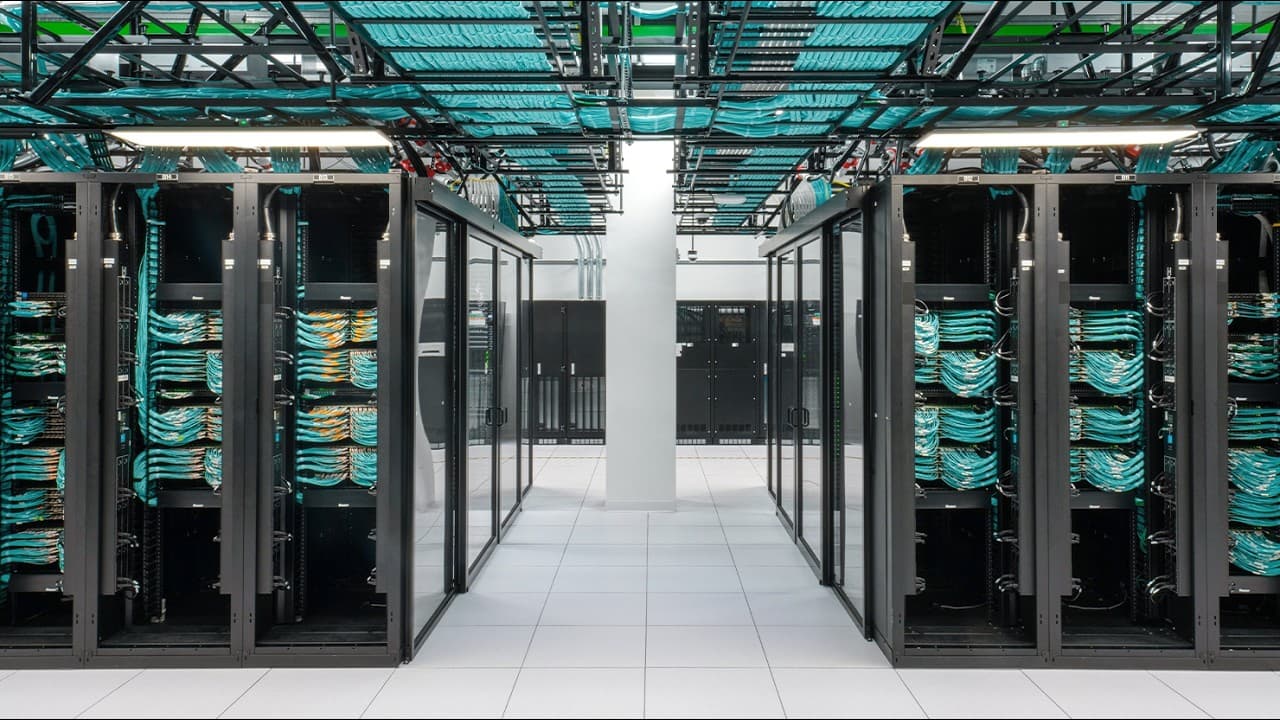
一方、データセンターの中核に向けては、次世代アーキテクチャ「Vera Rubin」に基づくラック規模システムが提示されました。高密度に積載されたコンピュートトレイと高度な配線設計により、推論処理にかかるトークンあたりのコストを最大10分の1に圧縮します。自律型AIエージェントがリアルタイムで大量の推論処理を繰り返す時代において、経済合理性を確保するための基幹インフラとなります。
データセンター全体を1つのコンピュータにする「NVIDIA DSX Platform」
映像の終盤では、データセンター全体の監視と運用を統合する「NVIDIA DSX Platform」の全体アーキテクチャ図が公開されました。単にサーバーを並べるのではなく、受電設備、冷却配管、ネットワークトポロジー、運用ソフトウェアスタックを完全に一体化させる構想です。
公開されたスライドでは、Siemensなどの産業ソフトウェアや各種CAD/CAEツール、Omniverseを用いたデジタルツインシミュレーションとの連携フローが図示されました。冷却水温度や消費電力をラック単位でリアルタイム監視するUI画面も映し出されており、施設インフラ(Facility)からAIアプリケーション層までを一気通貫で設計する「AIファクトリーの完成形」が提示されています。
性能・ベンチマーク
動画内で言及された主な性能指標および稼働実績は下表の通りです。一部の数値は過去のマイルストーン比較として提示されています。
| 評価指標・マイルストーン |
測定条件・システム構成 |
記録・削減幅 |
出典 |
| ImageNet学習完了時間 |
Meta FAIR Lab(2017年、初期DGXクラスタ) |
1時間で完了 |
動画内(0:55) |
| TOP500 スパコンランキング |
Eos NVIDIA DGX SuperPOD(H100 4,608基構成) |
世界第9位(121.40 PFLOPS) |
動画内スライド(1:34、2023年11月リスト) |
| ウェブ翻訳処理時間 |
DeepL(DGX基盤への移行後) |
90%削減 |
動画内(2:34) |
| 創薬R&Dサイクル |
Eli Lilly & Company(DGX SuperPODによる分子設計) |
数年単位から数週間単位へ短縮 |
動画内(2:17) |
| 推論トークン処理コスト |
NVIDIA Vera Rubin ラック規模システム |
最大10分の1に低減(10x reduction) |
動画内(2:57) |
| インフラ展開リードタイム |
DGX SuperPOD ターンキー導入 |
数カ月〜数年から「数日〜数週間」へ短縮 |
動画内(1:22) |
競合サービスとの比較
AIスーパーコンピューティング基盤の領域における主要ベンダーの取り組みと、NVIDIA DGXプラットフォームの特徴を比較します(競合側の仕様は編集部注)。
| 項目 |
NVIDIA DGX / SuperPOD |
Google Cloud TPU Pods(編集部注) |
AWS UltraClusters(編集部注) |
| システム形態 |
オンプレミス・コロケーション・クラウド(DGX Cloud)に対応 |
主にGoogle Cloud内部でのマネージド利用 |
AWS(EC2 P5/Trainium)内部でのインスタンス利用 |
| インターコネクト |
独自NVLink(超低遅延・広帯域共有メモリ)+InfiniBand |
独自の光回線スイッチ(OCS)を用いた2D/3D Torus |
独自EFA(Elastic Fabric Adapter、最高3.2Tbps) |
| ソフトウェアスタック |
NVIDIA AI Enterprise、CUDA、TensorRT等で完全標準化 |
JAX、TensorFlow、PyTorch(XLA経由)に最適化 |
AWS Neuron SDK、標準Linux/EKSベースの環境 |
| 展開の柔軟性 |
アプライアンス、ラック、データセンター設計図として自社導入可能 |
自社施設導入は不可(クラウドAPI経由の利用が前提) |
自社施設導入はOutposts等に限定され超大規模クラスタはクラウド前提 |
| 強み |
業界標準のCUDAエコシステムと圧倒的なソフトウェア資産 |
TPU v5p等の高い電力効率と低コストな学習環境 |
既存のAWSエンタープライズ基盤・S3・IAMとの密接な統合 |
| 弱み |
導入コストおよび設備投資(電力・水冷対応)が極めて高額 |
Google Cloud環境にロックインされる点 |
ハードウェア・ドライバ層の細かなチューニング自由度が制限される点 |
エヌビディアの優位性は、ハードウェア単体にとどまらず、受電・冷却からランタイムライブラリまでを一貫して提供する垂直統合モデルにあります。他社クラウドの独自ASICと比較して、オンプレミスからマルチクラウドまで同一アーキテクチャで稼働できるポータビリティが最大の強みです。
料金・提供プラン
動画内において、具体的な製品価格、ライセンス料、クラウド利用料金に関する直接的な言及はありませんでした。動画内で示された各コンポーネントの提供形態は以下の通りです。
- NVIDIA DGX-1 / DGX H100 / DGX B200: ハードウェアアプライアンスとしての販売、および正規パートナー経由での提供(一般提供中)。
- NVIDIA DGX SuperPOD: 事前検証済みリファレンスアーキテクチャとしての提供、およびエンタープライズ向けターンキー導入パッケージ(一般提供中)。
- DGX Spark: デスクトップ向け小型AIシステム(動画内で実機筐体を提示、詳細な提供時期・価格は未公表)。
- NVIDIA Vera Rubin ラック規模システム: 次世代アーキテクチャに基づく将来製品(動画内では開発ロードマップとしての提示、提供時期は未公表)。
なお、DGXシステムをオンプレミスで導入する場合、一般的にハードウェア本体に加えて「NVIDIA AI Enterprise」ソフトウェアライセンスおよびサポート契約が必要となります(編集部注)。
日本から使う方法
日本国内の企業や研究者がNVIDIA DGXプラットフォームの計算リソースを活用するための具体的なアプローチは以下の通りです。
- 国内正規販売代理店経由での導入
- マクニカ、菱洋エレクトロ、ネットワンシステムズなどの国内エヌビディア正規代理店(Elite Partner)へ問い合わせを行います。
- 電源設備(単相/三相、受電容量)や空調・床耐荷重の事前サーベイが必要です。特に近年の高密度ラックでは水冷設備(CDU)の導入要件を確認する必要があります。
- 国内クラウド・データセンター事業者のDGX環境の利用
- さくらインターネット(高火力インフラ)、ソフトバンク、NTT Comなどが提供する国産AIクラウド基盤を利用することで、初期設備投資を抑えてDGXクラスタへアクセスできます。
- NVIDIA DGX Cloudの契約
- 主要パブリッククラウド(Azure、AWS、Google Cloud、Oracle Cloud)上でNVIDIAが直接運用する「DGX Cloud」インスタンスを契約します。
- ウェブコンソールから直接クラスタをプロビジョニングでき、数時間以内に最新のDGX環境でジョブを実行できます。
- 利用上の注意点
- 最上位クラスタの調達には数カ月以上の納期を要する場合があります。
- 自社導入を検討する際は、データセンター側の受電容量(1ラックあたり数十kW〜100kW超)を事前に確保してください。
誰にどう効くのか
エンジニア・研究開発担当者への実務インパクト
環境構築やドライバの非互換性に起因するトラブルから完全に解放されます。NVLinkによる巨大な単一メモリ空間を活用できるため、テンソル並列やパイプライン並列の設計負荷が劇的に下がります。最新のBlackwellや次世代Vera Rubin環境では、コンテキスト長の制限を意識せずに大規模エージェントの検証を進められるようになります。
企画・マーケティング・事業開発担当者への実務インパクト
自社専用の基盤モデル開発やドメイン特化型エージェントの商用化スケジュールを大幅に前倒しできます。これまでPoC段階で数カ月を要していた学習・ファインチューニングが数日から数週間で完了するため、市場投入までのリードタイムが短縮されます。翻訳やコンテンツ生成の現場では、DeepLの事例のように推論スループットが大幅に向上し、エンドユーザーへのサービス応答性が改善します。
経営層・CIO・CTOへの実務インパクト
次世代システムにおける「推論コスト10分の1」の実現は、生成AI事業の損益分岐点を根本から変滅させる要因となります。エージェンティックAIが日常業務で数億回呼び出される運用フェーズにおいて、トークンあたりの計算コスト削減は営業利益率に直結します。また、DGX SuperPODによる規格化された導入手法を採用することで、自社AIデータセンターの構築リスクと減価償却計画を予測可能な範囲に収めることが可能になります。
まとめ
エヌビディアのDGXは、個別の高性能サーバーからデータセンター全体を統合する「AIファクトリーの青写真」へと進化を遂げました。今後はエージェンティックAIの普及を見据え、推論コストを桁違いに削減するVera Rubin世代への移行が焦点となります。自社のAI戦略を担う技術責任者は、現行インフラの受電・冷却要件を再点検しつつ、ラック規模アーキテクチャの導入に向けたロードマップ策定に着手すべきです。