何が変わったのか
AIは大きくなり、長い文章も扱うようになりました。そのぶんメモリ(作業場所)の取り合いが激しくなっています。NVIDIAは、重みを小さくする、文脈を保存領域へ逃がす、検索の索引をメモリの外に置く、の3つの方法で対応するとしています。
数字には条件があり、毎秒125トークンというユーザー1人あたりの速さと、特定の作業量での比較です。日本での提供や料金は、まだ発表されていません。
個人がすぐ使える製品ではありません。AI利用料の変化を見るために、提供元の発表を待つとよいでしょう。
11/6時点の判定。発表内容をもとにAIで判定しています。最新の提供状況は公式情報をご確認ください。
AIを動かすGPUの高速メモリ(HBM)は量も価格も厳しくなっていますが、NVIDIAはHBMを増やすより使い方を変える方針を示しました。Vera Rubin NVL72は、GB300 NVL72に比べて1ドル当たりの処理量が最大30倍とされ、GPUあたりのHBM容量は約3%の増加にとどまります。日本での提供や料金はまだ発表されておらず、一般の利用者が今すぐ変えることはありません。
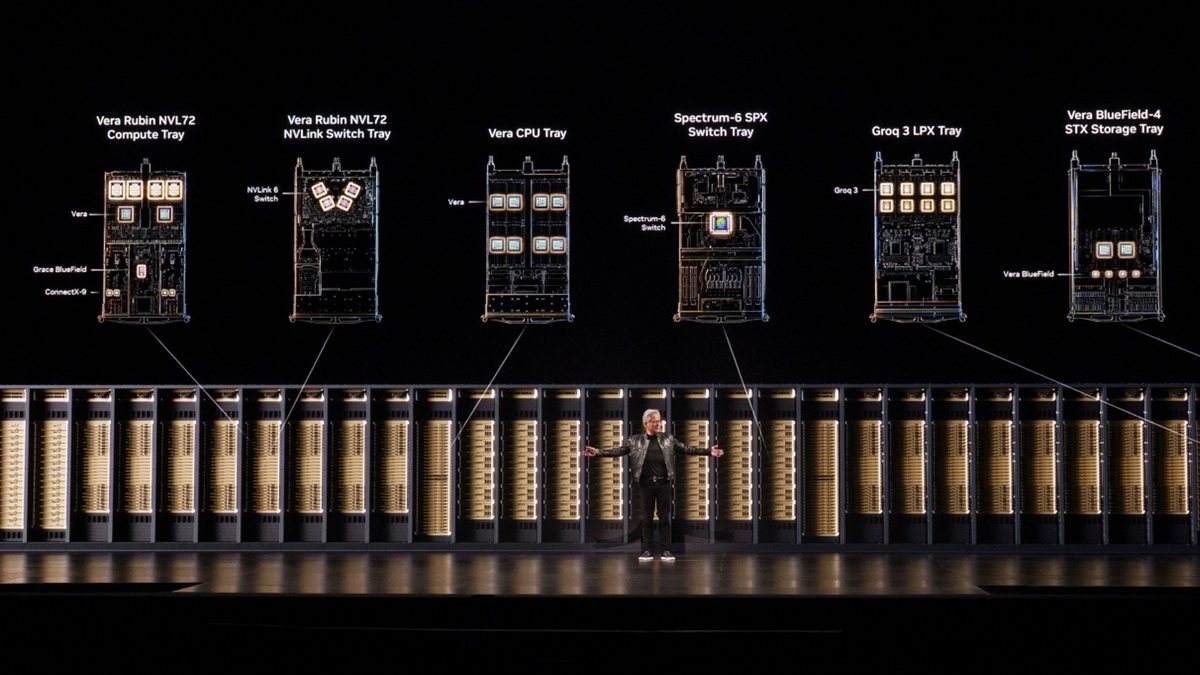
画像:NVIDIA(公式発表より)
要約版:専門用語を控えて説明しています
AIは大きくなり、長い文章も扱うようになりました。そのぶんメモリ(作業場所)の取り合いが激しくなっています。NVIDIAは、重みを小さくする、文脈を保存領域へ逃がす、検索の索引をメモリの外に置く、の3つの方法で対応するとしています。
数字には条件があり、毎秒125トークンというユーザー1人あたりの速さと、特定の作業量での比較です。日本での提供や料金は、まだ発表されていません。
AIを業務で使う企業や、AIを動かすデータセンターを運営する人にとって、GPUのメモリの量と値段は費用に直結します。個人の利用者が今すぐ変えることは、今回の発表にはありません。
NVIDIAの公式ブログは、この課題への答えとして「フルスタック共同設計」を挙げています。フルスタック共同設計とは、GPU・CPU・ネットワーク・保存装置・ソフトウェアを一体で設計する考え方です。メモリ1つあたりの仕事量を増やします。
NVIDIAは、HBM(GPUのすぐ近くにある、速いが高価なメモリ)を単純に積み増すのではないと説明しています。
AIモデルは大きくなり、長い文章を扱い、道具を次々に呼び出すエージェント型のAIも増えています。ブログは、この流れでGPUのHBMに対する負荷が高まっていると述べています。
HBMの供給は逼迫し、価格も上がっています。ブログによると、この傾向は当面続くとみられています。
HBMに置かれるものは、大きく2つあります。1つはモデルの重み(AIが学習した結果の数値)、もう1つはKVキャッシュ(AIが会話の文脈を覚えておく一時的な領域)です。どちらもHBMを奪い合っています。
ブログは、HBMの容量を増やすだけでは効果が頭打ちになると説明しています。倉庫(HBM)を広げても、出入口(メモリ帯域)の処理能力が足りなければ、荷物の出し入れが遅くなります。これを「メモリの壁」と呼びます。
そこでNVIDIAは、重み・文脈・検索の索引の3つで工夫を重ねるとしています。まずは重みです。
4ビットの数値形式「NVFP4」を使うと、8ビットのFP8より重みが小さくなると説明しています。NVFP4で公開されたモデルとして、FLUX.2 [klein]やMeta Muse Sparkなどの名前も挙がっています。
さらに、72基のGPUを1つにまとめた「NVL72」という構成では、重みを最大72基に分けて持たせられます。1基あたりの持ち分が減り、空いたHBMを文脈や同時に使う利用者に回せます。
次に文脈です。KVキャッシュにもNVFP4を使うと、FP8より小さくなり、HBMに多くの文脈を残せます。使っていない文脈は、保存領域へ移します。
ブログは、推論を動かすソフト「NVIDIA Dynamo」が、文脈専用の保存領域「CMX」へ移し、再利用の直前に戻すと説明しています。CMXはサーバーをまたいで共有でき、企業向けストレージのような長期の保存機能は省いているとしています。
対応パートナーには、Dell TechnologiesやHPE、NetAppなどが挙がっています。Vera CPUのLPDDRメモリも、CPUとGPUを高速につなぐ接続「NVLink-C2C」を通じて、止まっている文脈の待機場所になるとしています。
最後は検索です。社内文書を探すRAG(検索で得た情報をAIに渡す仕組み)では、文書を「埋め込み」(意味で検索するための数値表現)にして索引を作ります。
ブログは、NVIDIA Nemotron Retrieverモデルが、より小さな埋め込みで高い検索精度を出すとしています。索引はHBMの外に置き、必要な段落だけをAIの文脈に入れます。
ブログは、SemiAnalysis AgentXのDeepSeek V4 Proという作業で測った結果を示しています。
HBM容量の伸びは小さいのに、処理量は大きく伸びています。ブログは、AIデータセンターで大事なのは、応答時間の条件を満たしながら電力の範囲で何トークンを届けられるかだと述べています。
電力1ワットあたりの毎秒トークン数が増えれば、同じ電力でより多くの仕事を処理できると説明しています。
Vera Rubin NVL72は、サイソクが10月26日に報じたGTC Berlinの発表で取り上げた計算基盤です(GTC Berlinの発表記事)。
編集部の見方では、30倍という数字は、ユーザーあたり毎秒125トークンという条件と、AgentXの特定の作業量で比べた値です。条件が変われば数字も変わります。自社の使い方に当てはめる前に、同じ条件での比較を確かめるとよいでしょう。
 同じ話題の記事一部提供NVIDIAの
前日に出た記事から大きな発表を選び、1本2行でまとめてメールで届けます。無料・いつでも解除できます。
主要企業の大きな発表だけ、1日4回まで。夜22時〜朝7時は鳴らしません。いつでも解除できます。
本記事は公式発表の文章をもとにAIが要約・解説して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元記事を読む制作方法と事実確認の手順は編集方針をご覧ください。誤りのご指摘はお問い合わせから受け付けています。
NVIDIAがGTC Berlin 2026で発表した次世代計算基盤「Vera Rubin NVL72」、安全基盤「OpenShell」、AI端末「RTX Spark」、2027年提供予定の人型ロボットなどの主要トピックを解説します。
OpenAIが「National Community Compact」と政策提言を公表。電気代の全額負担、水・騒音の公開、秘密保持契約の不使用を約束。ジョージア州の1,000MW需要削減合意など具体例も整理します。
NVIDIAがオープンソースの「NVIDIA Recovery」を紹介。分散AI学習の停止を検知し、問題ノードを除外して再開させます。Slurm対応、監視モードから導入でき、検知は平均69秒です。
GTC Berlinの討論で、TenneT・Bayernwerk・Siemens Energyが電力網のAI活用を紹介。100万か所を超える再エネ設備の接続、年120億ユーロの投資、鉄塔の放火を受けて作った監視システム「GridSecure」、変圧器のデジタルツインを整理します。