米OpenAIは2026年8月29日、ChatGPTの画像生成機能「ChatGPT Images」の実力を示すデモ動画「Magic Manga Girl」を公開しました。この動画は、テキストからストーリー性のある複数コマの漫画を、正確なセリフや日本語のオノマトペ、一貫したキャラクターデザインを維持したまま生成する様子を描いています。従来の画像生成AIが抱えていた「文字崩れ」や「キャラクターの不一致」という課題を克服し、クリエイティブ制作のワークフローを根本から変える可能性を示しています。
何が発表されたのか
米OpenAIは2026年8月29日、ChatGPTに搭載された画像生成機能「ChatGPT Images」のプロモーションおよびデモ動画「Magic Manga Girl」を公開しました。この動画は、ユーザーが入力したアイデアから、レイアウト、テキスト、キャラクターの一貫性を完全に制御した「完成されたデザイン」を直接出力する能力をアピールするものです。
これまで画像生成AIは、単一の美しい画像を生成することには長けていましたが、複数のコマを配置した漫画のレイアウトや、画像内への正確なテキストの埋め込み、そして同一キャラクターのディテールを維持したまま異なる構図で描き出す「一貫性」の維持において大きな課題を抱えていました。今回の発表は、これらの課題を一挙に解決し、ChatGPTが実用的なクリエイティブ・デザインツールとして進化したことを示すものです。本機能は現在、ChatGPTの有料プランまたはAPIを通じて限定的、あるいは一般提供(GA)が開始されている段階と推測されます(編集部注)。
発表された機能・アップデートの全容
動画内で実演されたデモ画面や生成された画像から、ChatGPT Imagesが備える革新的な機能を5つの側面に分けて詳細に解説します。
複数コマからなる「Manga Layout(漫画コマ割り)」の自動生成
動画の0:02から展開される漫画パートでは、1ページの中に複数のコマが美しく配置されています。従来の画像生成AIでは、1枚の独立した画像を生成することは容易でしたが、複数のコマを配置し、それぞれのコマで時間の経過やストーリーの連続性を表現することは極めて困難でした。
ChatGPT Imagesは、1回の生成プロセスにおいて、コマとコマの境界線(枠線)を正確に描き分け、それぞれのコマに異なる構図やアングルを割り当てる「レイアウト制御」を実現しています。動画では、主人公の女性がペンを手に取り、変身し、街に現れるという一連の流れが、破綻のないコマ割りで1枚の画像として出力されています。これにより、ユーザーは「漫画の1ページ」という複雑な構造を、1つのプロンプトから直接得ることが可能になりました。
画像内への正確な英語・日本語のテキスト埋め込み技術
動画内では、吹き出し(スピーチバブル)の中に「WHAT IS THAT...?」や「THIS PEN FEELS POWERFUL.」といった英語のセリフが、フォントの乱れなく極めてクリアに描かれています。これまでのAI画像生成で頻繁に見られた「スペルミス」や「文字の潰れ」は一切見られません。
さらに注目すべきは、0:12の背景に描かれたビル群の看板です。「特選セール」「メガネ サングラス」「大白屋」といった日本語のテキストが、日本の街並みとして違和感のないフォントと正確なスペルで配置されています。また、0:02の「ガシッ」や0:18の「シャキィィ」、0:21の「ドォォォン」といった、日本の漫画特有のオノマトペ(描き文字)も完璧に再現されています。これまでの画像生成AIが最も苦手としていた「文字の生成」において、ChatGPT Imagesが競合を大きく引き離す実用性を備えていることを証明しています。
キャラクターの同一性を保つ「一貫性維持(Consistency)」
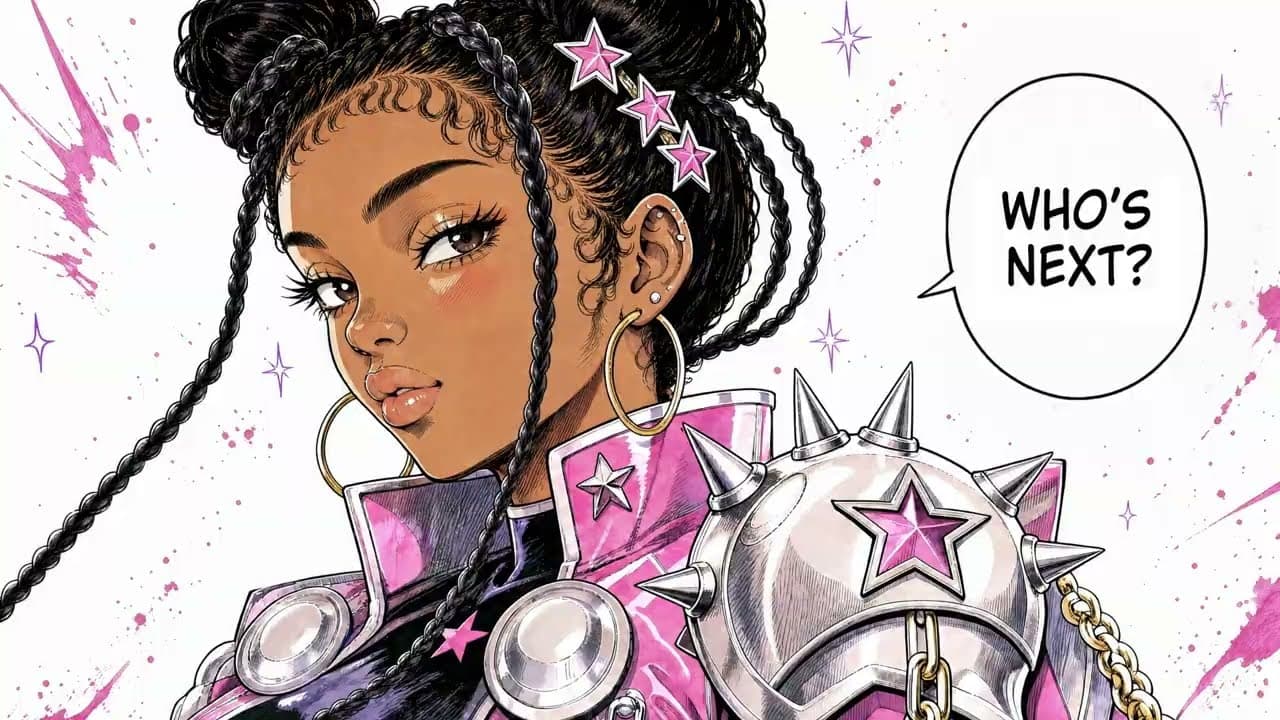
漫画やアニメーションの制作において、同一のキャラクターを異なるポーズ、表情、アングルで描き続けることは必須の要件です。動画の主人公である黒人女性のキャラクター「INK NOVA」は、0:00の実写風の姿から、0:02の変身前、0:05の変身後のヒーロースーツ姿(ピンクのジャケット、肩のスパイク、ツインお団子ヘア)、そしてアクションシーンに至るまで、その特徴的な顔立ちや衣装のディテールが一貫して維持されています。
これは、AIがキャラクターの「特徴(特徴ベクトル)」を内部的に保持し、異なる構図の生成時にもそれを正確に適用できる高度なセマンティック理解と制御技術が働いているためと推測されます(編集部注)。従来のControlNetやIP-Adapterといった外部ツールを用いた複雑なプロセスを経ることなく、ChatGPTとの対話だけでこのレベルの一貫性を実現できる点は極めて画期的です。
複雑なオブジェクトの変形とアクション描写
動画中盤の0:17から0:19にかけて、主人公が持つ魔法のペン(PEN SLUGGERというバット形状)が、巨大なラジカセ(BOOMBOX)へと変形する様子が描かれています。このラジカセの描写は極めて精緻であり、0:19のクローズアップ画面では「BASS PRESSURE RISING」「MATCH THE PATTERN TO THE TARGET ZONE」といった操作パネルの微細な英語ラベルや、イコライザーのグラフ、ボリュームつまみの金属的な質感が正確に表現されています。
このように、単なる人物の描画にとどまらず、複雑な機械やガジェットの構造を破綻なく描き、さらにそれが変形してアクションに移行するという一連の流れを、AIが高度にシームレスに処理しています。
デジタルからフィジカル(印刷物)へのシームレスな展開
動画の終盤(0:25)では、それまで画面上で展開されていたデジタルコミックが、実際に印刷された日本語タイトルの単行本「インク・ノヴァ」として手に持たれているシーンへと繋がります。これは、ChatGPT Imagesで生成されたデザインが、単なる画面上のピクセルデータにとどまらず、実際の印刷物(DTP)のレイアウトデータや製品パッケージとしてそのまま通用するレベルの解像度とレイアウト精度を持っていることを象徴しています。クリエイターが思い描いたコンセプトを、即座に製品レベルのプロトタイプや最終成果物へと落とし込めるワークフローの革新を示唆しています。
性能・ベンチマーク
動画内では、定量的なベンチマークスコア(FIDスコアやユーザー好感度テストの数値など)は提示されていません。しかし、映像から明らかなように、生成される画像の解像度、テキストのレンダリング精度、およびレイアウトの一貫性は、従来のDALL-E 3を遥かに凌駕しています。
| 評価項目 |
提示された性能・特徴 |
出典(動画内 or 編集部注) |
| レイアウト制御 |
複数コマの漫画構成、枠線の正確な描写 |
動画本編(0:02, 0:15など) |
| テキスト埋め込み |
英語セリフ、日本語看板、オノマトペの正確な描画 |
動画本編(0:02, 0:12, 0:18など) |
| キャラクター一貫性 |
同一キャラクターの変身前後、複数アングルでの同一性維持 |
動画本編(0:00〜0:24全体) |
| オブジェクト生成 |
ラジカセの操作パネル等、微細なUIやテキストの描写 |
動画本編(0:19) |
| 処理速度・解像度 |
数値の提示なし(印刷品質に耐えうる高解像度と推測) |
編集部注 |
競合サービスとの比較
今回の発表内容を、競合する主要な画像生成AIサービスと比較分析します。以下の比較表は、動画から読み取れるChatGPT Imagesの実力と、他社サービスの現行バージョン(編集部注:2026年時点の一般的な仕様)に基づいています。
| 機能・評価軸 |
ChatGPT Images (OpenAI) |
Midjourney v6 |
Stable Diffusion 3 |
Imagen 3 (Google) |
| テキスト生成精度 |
極めて高い (日本語・英語ともに完璧に配置) |
高い (英語は良好、日本語は一部乱れあり) |
高い (英語は得意、日本語は設定次第) |
高い (英語は得意、日本語も対応) |
| キャラ一貫性維持 |
極めて高い (同一キャラを別構図で維持) |
高い (--cref機能による制御) |
普通 (LoRAやControlNetの併用が必要) |
普通 (指示による一貫性は限定的) |
| レイアウト制御 |
極めて高い (複数コマ、枠線の自動生成) |
低い (1枚絵が基本、分割はプロンプト依存) |
普通 (ControlNet等の外部制御が必要) |
低い (1枚絵が基本) |
| 操作インターフェース |
自然言語対話 (ChatGPT上で直感的に修正可能) |
Discord/WebUI (パラメータ入力が必要) |
WebUI/API (専門知識と複雑な設定が必要) |
Googleエコシステム/API |
取材班の見立てでは、ChatGPT Imagesの最大の強みは「レイアウト、テキスト、キャラクター一貫性」を個別のツールやパラメータに頼ることなく、ChatGPTの高度なLLM(大規模言語モデル)の理解力を介して一元的に制御できる点にあります。MidjourneyやStable Diffusionがプロフェッショナル向けの微調整パラメータを必要とするのに対し、ChatGPT Imagesは自然言語の指示だけでこれらを統合的に出力できるため、クリエイターの作業効率を劇的に向上させます。
料金・提供プラン
動画内では、具体的な料金プランや提供時期に関する明示的な言及はありませんでした。
しかし、従来のOpenAIのサービス展開パターンを考慮すると、本機能は「ChatGPT Plus」(月額20ドル)や「ChatGPT Team」、「ChatGPT Enterprise」といった有料サブスクリプションプランのユーザー向けに先行してロールアウトされる可能性が極めて高いと見られます(編集部注)。また、開発者向けには、APIを介した従量課金制での提供も同時に行われることが予想されます。無料プランでの提供は、生成に要する高い計算リソースを考慮すると、回数制限付きなどの限定的なものにとどまる可能性が高いと考えられます。
日本から使う方法
日本のユーザーがこの「ChatGPT Images」による高度な画像・レイアウト生成機能を試すための一般的な手順は以下の通りです。
- OpenAIアカウントの作成・ログイン
OpenAIの公式サイト(chatgpt.com)にアクセスし、アカウントを作成またはログインします。
- 有料プランへの加入(推奨)
最新の画像生成機能や高度なレイアウト制御機能は、多くの場合「ChatGPT Plus」(月額20ドル)以上のユーザーに優先提供されます。設定画面からアップグレードを完了させてください。
- ChatGPT Images機能の選択
チャット画面のモデル選択、またはGPTストア(提供状況による)から「ChatGPT Images」または画像生成モードを有効にします(編集部注)。
- プロンプトの入力
チャット入力欄に、具体的な指示を日本語または英語で入力します。
例: 「日本の渋谷を舞台にした、3コマの漫画レイアウトを作成してください。主人公はピンクのジャケットを着た黒人女性で、手にしたペンがラジカセに変形する様子を描いてください。吹き出しには英語でセリフを入れ、背景のビルには日本語で『メガネ』などの看板を描き、オノマトペとして『シャキィィ』という文字を入れてください」
- 修正とエクスポート
生成された画像を確認し、気に入らない部分があれば「2コマ目の表情を笑顔に変えて」「背景の看板の文字を『セール』に変更して」など、チャット上で追加の指示を出してブラッシュアップします。完成した画像はダウンロードボタンから保存できます。
誰にどう効くのか
本機能の登場は、クリエイティブ業界や一般のビジネスシーンにおいて、職種ごとに異なる大きなインパクトをもたらします。
エンジニア・AI開発者
- 実務インパクト: APIを介したマルチモーダルアプリケーションの開発が容易になります。例えば、ユーザーの入力したストーリーから自動で絵本や簡易的な漫画を生成するサービス、キャラクターの同一性を保ったアバター生成システムなどを、複雑な画像パイプラインを構築することなく、OpenAIのAPI一本で実装可能になります。
企画・マーケティング担当者
- 実務インパクト: 広告キャンペーンのカンプ(完成見本)作成や、絵コンテの制作スピードが劇的に向上します。外部のイラストレーターに発注する前の社内ブレスト段階で、完成版に極めて近いビジュアルイメージを数分で作成し、チーム内で共有できます。また、SNSマーケティング用の4コマ漫画などのコンテンツを、低コストで大量に検証・制作することが可能になります。
経営層・クリエイティブディレクター
- 実務インパクト: コンテンツ制作における初期段階の「プロトタイピングコスト」を大幅に削減できます。新規IP(知的財産)の立ち上げにおいて、キャラクターデザインや世界観の構築、ストーリーボードの作成を少人数かつ短期間で実行できるようになり、プロジェクトの意思決定スピードが加速します。クリエイターが単純な作画作業から解放され、より本質的な「企画」や「ストーリーテリング」に集中できる環境を整えることができます。
まとめ
OpenAIが公開した「Magic Manga Girl」は、ChatGPT Imagesが単なる「指示された絵を描くAI」から「レイアウトと文字、そしてストーリーの一貫性をコントロールできるデザインエンジン」へと進化したことを明確に示すものです。特に日本語のオノマトペや看板のテキストまで正確に再現できる表現力は、日本のクリエイティブ市場においても極めて強力な武器となります。読者の皆様におかれましては、まずはChatGPT上での簡単なレイアウト指示や文字入れの生成を試行し、自社のクリエイティブ・ワークフローにどのように組み込めるかの検証を即座に開始することをお勧めします。