音声認識の性能を比べる「Open ASR Leaderboard」に、英語の新しいアクセントのデータが加わりました。Hugging Face公式ブログが2026年11月6日に発表したもので、追加されたのはエジプト英語とナイジェリア英語です。
音声認識は、話した言葉を文字に変える技術です(編集部注:スマホの音声入力や会議の自動文字起こしで使われている仕組みです)。順位表は、同じ音声を各社のAIに聞き取らせ、その精度を並べて見せるものです。
読者に関係するのは、音声AIを仕事で使う人や、音声認識のサービスを選ぶ人です。音声認識を普段使わない人には、直接の変化はありません。
今回は、Liva AIというデータ提供会社との新しい協力によるものです。同社の非公開データで、英語のアクセントが2つ増えました。アクセントとは、同じ英語でも国や地域によって違う発音のくせのことです。
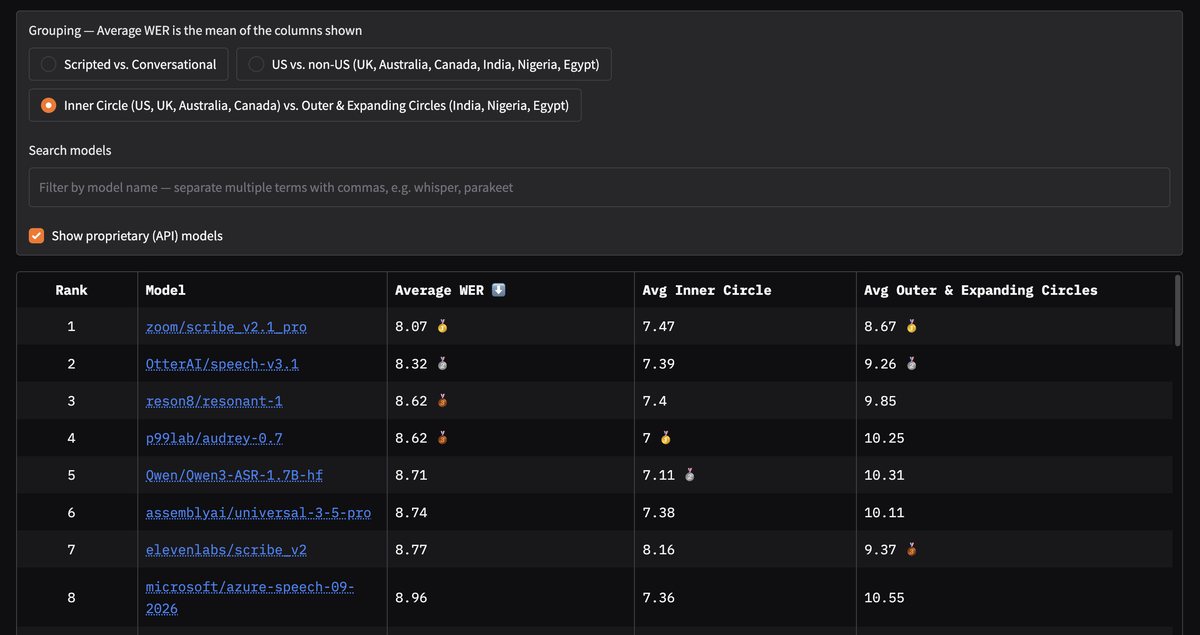
エジプト英語とナイジェリア英語の音声が加わった
追加されたデータは2種類です。エジプト英語(Egyptian)が1.34時間、ナイジェリア英語(Nigerian)が1.55時間で、どちらも自然な会話の音声を集めています。
文字起こしの決まりも、以前のデータと同じです。句読点をつけ、大文字と小文字を区別し、「えー」「あの」のような言いよどみも残します。きれいに整えた文章ではなく、実際に話された通りに近い形で採点する仕組みです。
以前の追加分は、Appen と DataOceanAI が提供した11の評価データでした。話し言葉と会話の音声で、5つのアクセントを扱っています。その後、インド英語を対象にした非公開データも1つ、Voice Arena から加わりました。今回の2つは、それに続くものです。
非公開データを増やしている理由は2つです。1つは、アクセントや言語の幅を広げ、評価の対象を実際の話し手に近づけるためです。もう1つは、テストの点数だけを上げる調整(ベンチマークマキシング)を減らし、評価の信頼性を高めるためです。そのため、データを提供する会社も増やしています。
Liva AIは、消費者が実際に使う製品を通じて、対話の音声などを集める会社です。製品の収集の場と配布の仕組みの両方を持っているため、普段の使い方の中で自然に出てくる話し方を集められると、同社は説明しています。テストのために作らせた話し方とは違うというのが、同社の考え方です。