何が発表されたのか
Hugging Faceのリサーチチームは、2026年7月9日にarXivで公開された論文「Weak-to-Strong Generalization via Direct On-Policy Distillation(直接オンポリシー蒸留による弱から強への汎化)」の技術解説を行いました。本研究は、計算コストが極めて高いことで知られるLLMの強化学習(RL)プロセスにおいて、小さなモデルで行ったRLの成果を、より大きなターゲットモデルに直接転送する手法「Direct-OPD」を提案するものです。研究段階の発表ですが、Hugging FaceのJournal Clubとして、リサーチャー自身が詳細なメカニズムと実験データを公開しており、オープンソースコミュニティにおけるLLMの効率的な訓練手法として極めて重要な位置づけにあります。
発表された機能・アップデートの全容
強化学習の計算ボトルネックを解消する「Direct-OPD」の基本コンセプト
LLMの推論能力を向上させるために、検証可能な報酬を用いた強化学習(RLVR: Reinforcement Learning with Verifiable Rewardsなど)が主流となっています。しかし、このプロセスは極めて高コストです。モデルの学習プロセスにおいて、現在のポリシーに基づいて大量の「ロールアウト(テキスト生成)」を行う必要があるためです。モデルの規模が大きくなるほど、1回ずつのロールアウト速度は低下し、RLのイテレーション全体が指数関数的に高価になります。
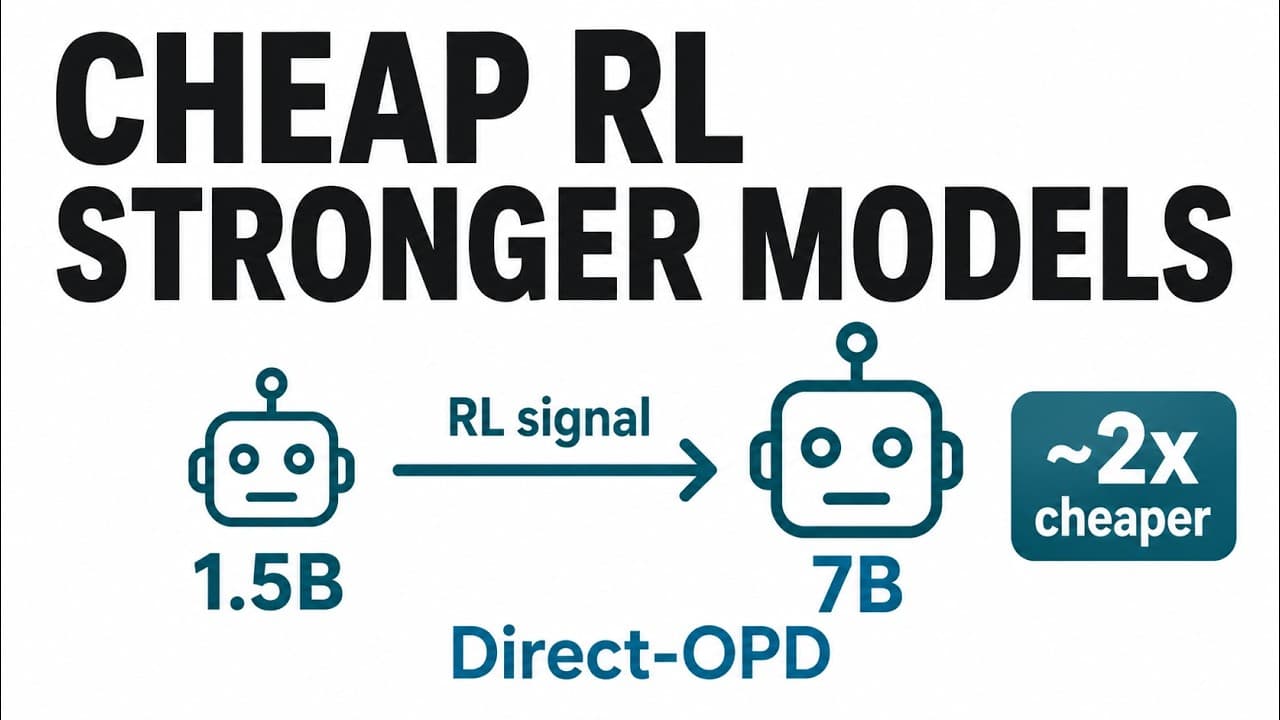
Direct-OPDはこのボトルネックを根本から解消します。本手法では、まず軽量で動作が高速な「小さなモデル」の上で強化学習を実行します。そして、その小さなモデルが得た「RLによるポリシーの変化(ポリシーシフト)」を、大きなモデルに直接転送します。これにより、大きなモデル上で直接高価な強化学習を実行することなく、同等以上の性能向上を達成します。
弱い教師から強い生徒へ:逆転の発想による「Weak-to-Strong Generalization」
従来の「知識蒸留(Knowledge Distillation)」では、大規模で高性能な「教師モデル」の知識を、軽量な「生徒モデル」に移植するのが一般的でした。しかし、Direct-OPDが取り組むのは「Weak-to-Strong Generalization(弱いモデルから強いモデルへの汎化)」という逆の構図です。
ここでは、強化学習を施した「小さなモデル」が教師となり、ベース性能がより高い「大きなモデル」が生徒となります。動画内での議論によると、ベースとなる生徒モデル(例:7Bモデル)は、初期状態ですでに教師モデル(例:1.5Bモデル)よりも高い基礎能力を持っています。Direct-OPDは、教師モデルの具体的な出力内容をそのまま模倣させるのではなく、強化学習によって教師モデルが「どのように振る舞いを変えたか」という方向性(ポリシーシフト)のみを抽出して生徒モデルに適用します。これにより、生徒モデル本来の優れた表現力を損なうことなく、強化学習の恩恵だけを効率的に取り込むことに成功しています。
暗黙的報酬を最大化する「Direct-OPD Objective」の数式モデル
Direct-OPDの核心は、教師モデルのポリシーシフトを「暗黙的(インプリシット)な報酬シグナル」として定式化し、生徒モデルの学習に利用する点にあります。動画の3分44秒付近で提示されたスライドでは、以下の目的関数(Objective)が示されています。
$$J_{Direct-OPD}(\theta) = \mathbb{E}{x \sim p{data}} [ \mathbb{E}{y \sim \pi\theta(x)} [ \Delta_T(y|x) ] ] - \beta D_{KL}(\pi_\theta(x) || \pi_{ref}(x))$$
ここで、ポリシーシフトを表す $\Delta_T(y|x)$ は以下のように定義されます。
$$\Delta_T(y|x) = \log \pi_{teacher}(y|x) - \log \pi_{teacher_ref}(y|x)$$
これは、強化学習後の教師モデル($\pi_{teacher}$)と強化学習前の教師モデル($\pi_{teacher_ref}$)の対数確率の差分です。生徒モデル($\pi_\theta$)は、この差分を報酬として最大化するようにオンポリシーで訓練されます。同時に、生徒モデルが自身の初期ポリシー($\pi_{ref}$)から離れすぎないよう、KLダイバージェンス($D_{KL}$)による制約(ペナルティ)が課されます。この洗練された設計により、明示的な報酬モデルを別途用意したり、不安定な報酬設計に悩まされたりすることなく、安定したポリシー転送が可能になります。
8台のA100でわずか4時間:劇的な計算コスト削減の実証
動画の7分19秒付近では、Direct-OPDがもたらす圧倒的な計算リソースの削減効果が具体的な数値とともに示されました。1500ステップの強化学習を実行する場合、7B(70億パラメータ)クラスのモデルに対して直接RLを行うと、32台のNVIDIA A100 GPUを使用しても約320時間という膨大な時間を要します。これに対し、1.5B(15億パラメータ)の軽量モデルで同様のRLを実行する場合、必要な時間は約160時間と半分に抑えられます。
そして、この1.5Bモデルから7BモデルへのDirect-OPDによるポリシー転送プロセスは、わずか8台のA100 GPUで約4時間しかかかりません。合計の計算コストは、1.5BのRL(160時間)と転送(4時間)を足した「164時間」となり、7Bモデルで直接RLを実行する場合(320時間)と比較して、計算コストをほぼ半減(約49%削減)させています。
ロールアウト長が与える影響と最適な「2kトークン」設定
動画の後半(12分51秒付近)では、モデルがテキストを生成する際の「ロールアウト長(レスポンス長)」が、Direct-OPDの学習安定性に与える影響についての詳細な検証(Figure 7)が紹介されました。研究チームは、ロールアウト長を512トークン、2k(2048)トークン、4k(4096)トークンの3パターンでスイープ(比較実験)を行いました。その結果、512トークンのように短すぎる設定や、4kトークンのように長すぎる設定では、学習プロセスにノイズが混入しやすく、検証精度(AIMEスコア)の推移が不安定になることが確認されました。
特に長すぎるロールアウトでは、モデルが冗長な生成を繰り返すことで、ポリシーシフトの平均値が薄まり、本質的な学習シグナルが失われる傾向にあります。これに対し、2kトークンの設定は、推論に必要な文脈を十分に保持しつつ、ノイズを最小限に抑えることができる「スイートスポット」であり、最も安定した高いパフォーマンスを示すことが明らかになりました。