ホーム / AI・テクノロジー / Hugging Face Hugging Face 2026/08/05
強化学習は鋭鋭化 」する Hugging Faceの研究チームは、大規模言語モデル(LLM)の推論能力向上における事前学習(Pre-training)と強化学習(RL)の定量的関係を明らかにした最新論文「Understanding Reasoning from Pretraining to Post-Training」の解説動画を公開しました。本研究は、チェスや数学を検証環境として用い、これまで個別に行われていた事前学習と強化学習の計算資源配分を統合する「共同スケーリング則」を世界で初めて定式化しました。これにより、限られた予算内で最終的な推論性能を最大化するための、革新的なモデル開発指針が示されました。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: Hugging Face Journal Club: Scaling Laws for Pre-training & RL
3秒でわかる要点 1 強化学習は新たな推論能力を創出せず、事前学習で得た潜在能力を「鋭鋭化(Sharpening)」して引き出す役割を持つ2 事前学習の評価ロスと強化学習後の性能には、相関係数-0.9以上の極めて強い相関(共同スケーリング則)が存在する3 強化学習後の性能を最大化する場合、従来のChinchilla則よりも小さなモデルを過剰に事前学習する方が効率的であるこの記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
Hugging Faceの研究チームは、大規模言語モデル(LLM)の「事前学習(Pre-training)」と「事後学習(Post-training)」、特に強化学習(RL)の間の定量的な関係性を解明した研究論文「Understanding Reasoning from Pretraining to Post-Training(事前学習から事後学習における推論の理解)」についてディスカッションを行いました。本論文は、ニューヨーク大学やコロンビア大学などの研究者らによって2024年7月に発表されたものです(編集部注:arXiv IDは2407.16097)。
本研究は、これまで独立して議論されることが多かった「事前学習での計算資源の配分」と「強化学習での性能向上」の間に、明確な「共同スケーリング則(Joint Scaling Law)」が存在することを世界で初めて定式化しました。この研究は、LLMの推論能力を向上させるための強化学習が、モデルにどのような変化をもたらしているのかを科学的に解明した、極めて重要なマイルストーンです。
発表された機能・アップデートの全容
1. チェスをテストベッドとした「事前学習・SFT・RL」の統合パイプライン
研究チームは、モデルの推論プロセスを厳密に管理・検証するために、チェス(Chess)をテストベッドとして採用しました。チェスはルールが完全に定義されており、任意の盤面(状態)において「どの手が最善か」を、世界最強クラスのオープンソース・チェス思考エンジン「Stockfish」を用いて客観的に評価できます。これにより、モデルの出力に対する「検証可能な報酬(Verifiable Reward)」を完璧に設計することが可能になりました。
実験では、2000万(20M)から6億8000万(680M)パラメータまでの4つの異なるモデルサイズを用意し、以下の3段階で学習を行いました。
事前学習 :Lichess(オンラインチェスサーバー)から収集した、人間の対局データ(54億トークン)を用いて、次の一手を予測する自己回帰的な学習を実施。SFT(教師あり微調整) :事前学習済みモデルから、特定の盤面における指し手の軌跡(思考プロセスに相当)を複数サンプリングし、その中から最良の軌跡を「合成推論トレース(Synthetic Reasoning Traces)」として選択してファインチューニングを実施。RL(強化学習) :SFT後のモデルを初期ポリシーとし、Stockfishの評価を報酬シグナルとして、ポリシーをさらに最適化。
2. 強化学習(RL)の本質は潜在能力の「鋭鋭化(Sharpening)」であることの証明
本研究の最も衝撃的な発見は、「強化学習(RL)はモデルに新しい推論能力を授けるのではなく、事前学習フェーズですでに潜在的に獲得していた能力を引き出し、強化するプロセスに過ぎない」という事実を定量的に示した点です。
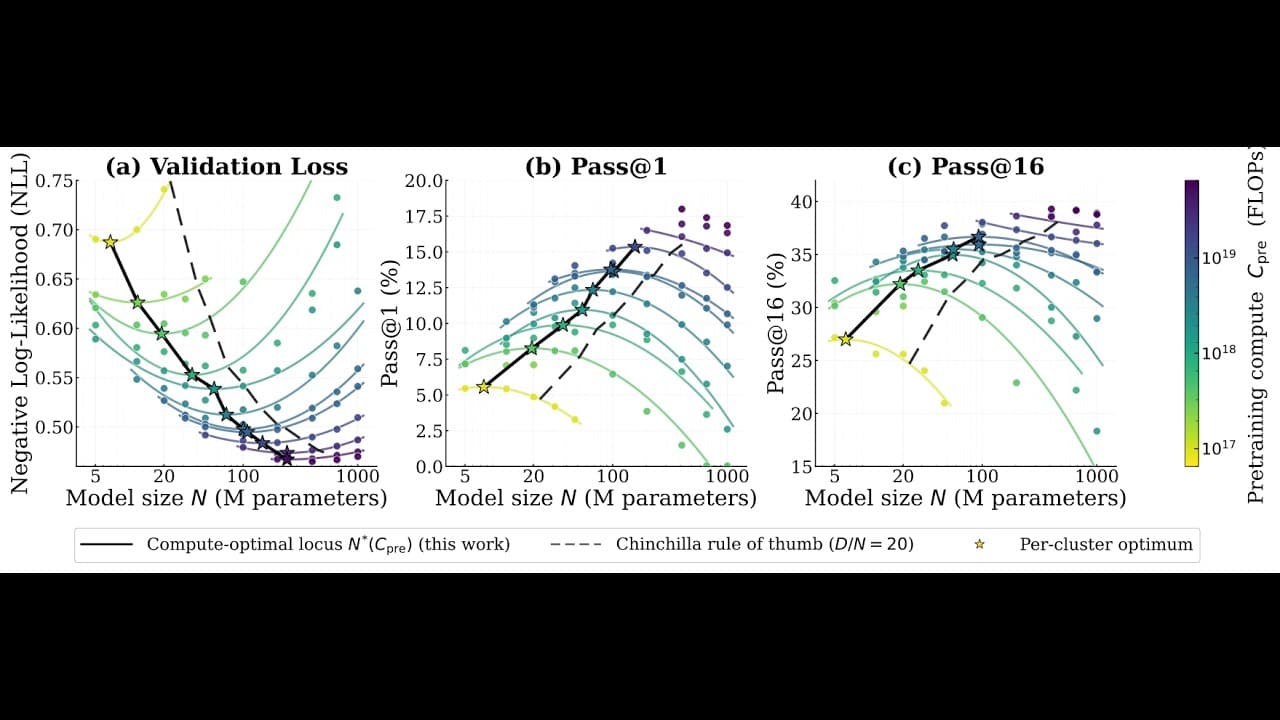
研究チームは、モデルがk回試行して1回でも正解に達する確率を示す「Pass@k」という指標を用いました。実験の結果、RLを適用すると、1回の試行で正解する確率である「Pass@1」は劇的に向上する一方で、16回試行時の正解率である「Pass@16」は、RLの前後でほとんど変化しないことが明らかになりました。これは、事前学習後のモデルが「潜在的には正しい答えを出力できる状態(Pass@16が高い状態)」にあれば、RLによってその出力確率を最上位に引き上げる(Pass@1を高める)ことができるものの、事前学習段階で全く解けなかった問題(Pass@16が0に近い状態)を、RLだけでゼロから解けるようにはならないことを意味しています。
3. 事前学習の検証ロスとRL後性能の「共同スケーリング則」の定式化
研究チームは、事前学習時の検証ロス(Validation Loss)と、その後のRL適用後のタスク達成率(Pass@1)の間に、極めて強い相関関係が存在することを発見しました。相関係数は-0.93から-0.99に達しており、事前学習のロスが低ければ低いほど、RLを適用した際の下流タスクの性能向上幅が指数関数的に大きくなることが示されました。
この関係性は「Joint Pretraining-RL Scaling Law」として数式化され、事前学習のロスから、将来的にRLを行った際の性能を極めて正確に予測することが可能になりました。これは、高性能な推論モデルを作るためには、事後学習のテクニックだけでなく、事前学習の「基礎体力(ロスの低さ)」を極限まで高めることが不可欠であるという、強いメッセージとなっています。
4. Chinchillaスケーリング則の再定義:RLを見据えたリソース配分
従来のLLM開発では、事前学習のロスを最小化するために「Chinchilla則」(パラメータ数Nに対して、およそ20倍のトークン数Dを学習させるのが最適とする法則)が広く使われてきました。しかし、この法則は「事後学習(RL)を行うこと」を前提に設計されていません。
本研究が提示した「IsoFLOPカーブ(同一計算予算における性能曲線)」によると、最終的にRLを適用して下流タスクを解かせる場合、限られた総計算予算(Total Compute Budget)のもとでは、Chinchilla則よりも「小さなモデルサイズを選択し、そのモデルをより多くのトークンで過剰に事前学習(オーバートレーニング)する」方が、最終的なRL後の性能(Pass@1)が高くなることが判明しました。これは、実務におけるインフラ投資やモデル開発の効率化において、極めて大きなインパクトを持つ発見です。
5. 数学ドメイン(OLMoモデル)における普遍性の実証
チェスという限定的なゲーム環境で得られたスケーリング則が、自然言語による複雑な人間的推論タスクにも適用可能であるかを検証するため、研究チームは数学ドメインでの追加実験を行いました。
実験では、オープンソースの10億(1B)パラメータLLM「OLMo」のチェックポイントを使用し、数学データセット「NuminaMath-CoT」を用いて追加の事前学習(ミッドトレーニング)と強化学習を適用しました。その結果、チェスでの実験と全く同様に、事前学習の評価ロスとRL後の数学パズル解決率の間に、美しい共同スケーリング則(Figure 6)が成立することが確認されました。これにより、本研究の知見が特定のタスクに依存しない、LLMの推論能力全般に適用可能な普遍的な物理法則であることが証明されました。
性能・ベンチマーク
以下は、チェスのパズルタスクにおいて、事前学習の規模(計算量)と、強化学習(RL)適用前後のPass@1(1回で正解する確率)およびPass@16(16回試行して1回でも正解する確率)の関係性を示したベンチマークデータです。
モデルサイズ
事前学習計算量 (FLOPs)
RL前 Pass@1
RL後 Pass@1
RL前 Pass@16
RL後 Pass@16
出典
20M $10^{16}$
約 3%
約 12% 約 25%
約 25%
動画内 Figure 2
20M $10^{17}$
約 8%
約 28% 約 42%
約 43%
動画内 Figure 2
200M $10^{17}$
約 12%
約 38% 約 52%
約 53%
動画内 Figure 2
200M $10^{18}$
約 25%
約 62% 約 78%
約 79%
動画内 Figure 2
このデータが示す通り、すべてのモデルサイズにおいて、RLを適用することで「Pass@1」は劇的に(数倍〜10倍近く)向上していますが、モデルの潜在能力の限界値を示す「Pass@16」はほとんど向上していません。これは、強化学習が「新しい解法を創造している」のではなく、「モデルがすでに知っている正しい解法の出力確率を極大化している」ことの強力な証拠です。
競合サービスとの比較
本研究の成果は、OpenAIの「o1」やAnthropicの「Claude 3.5 Sonnet」、Googleの「Gemini 1.5 Pro」といった、各社の「推論特化型モデル」の開発競争に直接的な光を当てるものです。各社の現在のアプローチと、本研究の知見を比較します。
評価項目
本研究の知見・アプローチ
競合推論モデル(OpenAI o1等)※編集部推定
比較分析
推論能力の獲得方法 事前学習で「潜在能力」を広く蓄え、RLでそれを「鋭鋭化」する。
大規模なRLと推論時計算(Test-time compute)の組み合わせ。
競合も同様に、推論時に思考トークン(CoT)を生成させて検証するRLを採用しており、技術的整合性が高い。
リソース投資の最適化 限られた予算では、モデルサイズを抑えて事前学習トークン数を増やす(オーバートレーニング)。
巨大なモデルサイズ(数百B〜数兆パラメータ)に膨大なデータを学習。
競合は潤沢な資金で巨大モデルを維持しているが、エッジAIやローカルLLM開発においては本研究の「小モデル+過剰事前学習」が極めて有利。
検証可能性の担保 チェスのStockfishや数学のコード実行など、検証可能な報酬(Verifiable Reward)に特化。
一般的な自然言語対話やプログラミング、複雑な科学的推論など、広範なタスクに対応。
競合は「報酬の定義が難しい曖昧なタスク」にもRLを拡張している点が優位だが、本研究は「検証可能」な領域での厳密な科学的アプローチを提供。
料金・提供プラン
本内容は学術研究論文の解説であるため、直接的な商用サービスの利用料金は存在しません。論文、実装コード、および学習に使用された一部のデータセットは、すべてオープンソースとして無償で公開されています。
ただし、実務で同様の実験やモデル開発を行う場合のインフラストラクチャの参考値として、論文内では以下の計算資源が使用されたことが明記されています。
ハードウェア :8基の「NVIDIA H100 Tensor Core GPU」(80GBメモリ搭載モデル)を使用。事前学習コスト :50M(5000万)パラメータモデルの学習において、約160 GPU時間(GPU hours)を消費。
日本から使う方法
日本のエンジニアや研究者が、本研究の成果を手元で再現、あるいは自社モデルの開発に応用するための具体的な手順は以下の通りです。
論文へのアクセス :
Hugging Faceの論文ページ(https://huggingface.co/papers/2407.16097)から、論文のPDFおよび関連ディスカッションにアクセスできます。公式GitHubリポジトリの利用 :
チェスのパズル検証環境や、強化学習(GRPO)のパイプラインコードは、GitHub(https://github.com/pavelshk/nv-puzzle-chess)で公開されています。リポジトリをクローンすることで、すぐに手元のGPU環境で実験を開始できます。データセットの取得 :
実験に使用された人間のチェス対局データはLichessから、数学の評価に使用されたデータは「NuminaMath-CoT」から取得可能です。いずれもHugging Face Dataset Hubから直接ダウンロードできます。
誰にどう効くのか
開発エンジニア・AIリサーチャーへのインパクト
強化学習(RL)を適用する前提での、事前学習の「止め時(Early Stoppingの判断)」や「モデルサイズの選定」に関する具体的な定量的基準が手に入ります。Chinchilla則に盲従するのではなく、事後学習のRLコストを逆算した「統合的なスケーリング設計」が可能になります。
企画・プロダクトマネージャーへのインパクト
「なぜ特定のタスクにおいて、RLを適用してもモデルの性能が頭打ちになるのか」という技術的限界を正確に理解できます。モデルの推論能力を向上させるためには、RLのチューニングだけでなく、ベースとなる事前学習モデルの選定(または追加のドメイン事前学習)が本質的であるというプロダクト設計の指針が得られます。
経営層・CTOへのインパクト
GPUクラウドやオンプレミスインフラへの投資対効果(ROI)を最大化できます。闇雲に巨大なパラメータ数のモデルを開発・運用するのではなく、パラメータ数を抑えて事前学習とRLを最適配分することで、インフラコスト(電気代、GPUレンタル代)を大幅に削減しつつ、同等以上の推論精度を持つ軽量高速なモデルを構築できます。
まとめ
本研究は、LLMの推論能力向上における強化学習(RL)の役割が「潜在能力の鋭鋭化」であることを科学的に証明し、事前学習とRLの最適なリソース配分を示す「共同スケーリング則」を提示しました。開発者は、従来のChinchilla則に縛られることなく、事後学習を見据えた「モデルサイズを抑えた過剰事前学習」という新たな戦略を採るべきです。まずは、公開されているGitHubリポジトリとHugging Faceのデータセットを用いて、自社ドメインにおけるスケーリング特性の検証から始めることを推奨します。
動画のタイムテーブル 0:00 導入:事前学習から事後学習における推論能力の理解と論文概要 1:00 実験設定:チェスをテストベッドとした3段階の学習パイプラインの解説 2:55 強化学習ステージ:検証可能な報酬(Stockfish)を用いたポリシー最適化 3:37 ベンチマーク分析:モデルサイズ別(20M〜680M)のPass@1とPass@16の挙動 5:15 主要なテイクアウェイ:事前学習ロスとRL後性能の定量的関係 6:10 スケーリング則の深掘り:モデルスケーリングとRL性能の相関関係 11:20 ドメイン拡張:数学ドメイン(OLMoモデル)における共同スケーリング則の成立検証 13:37 メカニズム分析:RLがポリシーの確率分布をどう「再配分」するかの解説 14:58 ディスカッション:実務への応用可能性と今後の研究課題 16:10 結論:事前学習とRLの最適な計算資源配分のまとめ 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)