bycloud
Xiaomi、1兆パラメータLLM
Xiaomiが1兆パラメータモデル「MiMo-V2.6」の強化学習(RL)プロセスと約347万ドルの訓練コストを公開。30ステップで性能を高めたAgentic RLの構成、リワードハッキング対策、蒸留モデルまで詳細に解説します。
TOPIC
強化学習 に関連するAI・テクノロジーの動画をAIが映像・音声ごと解析し、要点・数字・注意点まで日本語でまとめた記事が5 本あります。
Xiaomiが1兆パラメータモデル「MiMo-V2.6」の強化学習(RL)プロセスと約347万ドルの訓練コストを公開。30ステップで性能を高めたAgentic RLの構成、リワードハッキング対策、蒸留モデルまで詳細に解説します。
Hugging Faceが解説する新手法「Direct-OPD」は、小モデルの強化学習成果を大モデルに転送し、LLMの学習コストを劇的に削減します。AIMEベンチマークで高い成果を実証した革新的技術の全容を解説します。
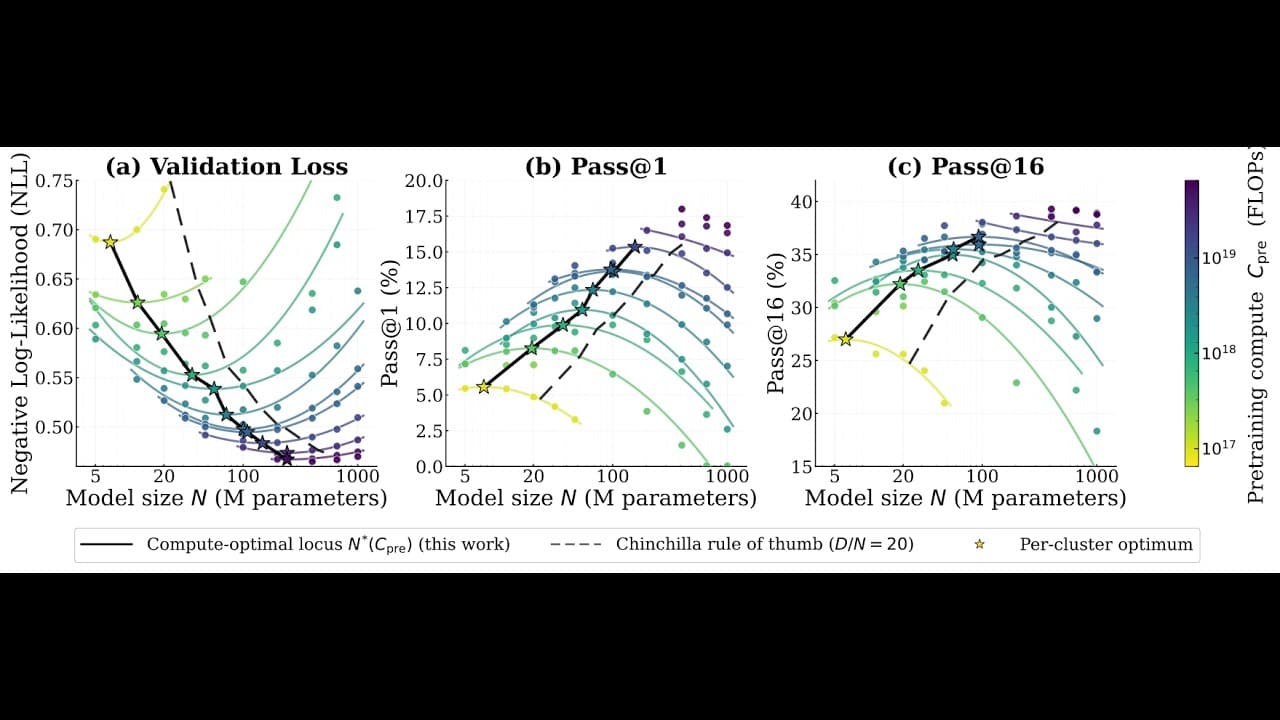
Hugging Faceが解説する最新論文により、強化学習(RL)はLLMに新たな推論能力を授けるのではなく、事前学習で得た潜在能力を「鋭鋭化(引き出し・強化)」するプロセスであることが判明。事前学習とRLの最適な計算資源配分を示す共同スケーリング則を解説します。
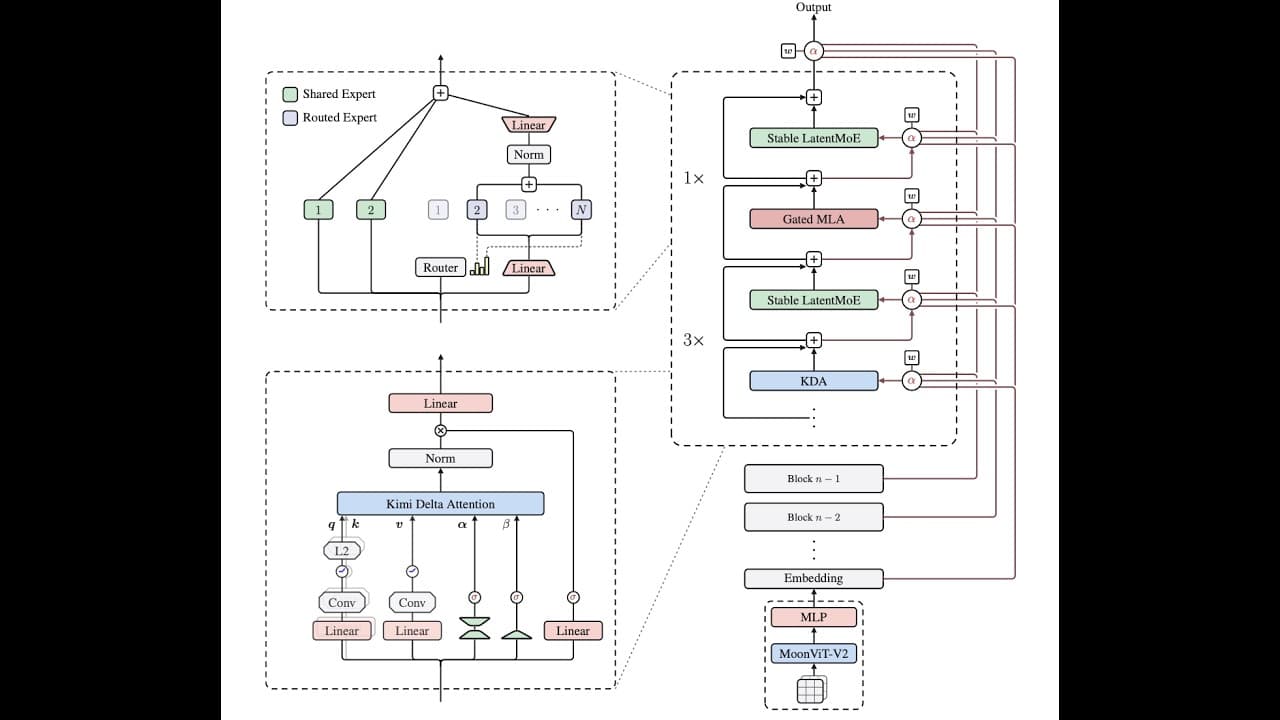
総パラメータ数2.8兆を誇るオープン重みMoEモデル「Kimi K3」の技術解説。100万トークン対応、推論コストを自己制御する強化学習、動的ルーブリック評価など、最先端AIの裏側をベテラン記者が解説します。
Hugging FaceがLLMエージェント向け強化学習手法「GRPO」の仕組みとTRLライブラリによる実装を解説。Critic不要の軽量な評価手法、リワードハッキング対策、訓練曲線の見方まで実践的に紐解きます。