要約版:専門用語を控えて説明しています
何をしたのか
Buffmeeは、本やウェブ記事など100以上の情報源をもとに答えるアプリです。AIが先に資料を探してから答える仕組みを、RAG(検索拡張生成)と呼びます。
回答の質を機械で採点する仕組みも作りました。根拠性スコア(回答が資料に沿っているかを示す点数)は25%上がりました。
もう1つは、AIへの指示文(プロンプト)が長くなりすぎて、返事が遅れていた問題です。指示文を機能ごとに分けて、必要な部分だけを読み込むようにしました。その結果、最初の文字が返るまでの時間は18%近く短くなりました。
自分のサービスで試すには
ADKはオープンソースで、Python、TypeScript、Go、Javaで使えます。Gemini Enterprise Agent Platform Evaluation Serviceで、回答の品質を測ることもできます。
AIアプリを使うだけの人は、今回の発表で操作や料金が変わることはありません。一方、自社の資料をもとに答えるAIを作る開発者には、応答を速くしながら答えの正確さを保つ手法が具体的に示されています。
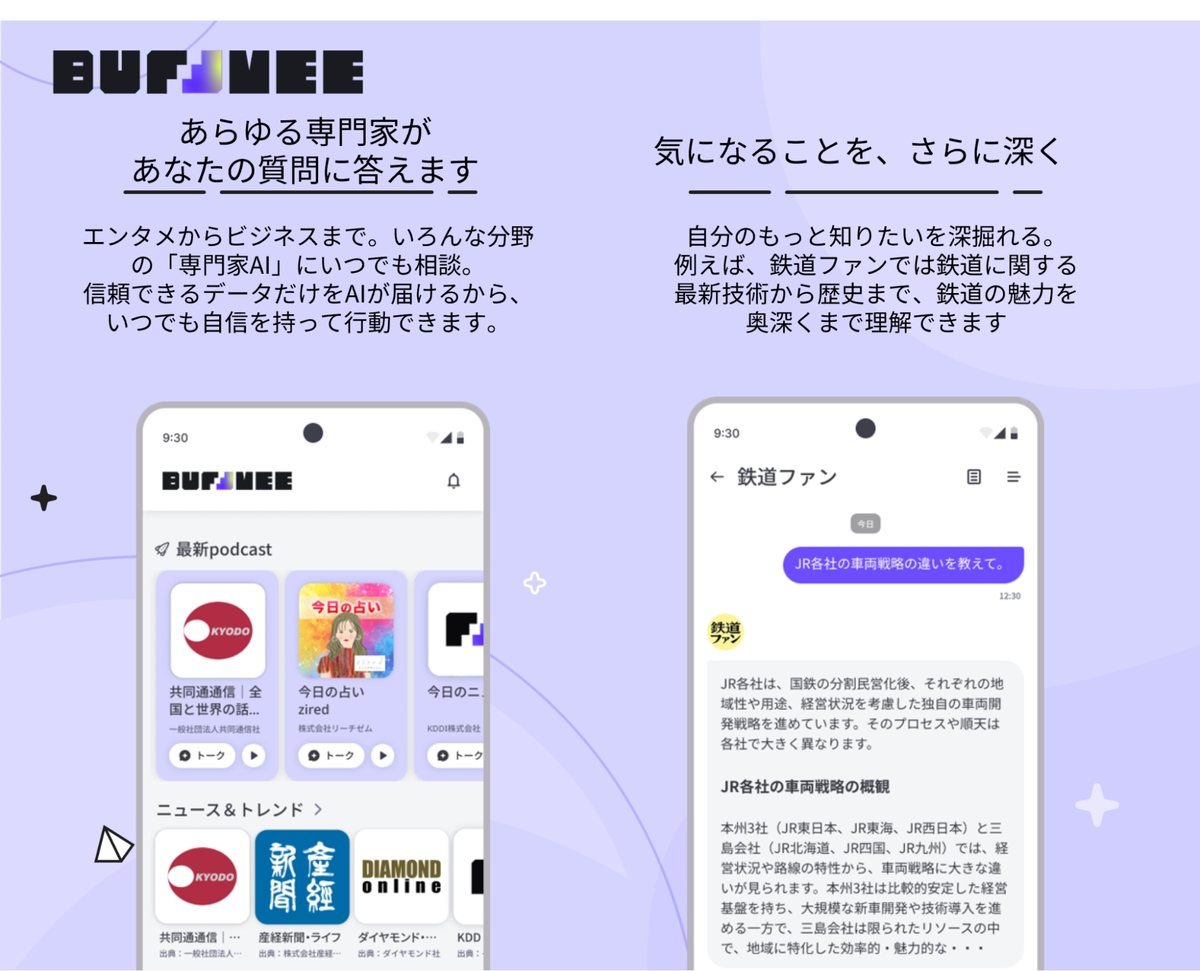
KDDIの「Buffmee」は、書籍・雑誌・ウェブメディアなど100以上のソースをもとに答える消費者向けのアプリです。AIが資料を探してから答える仕組みを、RAG(検索拡張生成)と呼びます。「成長をサポートするAI」という考え方で作られ、回答には情報源を引用します。
開発はKDDIアイレット、Google Cloud Consulting、KDDIの専門AIチームが組んで進めました。Google Cloud公式ブログの発表によると、最初の課題は、書籍や雑誌など形式の違うコンテンツを、AIの根拠(グラウンディング)として使える状態にすることでした。
 画像:Google Cloud(公式発表)
応答は38%速くなり、出だしも18%近く早まった
もう1つの課題は、応答の遅さ(レイテンシ)でした。目標の応答時間に届かず、ハルシネーション(AIがもっともらしい誤りを答えること)を減らす確かな方法も必要でした。
その後、アプリ全体の合計応答時間は38%減り、目標の応答性能を達成しました。最初のトークン(AIが文字を数える単位)が返るまでの時間(TTFT)も、18%近く改善しています。
回答が資料の根拠にどれだけ沿っているかを示す「根拠性スコア」は25%高まりました。(編集部注:根拠性スコアは、回答が資料に基づいているかを測る指標です。)
KDDIの小野田隼也氏は、目指したのは「すぐに RAG システムとして機能するプラットフォーム」だったと話しています。
人の目の確認を、自動評価に置き換えた
手動テストは手間がかかり、大量の資料に広げられませんでした。そこでチームは、評価の仕組みを組み直しました。使ったのは、Gemini Enterprise Agent Platform Evaluation Service(生成AIの出力を客観的に測るGoogleのツール)です。
このツールは、モデルの移行やプロンプトの編集、ファインチューニング(追加学習)の評価にも使えます(Google Cloudの公式ドキュメント、11/7確認)。
LLM-as-a-Judge(別のAIに回答を採点させる方法)などを取り入れました。数百の自動テストと、比べる基準になるベンチマーク用のデータセットも作りました。評価用のAIが回答を採点し、人が実際の回答を見て合格ラインを決めています。
信頼性を保つため、チームは4つの方法を使いました。
- 重要な指標は、1〜5の段階評価をやめました。代わりに合格(1)と不合格(0)の2値にしました。ばらつきが減り、自動化の精度が上がりました。
- 資料を、ファイル形式(ウェブ記事、EPUB、PDF、構造化データ)と構成(テキスト中心、画像中心、混合)の2軸で分類しました。各区画から代表例を選び、評価の作業を75%減らしました。
- 自動スコアと、ランダムに選んだ回答を突き合わせ、「リリースしてよい品質」の基準を決めました。
- 800行を超えるシステムプロンプト(AIへの指示文)を、機能ごとのスキルに分けました。スキルは、ADK(Agent Development Kit、AIエージェントを作る開発キット)のものです。必要な部分だけを読み込む仕組みです。
応答の出だしが遅くなる原因を、運用ログから探した
応答を速くするため、チームは実際の運用ログを調べました。使ったのは、BigQuery Agent Analytics(分析ツール)とADKのログ分析エージェントです。スキルの分割やプロンプトの肥大化が、TTFTにどう影響するかを可視化したのです。特に、複数ページにわたる複雑なシステムプロンプトで影響が大きかったといいます。
そこで、スキルをインラインで統合したシステムプロンプトに直しました。サブエージェントの振り分け(ルーティング)も見直しました。回答の精度を保ったまま、処理の詰まり(ボトルネック)を解消できたと発表されています。
自社で同じ手法を試すなら、発表では次の3つが挙げられています。
- Gemini Enterprise Agent Platform Evaluation Serviceで品質を体系的に測る
- ADKでエージェントを構造化し、段階的な開示を慎重に適用する
- エージェント検索で回答を資料に結びつけ、検索クエリを検査する
ADKはオープンソースで、Python、TypeScript、Go、Javaで使えます(Google Cloudの公式ドキュメント、11/7確認)。
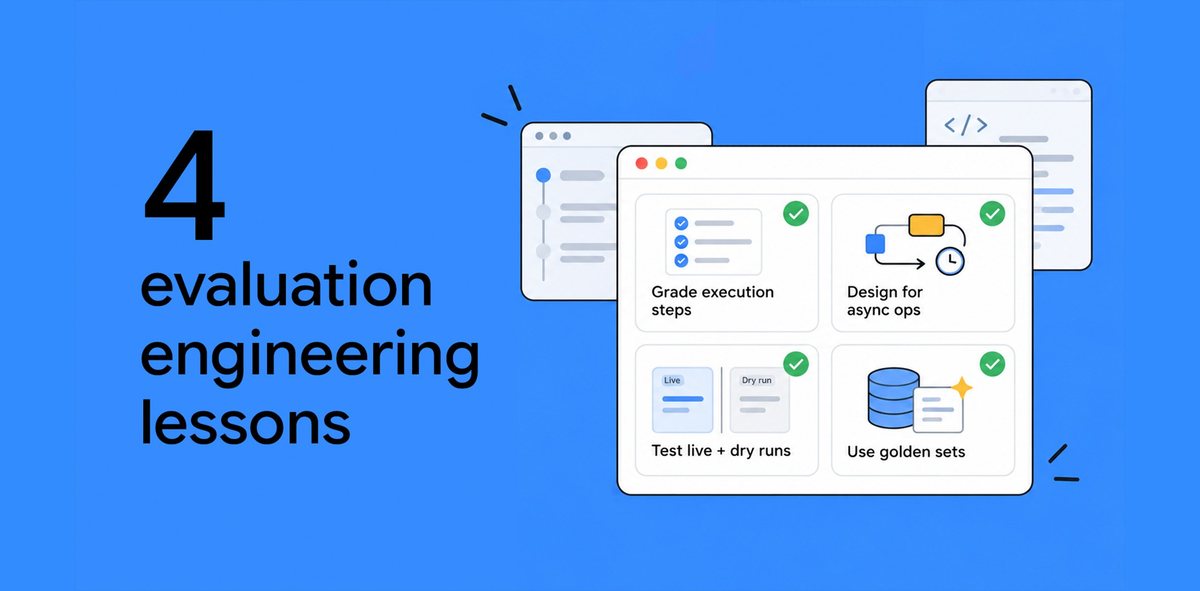
サイソクは11月2日、Google Cloudがエージェント開発の評価で得た4つの教訓を報じていました。(Google Cloud、AIエージェント開発の評価で得た4つの教訓を公開)
編集部の見方では、人の目による確認を減らし、評価を自動の仕組みに移したことが今回の改善の土台です。ただし、合格ラインを決める段階では人が確かめています。