ホーム / AI・テクノロジー / Hugging Face Hugging Face 2026/07/30
2.8兆パラメータのKimi K3 」 中国のAIスタートアップであるMoonshot AI(月之暗面)が、総パラメータ数2.8兆、アクティブパラメータ数1040億に達する超巨大マルチモーダル混合専門家(MoE)モデル「Kimi K3」のテクニカルレポートを公開しました。100万トークンの超長文コンテキストウィンドウに対応し、独自の「Kimi Delta Attention」や、推論時間とコストを動的に制御する強化学習手法「Reasoning Effort RL」など、数々の先端技術を搭載しています。本記事では、Hugging Faceの研究チームが一次資料をもとに議論した、Kimi K3の革新的なアーキテクチャとポストトレーニング技術を徹底解説します。
AI解析: gemini-3.5-flash 本ページはプロモーションを含みます
元動画: Hugging Face Journal Club: Kimi K3
3秒でわかる要点 1 総パラメータ数2.8兆、アクティブ1040億のオープン重みMoEモデル「Kimi K3」が公開されました2 推論時の思考トークン数を制御する「Reasoning Effort RL」により、性能とコストの最適化を実現します3 100万トークンのコンテキストに対応する「Kimi Delta Attention」など、独自のインフラ設計を導入していますこの記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
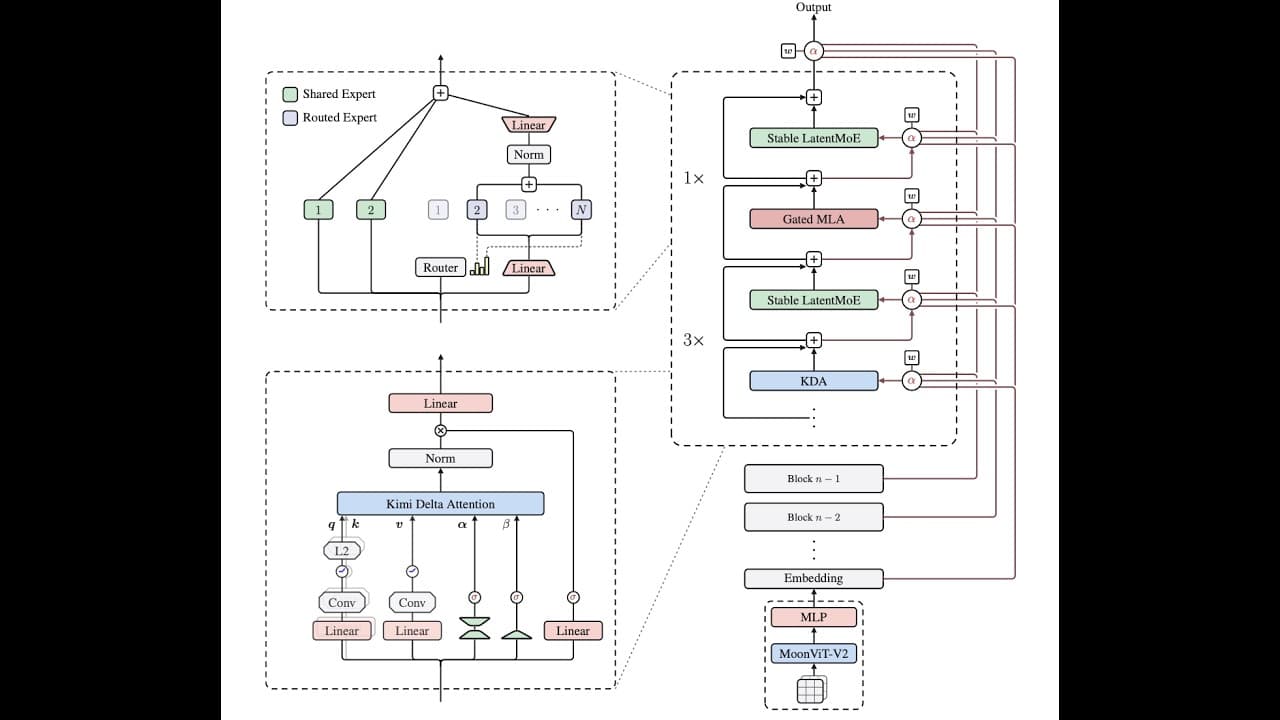
中国の有力AIスタートアップであるMoonshot AI(編集部注:月之暗面)の開発チームは、オープン重みとして公開された最新の超巨大マルチモーダルAIモデル「Kimi K3」のテクニカルレポートを公開しました。Kimi K3は、総パラメータ数が2.8兆、そのうち推論時に有効化されるアクティブパラメータ数が1040億に達する「混合専門家(MoE:Mixture-of-Experts)」アーキテクチャを採用しています。
既存のオープンモデルとの最大の違いは、100万トークンという極めて巨大なコンテキストウィンドウをネイティブにサポートしている点です。さらに、画像や動画を処理する高度なビジョン能力を備えています。研究段階にとどまらず、Hugging Face上でモデルウェイトが公開されており、開発コミュニティがその内部構造やポストトレーニングの手法を詳細に検証できる状態になっています。
発表された機能・アップデートの全容
Kimi K3のテクニカルレポートには、従来のLLM開発における課題を解決するための、極めて高度なエンジニアリングアプローチが多数盛り込まれています。Hugging Faceのジャーナルクラブで特に議論の的となった目玉機能について解説します。
1040億アクティブパラメータを持つ2.8兆パラメータMoEアーキテクチャ
Kimi K3の最大の特徴は、その圧倒的なスケールにあります。総パラメータ数は2.8兆ですが、推論時には必要な専門家(Expert)ネットワークのみを選択的にアクティブ化するMoE構造を採用しています。これにより、アクティブパラメータ数を1040億に抑え、処理能力を維持しながら計算コストを劇的に削減することに成功しました。これは、既存の巨大オープンモデルである「Llama 3.1 405B」などと比較しても、推論時の効率性が極めて高い設計となっています。
100万トークンのロングコンテキストと「Kimi Delta Attention」
長大なコンテキストを安定して処理するため、Kimi K3は「Kimi Delta Attention(KDA)」と呼ばれる独自の注意機構を導入しました。従来のトランスフォーマーモデルでは、コンテキスト長が伸びるにつれてアテンション計算に必要なメモリ(KVキャッシュ)が指数関数的に増大し、システムを圧迫していました。Kimi K3では、アテンションの冗長性を排除し、重要な情報のみを動的に圧縮して保持する仕組みを構築しました。これにより、100万トークンのコンテキストウィンドウにおいても、精度を落とすことなく安定した推論が可能になりました。
段階的な強化学習を実現する「Reasoning Effort RL」
Kimi K3は、問題の難易度に応じてモデルが思考に費やす時間(トークン数)を自律的に調整する「Reasoning Effort RL(強化学習)」を搭載しています。具体的には、簡単な質問に対しては即座に回答し、難解な数学やコーディングの問題に対しては、内部で複雑な思考プロセス(思考トークン)を展開します。この思考プロセスは「low」「high」「max」の3段階の予算管理(Token Budget Control)に基づいて制御されており、無駄なトークン消費を抑えつつ、難解なタスクの解決率を飛躍的に向上させています。
動的な評価基準を生成する「Agentic Generative Reward Model」
強化学習のプロセスにおいて、従来の固定的な報酬モデル(Reward Model)では、モデルの進化に伴って適切な評価ができなくなる課題がありました。Kimi K3はこの課題に対し、報酬モデル自体を自律的なエージェントとして動作させる「Agentic Generative Reward Model(GRM)」を開発しました。このエージェントは、生成された回答の品質を評価するための「評価ルーブリック(基準表)」をタスクごとに動的に生成し、その基準に沿って多角的なスコアリングを行います。これにより、より人間に近い柔軟で高精度なフィードバックループが実現しました。
複数専門家モデルを統合する「Multi-Teacher On-Policy Distillation」
Kimi K3のポストトレーニングプロセスでは、特定の領域(コーディング、数学、一般エージェントタスクなど)に特化して強化学習された9つの専門家モデル(Teacher)を用意しました。そして、これら複数の専門家モデルが持つ知識と推論プロセスを、1つの統合された学生(Student)モデルへとオンポリシーで蒸留(Distillation)する「Multi-Teacher On-Policy Distillation(MOPD)」を採用しています。これにより、各領域の専門能力を損なうことなく、汎用性の高い最高峰のLLMを1つに統合することに成功しました。
量子化を前提とした学習「MXFP4 Quantization-Aware Training」
巨大なMoEモデルを実際のサーバー環境にデプロイする際、メモリ消費量と通信帯域が最大のボトルネックとなります。Kimi K3は、ポストトレーニング段階から4ビット浮動小数点フォーマット(MXFP4)での量子化を前提とした「Quantization-Aware Training(QAT)」を導入しました。学習中から量子化による精度の低下をシミュレートし、それを補正するように重みを調整するため、推論時に4ビットに圧縮しても、16ビット(BF16)のフル精度モデルとほぼ同等の性能を維持できます。これにより、デプロイ時のメモリフットプリントを劇的に削減しました。
性能・ベンチマーク
テクニカルレポートに示されたKimi K3の性能評価結果を整理します。Kimi K3は、数学、コーディング、および自律エージェントタスクにおいて、既存の最高峰プロプロエタリモデルに匹敵する、あるいは凌駕するスコアを記録しています。
評価ベンチマーク
Kimi K3 (max)
Claude 3.5 Sonnet
GPT-5.6 (max)
出典(動画内テクニカルレポートより)
Kimi Code Bench 2.0 93.5% 92.6%
94.1%
Figure 13 / Table 5
SWE-bench (ソフトウェア開発) 43.0% 35.0%
39.0%
Table 5
WebArena (Webエージェント) 1,678 1,634
1,630
Table 5 (Eloレーティング)
GPQA (科学的推論) 74.7% 71.3%
77.0%
Table 5
取材班の見立てでは、特にソフトウェア開発の実務能力を測る「SWE-bench」において、Claude 3.5 Sonnetを大きく上回る43.0%を記録している点は、開発者向けエージェントとしての実用性が極めて高いことを示しています。
競合サービスとの比較
Kimi K3と、現在市場をリードしている主要な商用・オープンモデルとの機能比較を行います(競合モデルのスペックは編集部注に基づく知識を含みます)。
機能・仕様
Kimi K3 (Moonshot AI)
Claude 3.5 Sonnet (Anthropic)
GPT-4o / o1 (OpenAI)
Llama 3.1 405B (Meta)
公開形態 オープン重み (Open Weights)
プロプロエタリ (APIのみ)
プロプロエタリ (APIのみ)
オープン重み (Open Weights)
アーキテクチャ 2.8T MoE (104B Active)
非公開 (MoEと推測)
非公開 (o1は推論特化)
405B 密(Dense)モデル
コンテキスト長 100万トークン
20万トークン
12万8000トークン
12万8000トークン
推論時コスト調整 対応(Reasoning Effort RL)
非対応
対応(o1シリーズ)
非対応
量子化最適化 QATにより最初から最適化
非公開
非公開
デプロイ後に量子化を適用
Kimi K3の優位性
コンテキストウィンドウが100万トークンと、競合を圧倒しています。さらに、推論時の思考時間を動的に制御する仕組み(Reasoning Effort)をオープンモデルとして初めて本格的に実用化した点が、既存技術との決定的な差分です。
Kimi K3の課題
総パラメータ数が2.8兆と極めて巨大なため、オープン重みとして公開されているものの、個人や小規模な企業がローカル環境で自前で運用することは事実上不可能です。運用には、大規模なコンピューティングインフラが必須となります。
料金・提供プラン
Kimi K3はオープン重みモデルとして公開されているため、Hugging Faceからモデルファイルをダウンロードして使用する分には無料 です。ただし、ライセンス条項に従う必要があります。
なお、Moonshot AIが提供する商用APIサービスとしての具体的な従量課金料金や、日本国内向けのAPI提供時期については、本動画内および公開されたテクニカルレポート内での言及はありませんでした。
日本から使う方法
日本の開発者やエンジニアが、Kimi K3を試すための現実的なステップは以下の通りです。
Hugging Faceリポジトリへのアクセス
Hugging Face上の公式リポジトリ(moonshotai/Kimi-K3)にアクセスします。モデルファイルの取得
モデルウェイトおよび推論用のヘルパーコード(encoding_k3.pyなど)をダウンロードします。実行環境の準備
Kimi K3の実行には、MXFP4(4ビット量子化)をサポートするNVIDIA製GPU(H100やA100など)が複数枚必要です。テクニカルレポートでは、vLLMや独自のKDAカーネルを用いた実行環境の構築が推奨されています。日本語対応について
Kimi K3は多言語に対応しており、日本語による高度な指示やコーディング、長文読解タスクもネイティブに処理可能です。
誰にどう効くのか
Kimi K3の登場が、ビジネスや開発の現場にどのようなインパクトを与えるのか、役割別に解説します。
エンジニア・開発者
オープン重みの最高峰モデルとして、最先端の強化学習(RL)技術や量子化技術(QAT)のノウハウを直接コードレベルで学べる意義は極めて大きいです。特に独自の強化学習パイプラインを構築したいAIエンジニアにとって、Kimi K3のテクニカルレポートは最高の教科書となります。
新規事業・企画担当者
100万トークンのロングコンテキストと、難解なタスクを解決する自律エージェント能力を組み合わせることで、社内の膨大なドキュメントやソースコードを丸ごと読み込ませた「超高度な社内専門家エージェント」の開発が可能になります。
経営層・意思決定者
プロプロエタリなAPI(OpenAIやAnthropic)に依存せず、自社のインフラ(オンプレミスや専用クラウド)上で世界最高峰の推論能力を持つAIモデルを完全なデータコントロール下に置いて運用できるという、強力な選択肢が得られます。
まとめ
Kimi K3は、単にモデルの規模を拡大するだけでなく、推論時の効率性、量子化の最適化、そして「思考時間の自己制御」という、次世代AIに必要な要素をすべて詰め込んだ記念碑的なモデルです。開発者やAI研究者は、まずHugging Faceのリポジトリを検証し、その卓越したエンジニアリング手法を自社のプロジェクトに取り入れるべきです。
動画のタイムテーブル 0:00 イントロダクションとKimi K3テクニカルレポートの概要紹介 0:41 Kimi K3の基本仕様(2.8Tパラメータ、104Bアクティブ)の解説 1:19 ポストトレーニング(SFT、強化学習、蒸留)プロセスの全体像 3:15 新マークアップ言語「XTML」によるチャットテンプレートの標準化 4:23 モデル容量と通信コストを削減する量子化(QAT)技術の導入 5:23 強化学習を効率化する「Partial Rollout Scheme」の仕組み 8:40 思考プロセスを制御する「Reasoning Effort RL」の詳細 11:30 動的な評価基準を生成する「Agentic Generative Reward Model」 13:30 複数専門家を1つに統合する「Multi-Teacher On-Policy Distillation」 18:20 過学習を防ぐ「Unified White-Box RL Environment」の構築 20:25 ナレッジグラフを用いた学習用タスクの自動生成フロー 23:30 カメラ修理タスクなどの自律エージェント性能評価デモ 25:30 超長文対応インフラ「Kimi Delta Attention」の技術的詳細 28:00 100万トークンのコンテキスト処理におけるKVキャッシュ最適化 30:30 Kimi K3が持つ高度なビデオ編集・アニメーション制作能力 32:00 コスト効率と主要ベンチマークにおける競合モデルとの比較 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)