公式発表bycloud

「ネオクラウド」はいかにしてAI狂騒曲の勝者となったか GPU不足と電力危機が変えるインフラ覇権

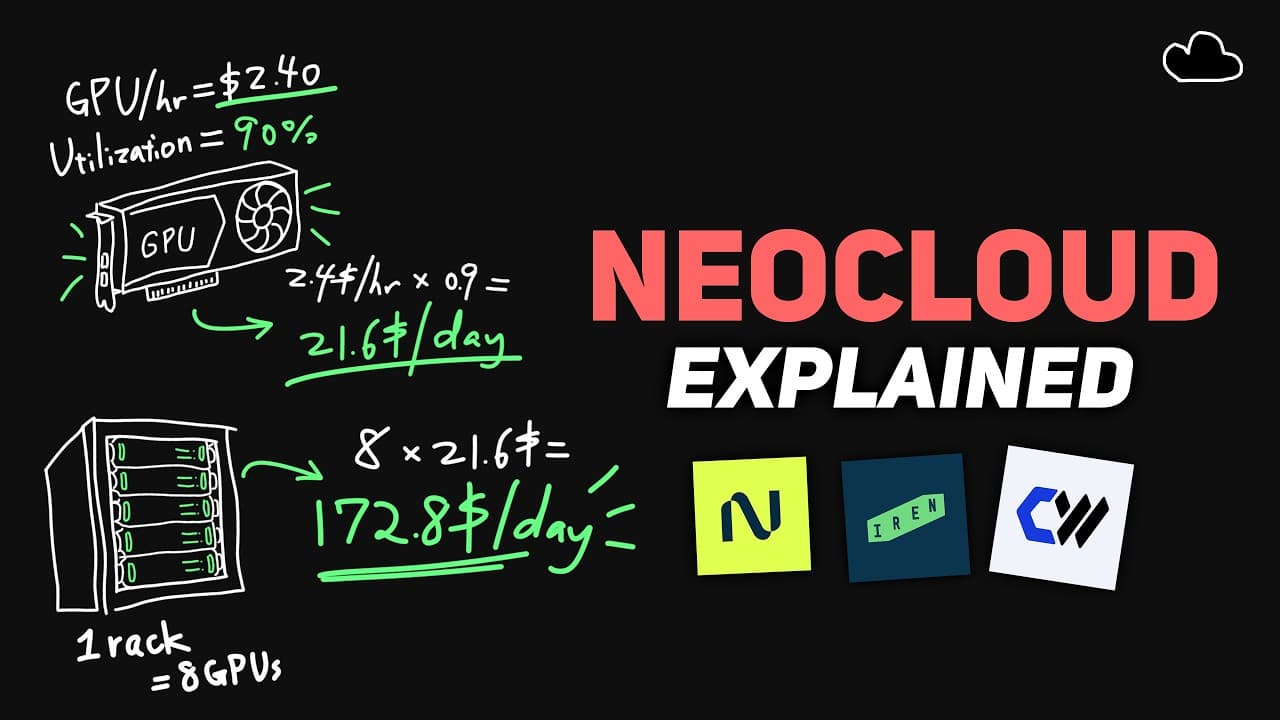
生成AIの急速な普及に伴い、GPU計算資源に特化した「ネオクラウド」と呼ばれる新興事業者が急成長を遂げています。暗号資産マイニングなどの過去事業から転換した企業群が、大手メガクラウドの供給遅延や電力網のボトルネックを追い風に巨額の受注残を確保しています。本稿では、CoreWeaveやNebiusをはじめとする主要プレイヤーの収益構造、NVIDIAによる資金環流のリスク、学習から推論へと移る需要の構造変化を徹底解説します。

AI解析: gemini-3.6-flash

元動画: Neoclouds: How Failed Companies Became AI’s Biggest Winners

3秒でわかる要点

  1. 1ネオクラウドはメガクラウドのGPU不足を突いて急拡大し、H100を半額近い価格で提供しています。
  2. 2インフラの課題はGPU調達から電力網接続へ移行し、全米主要地域で系統接続まで最大7年待ちとなっています。
  3. 3AI需要が学習から推論へシフトする中、自社コンピュートを他社へ貸し出す巨額取引が相次いでいます。

何が発表されたのか

AI業界において、従来のメガクラウド(ハイパースケーラー)とは一線を画す「ネオクラウド(Neocloud)」と呼ばれるGPU専門のクラウド事業者が急激な存在感を示しています。本動画では、半導体・AI市場調査会社SemiAnalysisなどが定義したネオクラウドの市場構造と、主要3社であるCoreWeave、Nebius、IRENの経営戦略および財務実態が詳細に解析されました。

これらのネオクラウド企業は、単に計算資源を提供するだけでなく、自らメガクラウドや大手AIラボと長期契約を結び、数千億円規模のインフラ投資を展開しています。研究段階を超えてすでに完全な商業提供(GA)段階にあり、AI経済の足腰を支える柱となっています。

発表された機能・アップデートの全容

ドットコムバブルの再来か:NVIDIAによる「循環型」投資構造

動画内では、現在のAIブームと2000年代のドットコムバブルとの構造的類似性が指摘されています。当時、通信機器大手のシスコシステムズ(Cisco)は「ベンダーファイナンシング」と呼ばれる手法を用いて顧客企業に資金を貸し付け、自社製品を買わせて売上を膨らませました。しかし、顧客側が通信インフラから十分な収益を上げられなくなったことでバブルは崩壊しました。

現在、半導体大手のNVIDIAも同様の戦略を拡大しています。2026年時点でNVIDIAはAIスタートアップやインフラ企業へ400億ドル以上の出資や預託金を計上しています。具体的には、Nebiusへ20億ドルの投資、CoreWeaveとの提携強化、IRENとの戦略的パートナーシップ、OpenAIの資金調達ラウンドへの300億ドルコミットメントなどが含まれます。投資を受けた企業がその資金でNVIDIA製GPUを購入する構造が出来上がっており、UBSの試算によれば、OpenAIとの取引だけでNVIDIAの2026年予想売上の最大13%を占める計算になります。

ハイパースケーラーの死角を突くネオクラウドの構造的優位性

ネオクラウドとは、データベースやID管理、アクセス解析といった多様なサービスを提供せず、純粋なベアメタルGPUとKubernetes等による高速ネットワークに特化した新しいクラウドプロバイダーを指します。Amazon Web Services(AWS)やMicrosoft Azure、Google Cloudといったハイパースケーラーが200以上の複雑なサービスを展開するのとは対照的です。

2022年後半のChatGPT登場以降、NVIDIA H100などのAIチップ需要が爆発しました。ハイパースケーラーは既存顧客のサービス運用やデータセンターの拡張遅れ、電力確保の遅れにより、外部顧客へのGPU貸出に数カ月待ちの制限をかけざるを得なくなりました。この隙間を突く形で、過去の負債を持たないネオクラウドが5〜7年の長期契約を背景に数万機規模のGPUクラスタを即座に納品し、急速に市場シェアを奪いました。

ネオクラウドはハイパースケーラーよりも遥かに安価です。AWSでH100インスタンスを借りる場合、1GPU時間あたり約4ドル以上かかりますが、ネオクラウドでは1時間あたり2ドル台前半で提供されており、約50%のコスト削減が可能です。余計なミドルウェアのライセンス料や運用コストが乗らないベアメタル構成であることが、この圧倒的な価格差を生み出しています。

クラウド特化型「CoreWeave」の巨額受注とベアメタル戦略

CoreWeaveはネオクラウド業界の最大手であり、純粋な計算資源提供に特化しています。同社は2017年に「Atlantic Crypto」として創業されたイーサリアムのマイニング会社でした。2018年の暗号資産暴落を機に、GPU艦隊を視覚効果(VFX)スタジオや学術研究向けへ転用し、さらに汎用GPUクラウドへとピボットを重ねました。

2025年3月にIPOを果たした同社は、3.5GW(ギガワット)以上の契約電力を誇り、2026年初頭時点で990億ドルに達する未消化受注(バックログ)を抱えています。同社の特徴は、Microsoft、OpenAI、Meta、Anthropicといった極めて少数のメガパフォーマーにターゲットを絞っている点です。2025年の売上のうち約67%がMicrosoft1社からのものであり、同社は実質的にAzureの外部GPUキャパシティとして機能しています。

CoreWeaveは自社で高度な開発者向けソフトウェア層を構築しません。なぜなら、主要顧客であるOpenAIやMeta自身が独自の上層プラットフォームを有しており、下層のベアメタルと圧倒的なネットワーク帯域、高い稼働率(アップタイム)のみを求めているからです。ソフト層を作れば顧客と競合することになるため、同社は資本の全額をハードウェアの買い増しに集中させています。

ソフトウェア層で高利益率を狙う「Nebius」のAWS型プレイブック

2024年に大手IT企業Yandexのロシア事業分離によって誕生したNebiusは、CoreWeaveとは真逆のアプローチを採っています。同社はメガラボではなく、数千社に及ぶ中小AIスタートアップやミンド市場の企業、推論ワークロードをターゲットにしています。

ベアメタルGPUのレンタル事業は粗利益率が30〜50%程度にとどまり、競合の参入によって価格競争に巻き込まれやすい特徴があります。そこでNebiusは、2026年5月にMIT発の推論効率化スタートアップであるEigen AIを6億4300万ドルで買収するなど、推論プラットフォームやMOPs(MLOps)領域のソフトウェア層を自社で構築しています。GPU上のプラットフォーム層を自作・提供することで、粗利益率を60〜80%へ引き上げる戦略です。

これは、2006年にAWSが単なるストレージ(S3)や計算機(EC2)からスタートし、その上に200以上の高粗利サービスを積み上げて莫大な利益を生み出したプレイブックを、AI時代において再再現しようとする試みと言えます。

電力資産を武器にする「IREN」と7年の系統接続障壁

ネオクラウド第3の大型プレイヤーであるIREN(旧Iris Energy)は、2018年にオーストラリアで創業されたビットコインマイニング企業です。同社の最大の強みは、GPUの保有数ではなく「確保済みの電力網接続権(Grid-connected power)」にあります。

同社はテキサス州やカナダのブリティッシュコロンビア州などに、合計3GWを超える格安の再生可能エネルギー系統接続権を所有しています。テキサス拠点での卸電力価格はメガワット時(MWh)あたり27〜34ドルであり、全米平均の40ドルや、一部地域の60〜70ドルと比較して圧倒的に有利なコスト構造を実現しています。

現在、AIインフラにおける最大のボトルネックは「GPUの調達」でも「資金」でもなく「電力」です。全米の主要市場において、新しいデータセンターが送電網に接続するまでの待ち時間は最大7年に達しています。このため、すでにメガワット単位の受電設備を完了させているIRENの土地・設備資産は、業界内で極めて高い希少価値を持っています。

18カ月周期の製品寿命問題と「推論需要」への地殻変動

ネオクラウド各社が直面する最大の財務リスクが、NVIDIAの急速な製品サイクルに起因する「GPU償却問題」です。CoreWeaveなどはGPU設備を6年で減価償却する会計処理を行っていますが、実際の経済的耐用年数は3年程度とみられます。

NVIDIAが18カ月ごとにH100、B200(Blackwell)、Rubinといった新世代チップを投入するため、電力あたりの処理効率(ワットパフォーマンス)が飛躍的に向上します。電力供給量に上限(メガワットの壁)があるデータセンターにおいて、古いH100を稼働させ続けることは、最新のB200を置けば得られたはずの高い収益機会を失うことを意味します。投資額30万ドルのH100サーバーが2年で原価回収を完了する前に、顧客が新チップへの移行を求めて解約・契約変更を迫るリスクが存在します。

イーロン・マスク率いるSpaceX/xAIが示すメガクラウドの帰結

ネオクラウドモデルに対する最大の反証と考えられていたのが、イーロン・マスク氏率いるSpaceX/xAIの動きでした。同社はテネシー州メンフィスに巨大型AI学習施設「Colossus」をわずか122日で建設し、ネオクラウドを介さず自前でインフラを完結させる垂直統合を見せつけました。

しかし2026年5月、SpaceX/xAIは驚くべき方向に舵を切りました。自社の「Colossus 1」の全計算能力(300MW相当)を、ライバルであるAnthropicに対して2029年5月まで月額12億5000万ドル(総額400億ドル超)で貸し出す契約を締結したのです。Colossus 2の稼働に伴い余剰となった自社インフラを、即座に他社へ賃貸するネオクラウド事業へ転参入したことを意味します。この出来事は、コンピュート資源が石油や不動産のような流動性の高いコモディティ空間へと変化したことを象徴しています。
性能・ベンチマーク

動画内で提示されたGPUの仕様、価格、および各ネオクラウド企業の稼働・財務指標の比較は以下の通りです。

項目名 数値・仕様 出典 Note
H100 1時間あたりレンタル料 (AWS) $4.00以上 動画内スライド (AWS P5) ハイパースケーラーの標準価格
H100 1時間あたりレンタル料 (ネオクラウド) $2.00〜$2.50 動画内スライド (Verda等) 約50%安価なベアメタル価格
8GPU H100 サーバー初期導入コスト 約$300,000 動画内試算 筐体・ネットワーク・DC構築費含む
8GPU H100 サーバー年間売上推計 約$150,000 動画内試算 稼働率85%(15%メンテナンス・障害)
H100 GPU 最大TDP(消費電力) 700 W 動画内比較表 Hopper世代 (2022)
B200 GPU 最大TDP(消費電力) 1,000 W 動画内比較表 Blackwell世代 (2024, ワット効率約2倍)
CoreWeave 契約電力容量 3.5 GW以上 動画内スライド 2026年初頭時点
CoreWeave 受注残(バックログ) 約$99,000,000,000 2026年Q1決算資料 2026年3月末時点
IREN 保有電力網接続容量 3.0 GW以上 動画内スライド テキサス州およびBC州拠点
IREN 卸電力価格(テキサス拠点) $27〜$34 / MWh 動画内資料 全米平均($40)および一部地域($60-70)より格段に安価
全米主要市場における電力網接続待ち時間 最大 7 年 動画内テロップ グリッド接続の行政・工事遅延

競合サービスとの比較

今回分析されたネオクラウドと、既存のメガクラウド(AWS / Azure / GCP)の差異、およびネオクラウド内部でのポジショニングの比較は以下の通りです。

企業・サービス 主なターゲット顧客 ソフトウェア層の提供 電力・インフラ調達方式 強み・弱み分析
AWS / Azure / GCP 全企業の全ワークロード 200以上のフルスタックサービス 自社巨大DC+サードパーティ賃貸 強み: 既存エコシステムとデータ連携
弱み: 価格が高く、GPUの即時調達が困難
CoreWeave 超大手AIラボ・ビッグテック 提供なし(純ベアメタル) 主に他社DCの長期リース 強み: 超巨額の受注残とNVIDIAとの強いパイプ
弱み: 特定数社への顧客集中と240億ドル超の負債
Nebius 中小AIスタートアップ・推論需要 積極開発(MOPs・推論基盤) 自社DC建設+買収 強み: 高い粗利益率(60-80%狙い)と柔軟な開発環境
弱み: 規模面でCoreWeaveに劣る
IREN 大手インフラ賃貸+マイニング なし(インフラ提供) 自社所有の格安電力網(3GW) 強み: 全米屈指の格安受電容量と自社土地
弱み: AIクラウドの運用実績が浅く売上転換が遅い

料金・提供プラン

動画内で言及された計算資源および関連サービスの価格体系は以下の通りです。

  • GPUレンタル料金(オンデマンド/長期契約):
    • H100 GPU(ベアメタル): 1時間あたり $2.00 〜 $2.50(ネオクラウド標準)
    • H100 GPU(ハイパースケーラー): 1時間あたり $4.00 以上(AWS P5インスタンス等)
  • 電力コスト(事業者調達価格):
    • IREN テキサス拠点: $27 〜 $34 / MWh
    • 全米平均価格: $40 / MWh
    • 高コスト地域: $60 〜 $70 / MWh
  • SpaceX/xAI × Anthropic 大型コンピュート賃貸契約:
    • 月額利用料: 12.5億ドル(2029年5月まで)
    • 総契約規模: 400億ドル以上(Colossus 1の300MW容量)

日本から使う方法

日本の開発者や企業がネオクラウドの計算資源を活用するための手順と留意点は以下の通りです。

  1. アクセスとアカウント登録:
    • 各社公式サイト(CoreWeave, Nebius等)から開発者ポータルへアクセスし、組織アカウントを作成します。
    • 信用調査や本人確認(KYC)、クレジットカードまたは請求書払いの設定を行います。
  2. リージョン選定:
    • 多くのデータセンターは米国(テキサス、ヴァージニア等)や欧州(北欧等)に位置しています。
    • 日本国内からの利用の場合、モデルの学習ワークロードであれば遅延(レイテンシ)の影響を受けにくいため問題なく利用可能です。リアルタイム推論の場合はネットワーク遅延の事前検証が必要です。
  3. 利用の注意点:
    • ネオクラウドの多くはベアメタル環境を提供するため、Kubernetesの操作知識や、NVIDIA CUDAドライバーおよびインフィニバンド(InfiniBand)の自前設定・調整能力が求められます。
    • Nebiusのようなプラットフォーム層を提供する事業者を選択することで、インフラ設定の手間を削減できます。

誰にどう効くのか

エンジニア・研究者へのインパクト

メガクラウドの「GPU確保待ち」から解放され、安価かつ即座に大量のH100/B200クラスタをプロビジョニングできるようになります。ベアメタル構成により、ハイパースケーラー特有の仮想化オーバーヘッドなしで生のコンピュート性能を引き出せます。

企画・プロダクトマネージャーへのインパクト

AIモデルの推論コストが従来の半額近くに抑えられるため、LLMを組み込んだアプリケーションの単位経済性(ユニットエコノミクス)が大幅に改善します。特にトークン消費量が膨大なAIエージェントやコード生成ツールのサービス化が現実的になります。

経営層・CIOへのインパクト

クラウドインフラ支出の最適化に直結します。学習用途には単価の安いネオクラウドを活用し、既存データとの連携が必要な社内基幹システムには既存のメガクラウドを残すといった「ハイブリッド・マルチクラウド戦略」の策定が不可欠となります。

まとめ

AIインフラ市場は、単なるGPUの獲得競争から「いかに格安の電力を確保し、推論需要へ効率よく転換するか」というフェーズへ移行しました。ネオクラウド各社は急速な減価償却と電力制限の課題を抱えつつも、爆発する推論需要を背にAI経済の中心的役割を果たし続けています。自社のAIワークロードの特性を見極め、ベアメタル型のネオクラウドを戦略的に選択することがコスト競争力の源泉となります。

動画のタイムテーブル

  • 0:00AIブームとドットコムバブルの類似性および資本構造の変化
  • 0:37シスコの歴史に重ねるNVIDIAのベンダーファイナンシング
  • 1:53ネオクラウドの定義とハイパースケーラーとの構造的相違
  • 3:45ChatGPT以降のGPU需要急増とメガクラウドの供給遅延
  • 5:31ハイパースケーラーとネオクラウドのGPUレンタル価格差
  • 6:21ネオクラウドにおける8GPUサーバー単位の投資回収試算
  • 7:40業界首位CoreWeaveの暗号資産からのピボットと顧客集中
  • 9:51Nebiusによる推論プラットフォーム構築とソフトウェア層強化
  • 11:37IRENの低価格電力ポートフォリオと収益化の課題
  • 13:23AIインフラ最大のボトルネックとなる電力網接続の壁
  • 16:19NVIDIAの18カ月チップサイクルがもたらす減価償却の歪み
  • 18:50学習から推論コンピュートへの歴史的転換とARRの爆発
  • 21:07SpaceX/xAIのColossus運用とAnthropicへの巨額コンピュート貸出

記事で紹介したツール

この機能を、いま自分の環境で試す

記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。

公式サイトで試す

提供: OpenAI

本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る(解析モデル: gemini-3.6-flash)