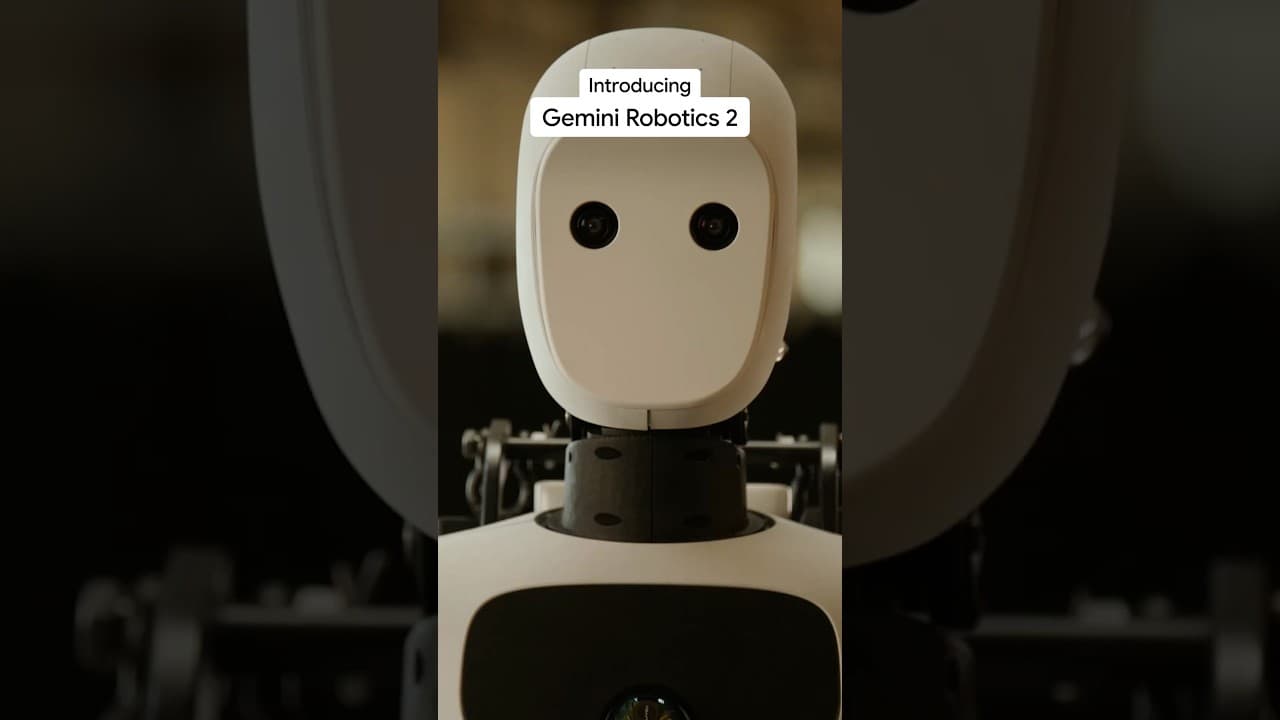
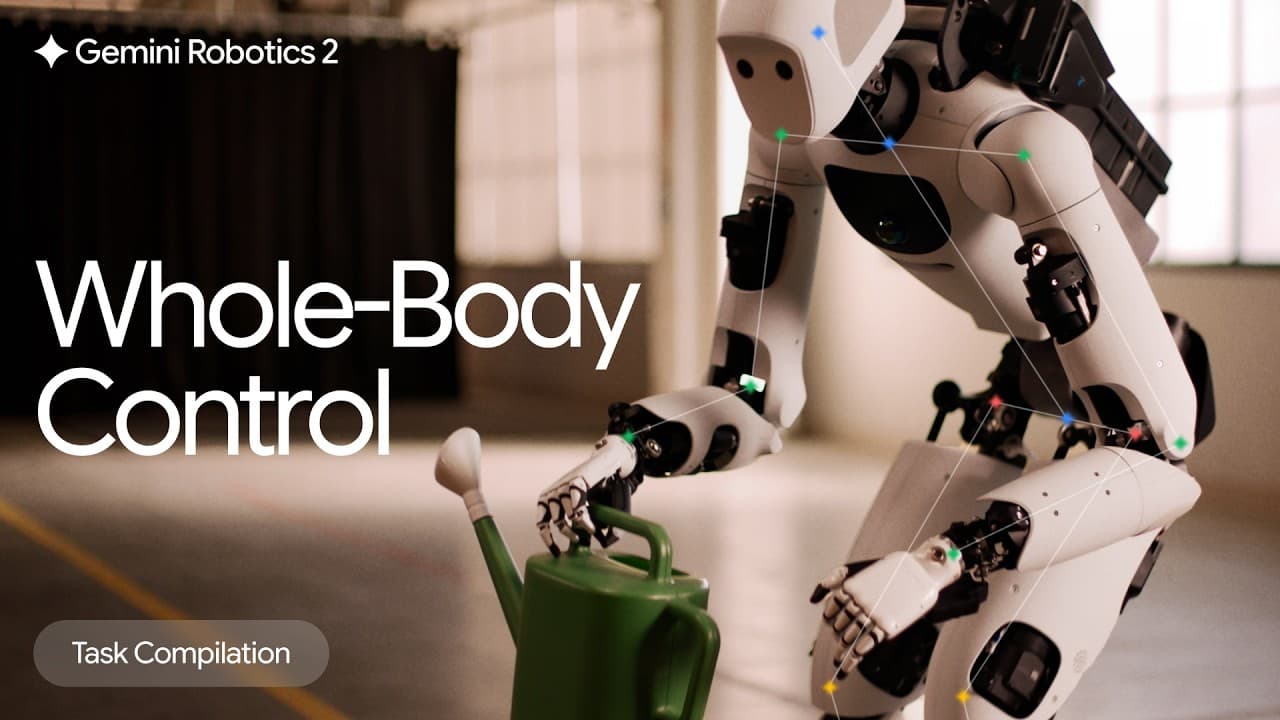
Google DeepMindは、ロボットの思考と身体制御を統合する最新AIモデル「Gemini Robotics 2」を発表しました。本モデルはヒューマノイドやロボットアームの全身制御、22個の関節を持つハンドの微細な操作、複数ロボットによる自律的な協調動作を実現します。複雑な人間の現実環境において、リアルタイムかつ全自律でタスクをこなす新たな基盤モデルです。
何が発表されたのか
Google DeepMindは、ロボットの知能と物理的な制御を一元的に担う次世代モデル「Gemini Robotics 2」を発表しました。本発表は研究開発における重要な節目となる更新であり、実験室内の単一タスクを超えて、現実世界の雑多な環境でロボットを自律動作させることを目指しています。
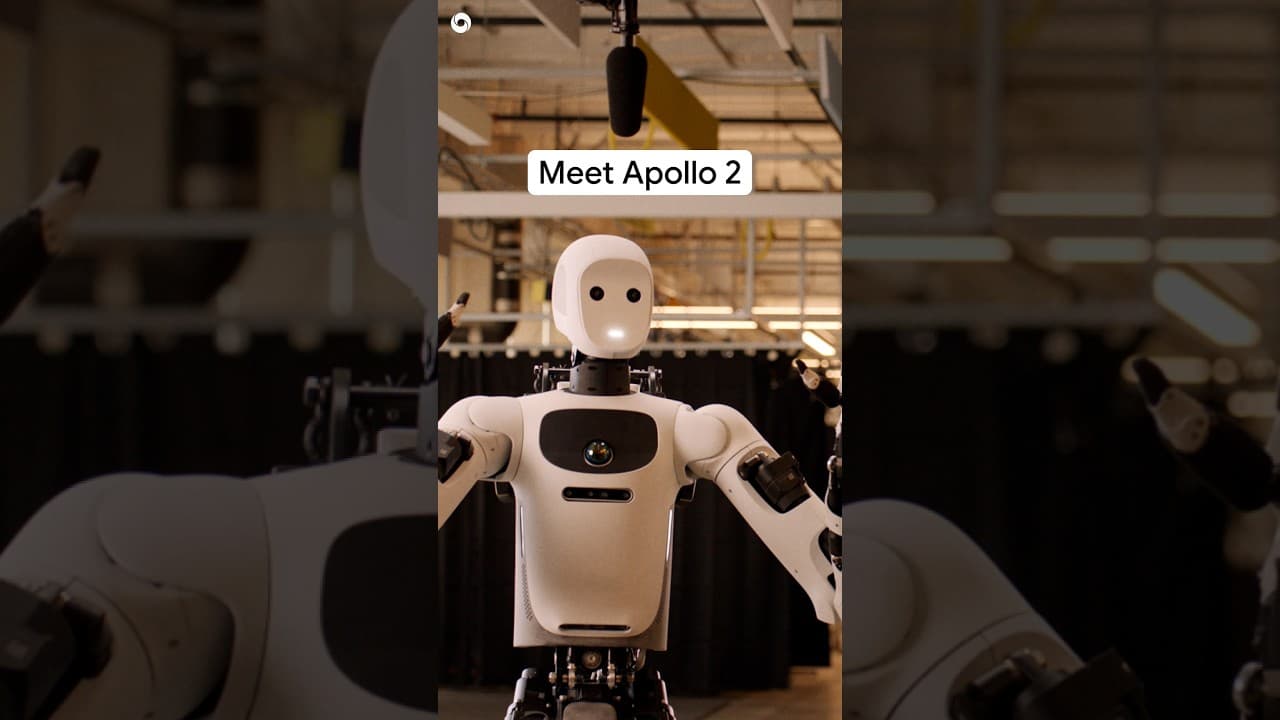
動画内では、同モデルが「脳」として機能し、ヒューマノイドロボット「Apollo」、多関節ハンド「Sharpa hand」、作業用アーム「Duo arm」などの多様なハードウェアを制御する様子が公開されました。テロップでは「All robots in this video are fully autonomous with Gemini Robotics 2. Real-time footage.(動画内のすべてのロボットはGemini Robotics 2により完全に自律動作しており、リアルタイム映像です)」と明確に示されています。
発表段階としては最先端の研究成果のデモ展示であり、特定の商用プロダクトへの即時組み込みや一般提供(GA)の段階ではありません。しかし、単一のモデルでハードウェアの違いを超えて制御を包括する統合型のロボット基盤モデル(VLA: Vision-Language-Actionモデル)として、極めて高い完成度を示しています。
発表された機能・アップデートの全容
Google DeepMindでプリンシパル・リサーチ・サイエンティスト兼ディレクターを務めるJie Tan氏は、今回のGemini Robotics 2における進化点として主要な3つの柱を挙げています。動画内の実演映像および研究者の解説に基づき、各機能の詳細を解説します。
1. 全身の協調運動を実現する「全身制御(Whole-body control)」
従来のロボット制御では、移動のための足と作業のための腕を個別の制御ロジックで動かす手法が主流でした。これに対してGemini Robotics 2は、ヒューマノイドロボットの全身(Whole-body)を統合してリアルタイム制御します。
Jie Tan氏は「人間は身体を協調させて動かすことに慣れていますが、ロボットにとっては容易ではありません。一見単純に見えるタスクであっても、全身で多数の意思決定を行う必要があります」と説明しています。デモでは、ヒューマノイドロボット「Apollo」が腰を落としてバランスを取りながら物体を持ち上げたり、本棚から本を取り出したり、塵取りを使ってゴミを回収したりする動作をスムーズに遂行しています。全身の関節を同時に調整することで、重心のバランスを崩さずに複雑な作業を継続できます。
2. 22関節を微細に操る「多関節ハンド操作(Dexterous hands)」
2つ目の柱は、精密な手先操作能力の向上です。リサーチ・サイエンティストのMarissa Giustina氏は「人間は手を使う際に22個の独立した関節をどう駆動するか意識しませんが、AIモデルにはそれを求めています」と解説します。
動画では、多関節ハンド「Sharpa hand」が、チャック付きポリ袋に入ったブドウを崩さずに持ち上げたり、微小なスイッチを指先で切り替えたりする様子が確認できます。また、柔らかいぬいぐるみをつかんで箱に収める動作や、ハサミなどの工具を正確に握る操作も実演されました。剛体(固い物体)だけでなく、袋やぬいぐるみといった変形体(Deformable objects)に対しても、適切な力加減と指先の協調によって安定した操作を実現しています。
3. 多機種ロボット間での「自律協調機能(Multi-robot collaboration)」
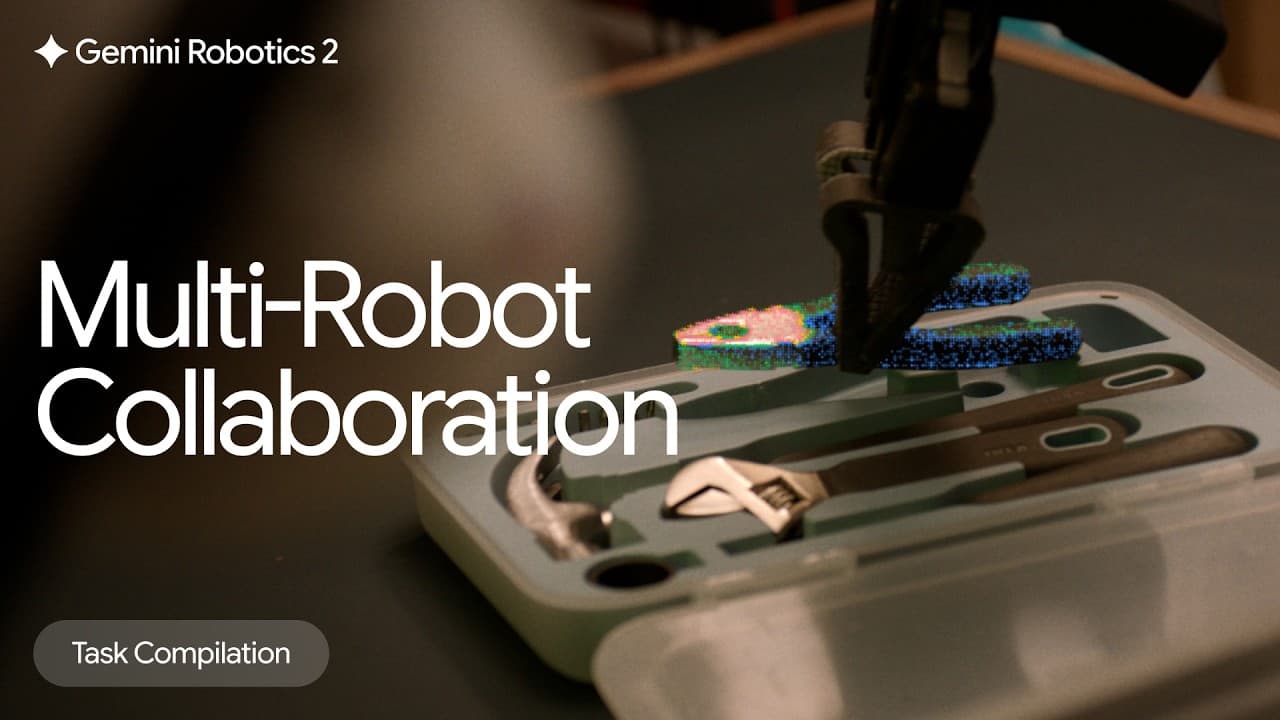
3つ目の柱は、複数のロボットが同じ目標に向かって協同作業を行うマルチロボット連携機能です。単一の言語命令からタスクを分析し、異なる機体に役割を分散して並行処理します。
デモでは、人間が「Hey, Duo, kit all tools in the bin, close the kit, and put the kit back into the bin.(デュオ、ボックス内のツールをすべてキットに収納し、キットを閉じて、そのキットを箱に戻して)」と話しかけます。この指示を受けると、アーム型ロボット「Duo arm」が工具をケースに詰め、ヒューマノイドロボット「Apollo」が移動して蓋を閉め、完成したケースを元の位置に搬送するという一連の工程を自律的に分担して遂行しました。事前に動作プログラミングを行わずに、提示された命令から自律的に協調動作を生成する点が極めて革新的です。
4. 予期せぬ環境変化に対応する「リアルタイム応答性能」
プリンシパル・ソフトウェア・エンジニアのKanishka Rao氏は「汎用的な知能だけでなく、変化する状況に反応できることこそが知能の本質です」と語っています。
動画内では、作業中にバッグの取っ手が外れかかったり、対象物の位置が不規則にずれたりしても、ロボットが視覚フィードバックに基づいて即座に行動を修正する様子が描写されています。決められた軌道をなぞるのではなく、センサ情報とカメラ映像から刻一刻と変化する周囲の状況を把握し、動的に行動を再計算する能力を備えています。
性能・ベンチマーク
動画内における具体的なベンチマークスコアの提示状況を以下の表に整理します。
| 評価項目 |
提示された数値 / 指標 |
出典 |
補足 |
| 動作の自律性 |
100% 自律動作 |
動画内テロップ |
人間による遠隔操作(テレオペレーション)なし |
| 動作速度 |
リアルタイム(1倍速) |
動画内テロップ |
映像の倍速加工なし |
| ハンド制御自由度 |
22関節(22 joints) |
Marissa Giustina氏発言 |
Sharpa handにおける駆動軸数 |
| 定量ベンチマーク |
提示なし |
動画全般 |
具体的な成功率(%)や処理時間の数値データは未公開 |
取材班の見立てでは、今回の動画は定量的な技術論文の発表というよりも、定性的な制御能力の向上を実演で証明するデモンストレーションとしての色彩が強い印象です。詳細な成功率や精度のデータについては、今後の論文公開が待たれます。(編集部注: DeepMindは従来、RT-1やRT-2などの発表時に論文を同時公開しており、本モデルも追って学会等で詳細データが示される見込みです)
競合サービスとの比較
現在、世界的なビッグテックやスタートアップが自律型ロボットの領域で激しい開発競争を繰り広げています。既存の主要モデルおよび競合プロジェクトとの比較を行います。
| 項目 |
Gemini Robotics 2 (Google DeepMind) |
OpenAI / Figure AI (Figure 02) |
Tesla Optimus |
編集部補足・分析 |
| 制御アプローチ |
視覚・言語・行動の統合基盤モデル (VLA) |
Vision-LLM + 運動制御モデルのハイブリッド |
端対端 (End-to-End) ニューラルネットワーク |
DeepMindはLLMの推論力を直接制御に結び付ける構造 |
| 機体非依存性 |
高い(Apollo, Duo arm, Sharpa hand等) |
中程度(主にFigure 02専用) |
低い(Optimus専用設計) |
Geminiは多様なハードウェアへ適用可能な汎用性が強み |
| 複数機協調 |
対応(言語命令による自律分担) |
現時点で未デモ |
現時点で未デモ |
複数ロボットの連携制御において一歩リード |
| 手先制御 |
22関節の微細制御 |
16自由度ハンド |
11自由度(次世代で22自由度予定) |
繊細な変形物操作において高い能力をアピール |
(※注: 競合他社の情報は、公開されている技術資料に基づく編集部調査によるものです)
他社が単一のヒューマノイドハードウェアとソフトウェアの一体開発に注力しているのに対し、Google DeepMindはソフトウェアとしての「汎用ロボット頭脳」を構築するアプローチを取っています。異なるメーカーのロボット本体やアーム、ハンドに対して共通のAIモデルを移植できる点が、Gemini Robotics 2の最大の差別化要素です。
料金・提供プラン
動画内では、Gemini Robotics 2の提供価格、利用料金、APIの従量課金体系、および一般向けリリース時期に関する言及はありませんでした。
現状は研究開発段階のモデルであり、Google Cloudの「Vertex AI」などを通じた法人向けプレビュー提供やAPI公開の時期については、今後の公式アナウンスを待つ必要があります。
日本から使う方法
現時点でGemini Robotics 2のモデルやAPIは一般公開されていないため、日本国内から直接動作させることはできません。しかし、将来的な利用や評価に向けて以下の準備が推奨されます。
- 最新情報の収集: Google DeepMind公式ブログおよびGoogle Cloud Newsroomの更新を講読します。
- Google Cloud環境の整備: 将来的にVertex AI等でAPIアクセスが提供される可能性が高いため、Google Cloudアカウントを用意しておきます。
- 既存Gemini APIの活用: Gemini 1.5 Proなどの多多模態(マルチモーダル)モデルを用いて、視覚理解やテキストによる指示生成の検証を先行して進めます。
誰にどう効くのか
Gemini Robotics 2の進化は、産業界や技術開発に大きなインパクトを与えます。立場ごとの実務上の影響を整理します。
エンジニア・研究者
これまでロボット制御において最も困難とされてきた「環境変化への適応」と「多関節の協調動作」が、基盤モデルによって自動化される道が拓けました。ロボットごとにハードコードしていた複雑な運動学ロジックの記述作業が大幅に削減される可能性があります。
企画・マーケティング担当者
製造業、物流倉庫、サービス業における自動化の企画範囲が大きく広がります。固い部品の搬送だけでなく、バッグの整理、ゴミ取り、複数ロボットによる梱包など、これまで人が行わざるを得なかった柔軟性の高い作業の自動化提案が可能になります。
経営層
労働力不足が深刻化する日本市場において、ロボット導入のROI(投資対効果)を大きく変える可能性があります。ロボットの汎用性が高まることで、特定作業専用の高価な産業用ロボットではなく、ソフトウェアの更新で多様なタスクに対応できる汎用ロボットへの投資判断が現実味を帯びてきます。
まとめ
Gemini Robotics 2は、全身制御、多関節ハンド操作、複数ロボットの自律協調を実現し、ロボティクス分野におけるAIの重要性を改めて証明しました。実世界で動く汎用AIの実現に向けて確実な一歩を踏み出したと言えます。今後の技術論文の公開およびプレビュー提供の発表に向けて、Google DeepMindの動向を引き続き注視していく必要があります。