ホーム / AI・テクノロジー / Google DeepMind Google DeepMind 2026/07/30
Google DeepMind、Gemini Robotics 2 」を Google DeepMindは2026年7月30日、人型ロボットの全身制御を可能にする新しい物理AIモデル「Gemini Robotics 2」を発表しました。前世代のモデルがテーブルの上の作業など上半身の制御に特化していたのに対し、今回のバージョン2では、しゃがむ、屈む、全身のバランスを保ちながら障害物を避けるといった、より高度な「全身制御(Whole-Body Control)」を実現しています。実世界での実用化に向けた大きな一歩となる研究成果です。
AI解析: gemini-3.5-flash
まとめ この話題の全体像はこちら Gemini Robotics 2の全貌を徹底解剖:9本の公式発表から見えたフィジカルAIの未来 元動画: Tasks that require whole-body control with Gemini Robotics 2
3秒でわかる要点 1 前世代の上半身制御から進化し、しゃがむ・屈むといった全身の協調動作(Whole-Body Control)を実現2 自律動作(Autonomous)によるじょうろの拾い上げ、棚からの正確な仕分け、杖の手渡しデモを公開3 人間用に設計された雑然とした空間において、重心をリアルタイムに制御しながら動作する能力を実証この記事の章立て 何が発表されたのか 発表された機能・アップデートの全容 性能・ベンチマーク 競合サービスとの比較 料金・提供プラン 日本から使う方法 誰にどう効くのか まとめ 何が発表されたのか
Google DeepMindは、人型ロボットの全身制御を自律的に行うための物理AIモデルの最新版「Gemini Robotics 2」を公開しました。今回の発表は、前世代のモデルが主にアームやハンドといった「上半身の制御(table-top tasks)」に焦点を当てていたのに対し、脚部や体幹を含む「全身制御(Whole-Body Control)」へと技術的な領域を拡張した点が最大のトピックです。
本発表は研究開発段階の成果を示すデモンストレーションであり、商用製品としての即時提供ではありません。しかし、人間が生活するために設計された「狭く、雑然とした空間」において、ロボットがバランスを保ちながら複雑なタスクを遂行できる能力を示したことで、実用的な人型ロボットの実現に大きく近づいたと言えます。
発表された機能・アップデートの全容
動画内で示されたデモンストレーションから、Gemini Robotics 2の具体的な機能とアップデートの内容を紐解きます。主な実演は以下の4つに分類されます。
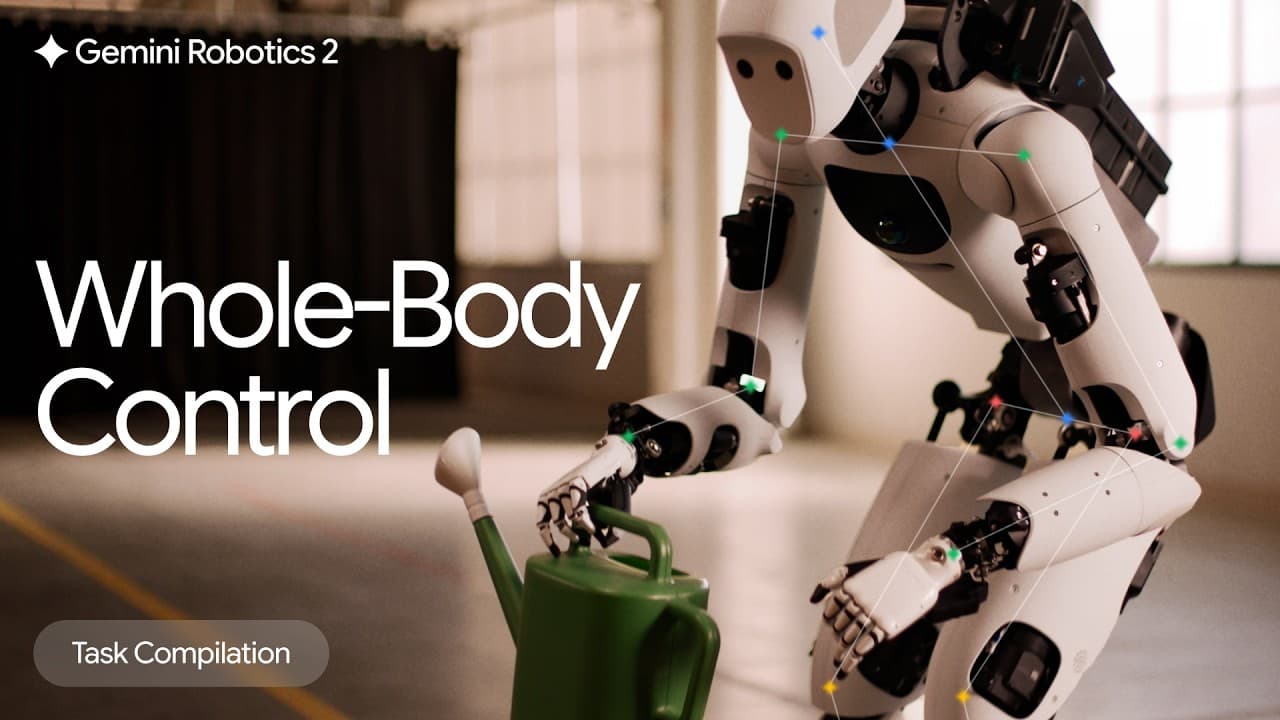
床面からのじょうろの自律的回収(重心と関節の協調)
動画の冒頭(0:04〜0:12)では、床に置かれた緑色のじょうろをロボットが自律的に拾い上げるデモが等倍速(Autonomous 1x)で紹介されています。人間にとっては容易な動作ですが、ロボットにとっては極めて難度の高いタスクです。ロボットは膝を深く曲げ、上体を前傾させながら、全身の重心を緻密に制御しています。じょうろの取っ手を正確に視覚認識し、右手でしっかりと掴んで持ち上げる一連の動作において、転倒することなくスムーズに姿勢を復元しています。
雑然とした多段棚における物体の認識と仕分け(1.5倍速自律動作)
動画の0:13〜0:56では、1.5倍速(Autonomous 1.5x)による棚の整理タスクが実演されています。棚にはサッカーボール、野球のグローブ、ヘルメット、スプレー缶などが雑然と置かれています。ロボットは、棚の高さや奥行きに合わせて自身の姿勢を動的に調整します。低い位置にあるヘルメットを回収する際には、深く腰を落とし、棚のフレームに体が接触しないよう注意深く避けています。回収したアイテムは、背後にある適切なカゴへと正確に仕分けされています。これらは、視覚的な空間認識と全身の運動計画が高度に統合されていることを示しています。
動的な環境変化への適応:落下した杖の回収と手渡し
動画の0:57〜1:15では、人間の作業支援を想定した協調動作デモが行われています。人間のアシスタントがロボットの目の前で杖を床に落とすと、ロボットはそれを視覚センサーで即座に検知します。ロボットはバランスを崩すことなく、深くしゃがみ込んで両手で杖を拾い上げます。その後、立ち上がって人間に対して手渡すような一連のシームレスな動きを見せています。事前のプログラミングによる定型動作ではなく、周囲の突発的な変化に対してリアルタイムに動作を再計画する能力の高さが伺えます。
両手を用いた重量物の持ち上げと運搬(体幹安定化)
動画の1:16〜1:30では、床に置かれた縞模様のカゴを両手で持ち上げるデモが確認できます。カゴの取っ手を両手で正確に掴み、膝と腰の力を使って垂直に持ち上げます。荷物を持ち上げた後、ロボットはそのまま歩行動作へと移行し、体幹を安定させたまま荷物を保持し続けています。荷物の重量によって変化する重心位置を、リアルタイムに計算して補正していることが分かります。
性能・ベンチマーク
今回の動画内では、具体的な数値ベンチマーク(例えば、タスクの成功率や遅延ミリ秒数など)は直接提示されていません。しかし、前世代モデルとの比較において、制御可能な自由度(DoF)やタスクの複雑さが飛躍的に向上していることが示されています。
評価項目
Gemini Robotics (前世代)
Gemini Robotics 2 (今回)
出典・根拠
制御対象
上半身(主にアームとハンド)
全身(脚部、体幹、両腕の協調)
動画テロップおよび概要欄
主な動作環境
テーブルトップ(机上作業)
雑然とした立体空間(棚、床面)
動画デモ映像
動作速度の表現
1倍速(標準的なタスク)
1倍速〜1.5倍速での自律動作
動画内「Autonomous 1x / 1.5x」表記
重心制御
不要(固定土台または上半身のみ)
必須(起立・屈伸・歩行時の動的バランス)
動画内屈伸・持ち上げ動作
(編集部注:Google DeepMindが過去に発表した「RT-2」などのVLA(Vision-Language-Action)モデルは、主に静的なアーム制御に留まっていましたが、Gemini Robotics 2では、移動や姿勢変化を伴う動的な全身制御へと進化していることが最大の違いです。)
競合サービスとの比較
現在、物理AIおよび人型ロボットの制御ソフトウェアの分野では、複数のプレイヤーが競合しています。特にOpenAIが支援するFigure AIや、TeslaのOptimus、Boston DynamicsのAtlas(電動版)などが挙げられます。各社の技術アプローチとGemini Robotics 2の位置づけを比較します。
開発元・モデル名
制御アプローチ
主な強み
弱み・課題
出典(編集部注)
Google DeepMind VLM(Gemini)統合型
高度な言語理解と、複雑な環境における動的な屈伸・バランス制御の融合。
実環境での物理的な展開規模や、産業用ロボットとしての耐久性データが未公開。
本動画およびDeepMind公式発表情報に基づく
Figure AI OpenAIモデル連携
リアルタイムの音声対話と、指先の精密な組み立て作業の連携。
歩行や屈伸時における、極端な不整地でのバランス制御の安定性。
Figure AI公式発表資料より
Tesla エンドツーエンドAI
工場ラインへの実戦配備を想定した高いハードウェア製造力と統合性。
汎用的な言語指示に対する、アドホックなタスク実行の柔軟性。
Tesla公式発表資料より
取材班の見立てでは、DeepMindの強みは「Gemini」という超巨大マルチモーダルモデルを直接ロボットの脳として統合している点にあります。これにより、事前のプログラミングなしに「散らかった部屋を片付けて」といった抽象的な指示から、全身の関節角度を計算する「Action」への変換が、極めてスムーズに行われていると考えられます。
料金・提供プラン
動画内および公式サイトにおいては、Gemini Robotics 2の具体的なライセンス料金、APIの利用価格、および一般向け・開発者向けの提供プランについての言及はありません。
現段階では、Google DeepMindによる先端研究プロジェクトとしての位置づけが強く、商用のロボットOSやAPIとして即座にデプロイできる段階ではないと推測されます。今後のGoogle Cloudなどを通じたエンタープライズ向け提供が待たれる状況です。
日本から使う方法
本技術は現在、Google DeepMindの研究段階にあり、一般の開発者が直接コードをダウンロードしたり、API経由で人型ロボットを動かしたりすることはできません。ただし、今後の展開に備えて、以下のステップで情報をキャッチアップすることをお勧めします。
公式サイトの確認 : deepmind.google/gemini-robotics(動画内1:32で提示されたURL)にアクセスし、最新の技術論文や研究アップデートをチェックします。Google Cloud Vertex AIの動向監視 : 将来的にロボティクス向けAPIが提供される場合、Vertex AIを通じてデプロイされる可能性が極めて高いです(編集部注)。シミュレータ環境の準備 : DeepMindが公開している「MuJoCo」などの物理シミュレータの利用方法を習得しておくことで、将来的にモデルが公開された際、スムーズに仮想環境でのテストが可能になります。
誰にどう効くのか
エンジニア(ロボティクス・AI開発者)
従来のロボット制御では、逆運動学(IK)や重心計算(CoG)を厳密にコーディングする必要がありました。Gemini Robotics 2のような物理AIモデルの登場により、ビジョン・ランゲージ・アクション(VLA)モデルを用いたエンドツーエンドの学習が主流になります。これにより、開発工数の大幅な削減と、未知の環境に対する堅牢性の向上が期待できます。
企画・新規事業開発担当者
物流倉庫、製造工場、介護現場など、「人間用に設計された空間」において、ロボットを導入するハードルが劇的に下がります。専用の設備投資(ロボット専用の棚や通路の設計)をすることなく、既存の施設にそのまま人型ロボットを導入できる可能性が開けるため、ビジネスモデルの策定において「ハードウェア導入コスト」の前提が変わります。
経営層・投資判断者
労働力不足が深刻化する日本市場において、自律型ロボットへの投資判断は避けて通れません。Google DeepMindのようなビッグテックが物理AIのインフラ(OS層)を押さえにかかっている現状を理解し、ハードウェア単体ではなく「どのAIモデルが搭載されているか」を基準に、中長期的なロボティクス投資を行う必要があります。
まとめ
Google DeepMindが発表した「Gemini Robotics 2」は、人型ロボットの上半身制御から「全身制御(Whole-Body Control)」への進化を決定づけるマイルストーンです。読者が取るべき次のアクションは、まず公式の研究ページ(deepmind.google/gemini-robotics)で公開される論文を読み解き、自社の既存業務(倉庫、店舗、工場)における「全身運動を伴う作業」の自動化ロードマップを再検証することです。
動画のタイムテーブル 0:00 Gemini Robotics 2 タイトル表示 0:04 自律動作による「じょうろの拾い上げ」デモ(1倍速) 0:13 雑然とした棚からの「複数オブジェクトの仕分け」デモ(1.5倍速) 0:57 人間が落とした杖を検知し、拾い上げるデモ(1倍速) 1:16 床に置かれたカゴを両手で持ち上げるデモ(1倍速) 1:32 公式サイト案内およびGemini Robotics 2 ロゴ表示 記事で紹介したツール
この機能を、いま自分の環境で試す 記事の内容は公式発表の要約です。実際の使い勝手は触ってみないと分かりません。多くは無料枠から始められます。
公式サイトで試す→ 提供: OpenAI
本記事は元動画の映像・音声をAIが解析して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元動画を見る (解析モデル: gemini-3.5-flash)