要約版:専門用語を控えて説明しています
2つの新しい構成
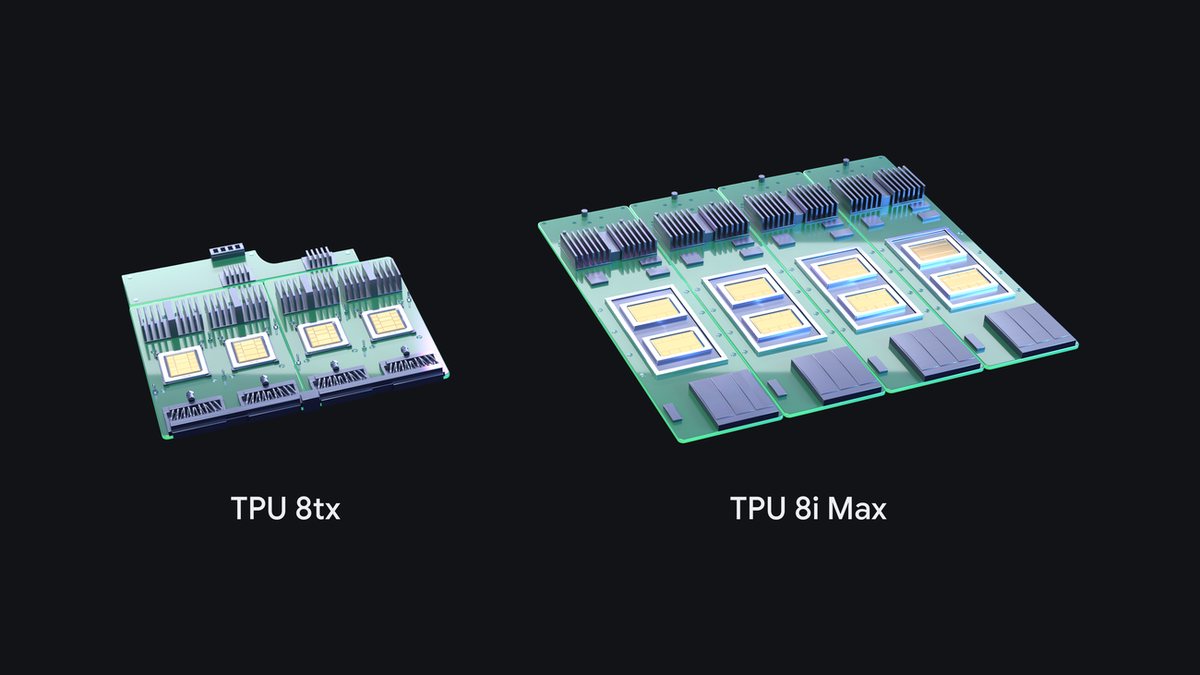
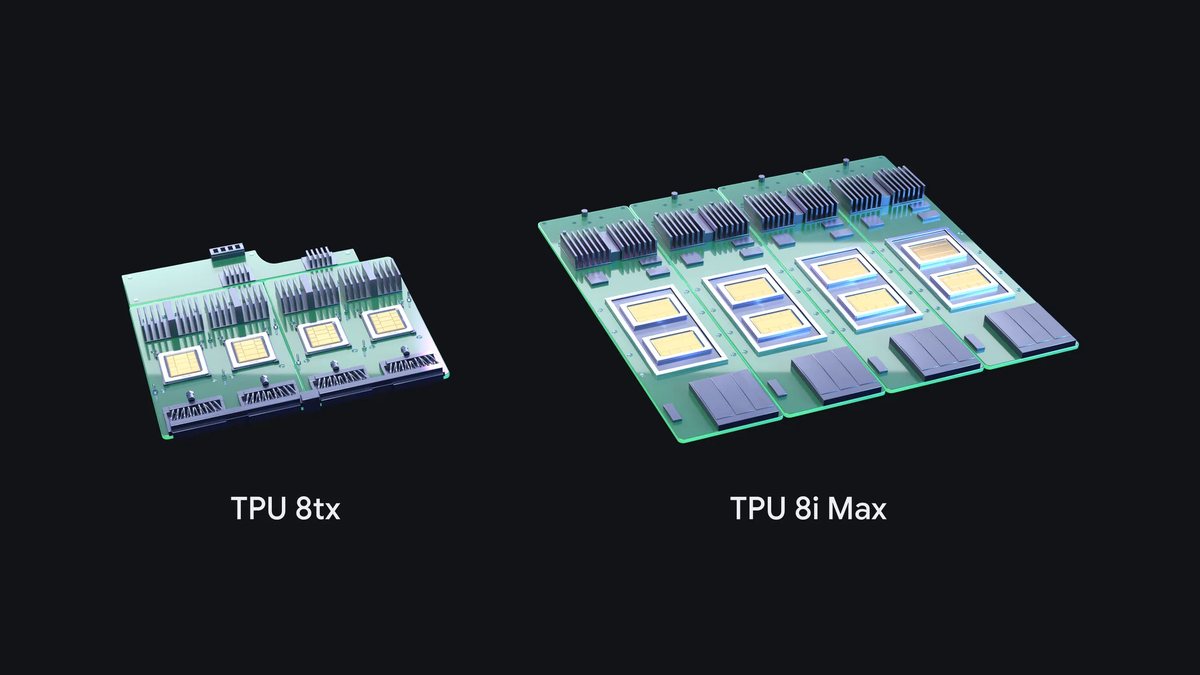
「TPU 8tx」は、使っている最中のデータも暗号化で守れるのが特徴です。金融機関や政府のように、扱うデータの規制が厳しい組織を想定しています。
「TPU 8i Max」は、従来の8iのチップを2つ1つにまとめたものです。計算量とメモリの速度が、8iの2倍になります。
開発者が使いやすくなる周辺ソフト
PyTorch(AI開発で広く使われる道具)のコードを書き換えずにTPUで動かせる「TorchTPU」は、先月オープンソースになりました。
TPUの設定を自動化するツールも、プレビュー版として出ています。
TPU 8txと8i Maxは、企業や開発者向けのAI基盤に使う構成です。Googleの発表では、日本での提供や価格、提供開始日は示されていません。
TPU(テンソル・プロセッシング・ユニット)は、Googleが設計したAI専用のチップです。Googleは自社のGeminiの学習や運用、Google Cloudの顧客向けサービスに使っています。Google公式ブログによると、TPUの顧客は100社近くまで増えています。
 画像:Google(公式発表)
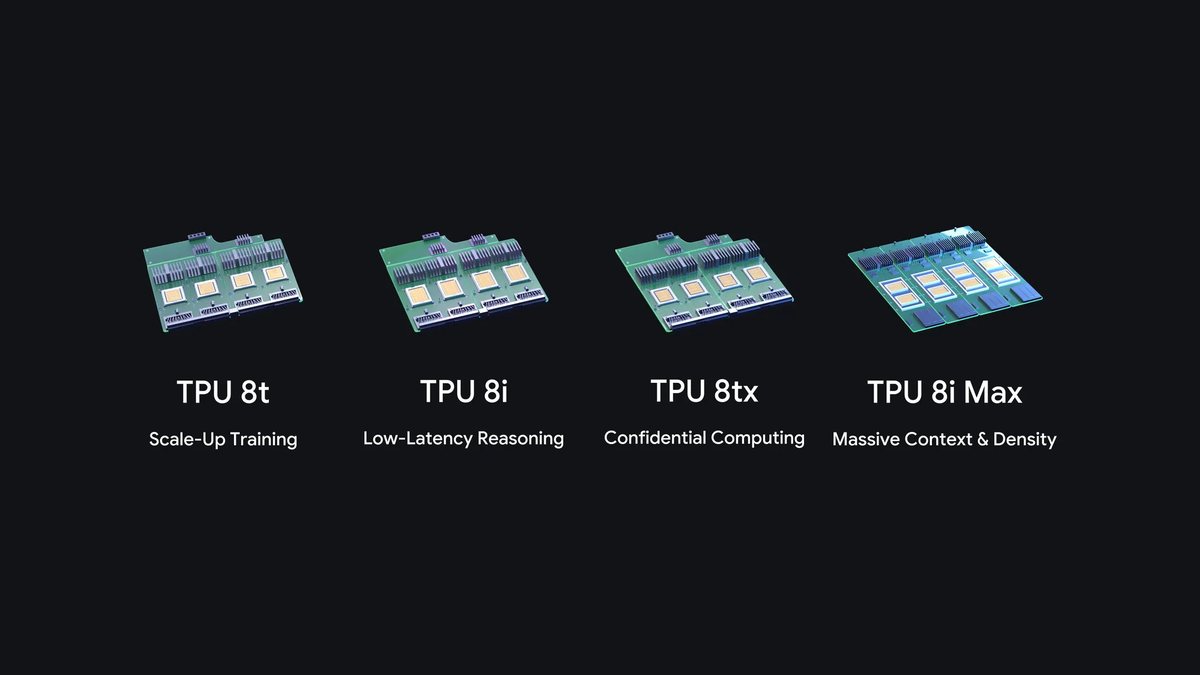
第8世代は学習・推論向けの4構成に
Googleは4月のGoogle Cloud Nextで、第8世代の「8t」と「8i」を発表していました。8tは大規模な学習用、8iはリアルタイムの推論(学習済みAIが答えを出す処理)用です。ブログによると、8tは前世代より学習性能が最大2.7倍、8iは推論の価格性能が80%向上しました。
今回の2つを加え、Googleが1年に4つのTPUシステムを発表するのは初めてです。新たにチップを設計するのではなく、既存チップの周りの計算・通信・保存を組み合わせた構成を変えました。この方法により、専門用途向けのスーパーコンピューターを数年ではなく数か月で提供できると説明しています。
 画像:Google(公式発表)
TPU 8txは処理中の機密データを保護
TPU 8txは、機密性の高い推論に向けた構成で、小規模な学習にも使えます。規制の厳しい企業や政府が、独自のモデルやエージェント(自分で手順を進めるAI)を、機微なデータと一緒に動かすことを想定しています。
通常、データは保存中や通信中は暗号化されますが、処理中はメモリ上で復号が必要です。8txはTPU 8tと同じチップに、第5世代のAMD EPYC CPUを組み合わせ、使用中も機密データとモデルの重みを保護・隔離します。
通信にはリアルタイム推論向けの「Boardfly」ネットワークを採用しました。Googleによると、8tと比べて遅延は最大で半分になり、性能の低下はほぼありません。
同じシステムで、社内データによるファインチューニング(追加学習)や、大きなモデルを小さくする蒸留、強化学習ができます。機密データを別のクラスターへ移す必要はありません。
あわせて読みたいGoogle、TPU向け「TorchTPU」をオープンソース公開 PyTorchをそのまま実行→TPU 8i Maxは計算能力とHBM帯域が2倍
TPU 8i Maxは、8iのチップ2つを1つのパッケージにまとめた構成です。ブログによると、計算能力、SRAM、HBM(高速メモリ)の帯域がいずれも8iの2倍です。
多数のエージェントがコード全体や長い動画を同時に扱うと、メモリ帯域が処理の制約になります。8i Maxは、この「メモリの壁」に対応する構成です。
既存のラックと同じ設置面積に2倍のシリコンを収められます。Googleは、設置面積と電力あたりの計算能力も大幅に高められるとしています。
PyTorch対応やTPUの運用を助けるソフト
ソフト面では、複数の機能が同時に示されました。
- TorchTPU(PyTorchのコードをTPUで動かす仕組み)は先月オープンソースになり、Hugging Faceのモデルも動きます(Google、TPU向け「TorchTPU」をオープンソース公開)
- TPU Agent Suiteはプレビュー版で、Claude Code、Cursor、Google Antigravityなどに組み込み、TPUへの移行や速度改善を自然な言葉で進められます
- TPU Syncはオープンソースで公開され、KV cacheをチップの外に移すなどして、KV転送の遅延と最初の応答までの時間(TTFT)を90%以上縮めるとしています
- Cloud Pathways(複数のTPUを1台のように扱う仕組み)は、GKE(GoogleのコンテナのKubernetes基盤)で一般提供になりました
- GKEのdynamic slicingも一般提供で、ジョブの開始が最大5倍、障害からの復旧が最大4.5倍速くなるとしています
ブログは、InferenceXとAgentXというベンチマーク(性能テスト)でも結果を示しています。TPU上のvLLMとTorchTPUの組み合わせは、価格あたりの性能で最高水準だったとされています。測定条件の詳細はブログには示されていません。
TPUの提供先は広がっており、Oracleは2027年からOCIでTPUを導入する予定です(Google CloudとOracle、OCIでGoogle TPUを提供へ)。
価格・提供時期・測定条件は発表で示されず
- TPU 8txと8i Maxの価格は、Googleの発表では示されていません
- 提供開始の時期と、日本のリージョン(提供地域)で使えるかも示されていません
- 8txの遅延や8i Maxの2倍の数字について、測定条件の詳細は示されていません
判断ガイド
8txと8i Max、どちらを検討するか
状況ごとのおすすめと理由です。どれを選ぶかは、ご自身の状況で決めてください。
機密データを扱うなら8txと8i Maxどちら?
- 状況
- 機密データをAIで処理したい企業
- おすすめ
- 8txの仕様を先に確かめる
- 理由
- 8txは処理中もデータとモデルの重みを守る構成、8i Maxは長い入力と計算密度向けと説明されています。機密性と入力の長さ、どちらが課題かで選ぶ材料になります。
- 出どころ
- 出典・blog.google
個人が今すぐ8txや8i Maxを試すべきか迷う
- 状況
- 個人で使いたいと考えている
- おすすめ
- 急がなくてよい
- 理由
- このページには、個人向けの提供や価格、提供開始日の記載がありません。使えるかどうかは、今後の公式発表を待って確かめるのが確実です。
- 出どころ
- 出典・blog.google
不安Q&A
機密データや個人利用は大丈夫?
Q個人が今すぐ8txや8i Maxを使えるのか知りたい▾
このページでは、8txは規制の厳しい企業や政府向けの構成と説明されています。個人向けにどう提供されるかは、このページには書かれていません。
出典・blog.google今できること個人で使う予定なら、公式ブログの対象の説明を読み、自分の用途に合うかを確かめておく。
Q機密データは、AIが処理している間も守られるのか▾
8txは、データとモデルの重みを使用中も守る仕組みをハードウェアの層で作ると説明されています。ただし、細かな条件や保証の内容は、このページには書かれていません。
出典・blog.google今できること社内の機密データでAIを使う前に、提供元が守る範囲を契約や公式資料で確かめる。
Q速さは本当に上がる?数字はどう見ればいい?▾
8txは8tと比べて遅延が最大2倍低く、性能の低下はほぼないと説明されています。ただし、どの条件で測った数字かは、このページには示されていません。
出典・blog.google今できること数字を社内の導入判断に使う前に、測定条件を提供元に問い合わせて確かめる。
Q長いコードや動画を扱う仕事にも関係ある?▾
8i Maxは、多数のエージェントがコード全体や長い動画を同時に扱う場面を想定し、HBMの帯域を8iの2倍にした構成と説明されています。
出典・blog.google今できること長いコードや動画を扱う業務があるなら、8i Maxの説明を読み、自社の処理の重さと比べてみる。