何が入っているのか
1件のデータには、年齢や職業、世帯の資産、お金への考え方など50項目があります。100万件の記録に、それぞれ9人の人物像が書かれています。名前や設定はすべて合成されたもので、実在の人物ではありません。
使うには
ライセンスはCC BY 4.0で、商用利用もできます。Hugging Faceから、Pythonのコード数行で読み込めます。銀行や保険会社、その取引先のほか、日本語のAIを作る人も対象です。
画像:Hugging Face(公式発表より)
本ページはプロモーションを含みます
金融向けの日本語ペルソナ900万件が公開。100万件×各9人で、世帯の資産や金融リテラシーを含む
要約版:専門用語を控えて説明しています
1件のデータには、年齢や職業、世帯の資産、お金への考え方など50項目があります。100万件の記録に、それぞれ9人の人物像が書かれています。名前や設定はすべて合成されたもので、実在の人物ではありません。
ライセンスはCC BY 4.0で、商用利用もできます。Hugging Faceから、Pythonのコード数行で読み込めます。銀行や保険会社、その取引先のほか、日本語のAIを作る人も対象です。
NVIDIAとElithの公式ブログによると、対象は日本で金融AIを作る銀行・保険会社、それを支えるスタートアップやシステム会社です。一般の利用者の手続きや契約が変わる話ではありません。日本語AIを作る人なら、金融以外でも使えます。
「Nemotron-Personas-Finance-Japan」は、実在しない日本人の人物像(ペルソナ)を大量にそろえたデータセットです。顧客対応AIの試験や学習に使います。
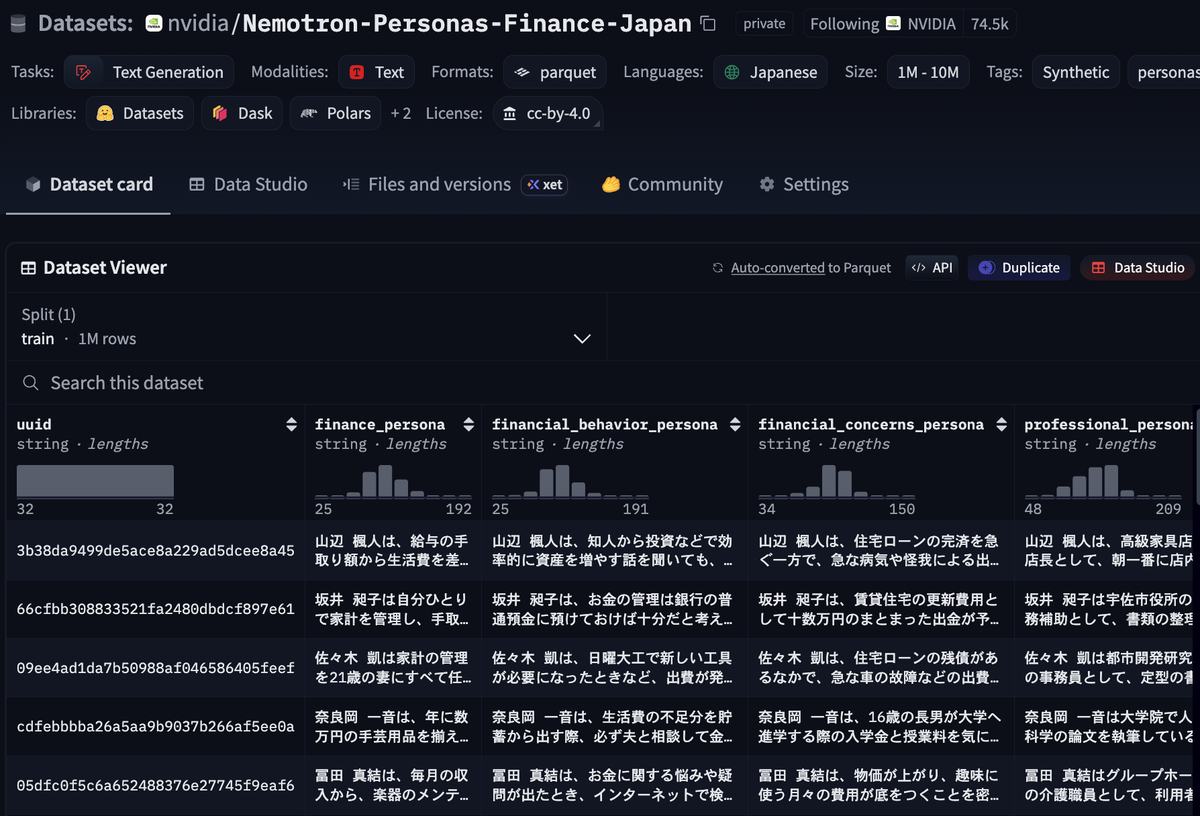
構成は、100万件の記録にそれぞれ9人のペルソナが付く形で、合計900万件です。ブログによると、自然な日本語で書かれています。
主な規模は次のとおりです。
従来の「Nemotron-Personas-Japan」より件数は5割多く、項目は22から50に増えました。
このデータの特徴は、人口や職業の統計に、世帯の金融資産・実物資産、収入や消費の傾向、インターネットやスマートフォンの利用、金融リテラシー(お金の知識)を組み合わせた点です。ブログは、日本の公的統計と家計・金融リテラシーのデータを組み合わせた百万件規模のオープンなペルソナデータは、自社の知る限り初だとしています。
統計が粗く集計している部分は補っています。学歴は細かく分け、職業は経営者や専門職を追加しました。学生、退職者、失業中といった統計で目立たない時期も作っています。
データセット上の人物像は、たとえば長男の進学費用を預貯金や保険で賄う計画や、親の介護費用として数百万円を確保している計画などです。実際の人の記録ではなく、統計の分布から作られています(Hugging Faceのデータセットページ、11/10確認)。
作成には、NVIDIAの合成データ生成の仕組み「NeMo Data Designer」と、統計に沿ってデータを作る「NeMo SDG-PGMs」が使われました。日本語の文章生成には「gemma-4-31B-it」が使われています。どちらもApache-2.0ライセンスです。
設計には、損保ジャパン、東京海上ホールディングス、福岡銀行、みずほフィナンシャルグループ、明治安田生命、金融データ活用推進協会(FDUA)の意見が反映されたとしています。
ライセンスはCC BY 4.0で、商用・非商用のどちらでも使えます。入手は次のコードです。
from datasets import load_dataset
ds = load_dataset("nvidia/Nemotron-Personas-Finance-Japan")
ブログが挙げる用途は次のとおりです。
ユーザーシミュレーションの枠組み「NeMo User Sim」と連携でき、実世界の分布に沿った模擬対話をすぐ動かせるとしています。
同じ日に「Nemotron-PII-Japan」も公開されました。個人情報に印を付けた日本語の業務文書10万件で、検出や黒塗りのモデルの学習・試験に使います。顧客の模擬にはFinance-Japan、個人情報の保護の確認にはPII-Japanを使う組み合わせです。
発表内容をもとにした一般的な情報です。導入や契約の判断は、公式情報を確かめたうえでご自身で行ってください。
金融AIを作る人は、Hugging Faceで中身を確認し、対話の試験データとして使えるか試すとよいでしょう。
11/10時点の判定。発表内容をもとにAIで判定しています。最新の提供状況は公式情報をご確認ください。
 同じ話題の記事提供前現代
前日に出た記事から大きな発表を選び、1本2行でまとめてメールで届けます。無料・いつでも解除できます。
主要企業の大きな発表だけ、1日4回まで。夜22時〜朝7時は鳴らしません。いつでも解除できます。
本記事は公式発表の文章をもとにAIが要約・解説して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元記事を読む制作方法と事実確認の手順は編集方針をご覧ください。誤りのご指摘はお問い合わせから受け付けています。