実在の人を使わないデータです
データは公的な統計をもとに作った合成ペルソナ(架空の人物像)です。年齢や職業に加え、世帯の資産、金融リテラシー、お金への不安なども含まれます。
実在する個人の記録ではないため、顧客データを用意しなくても、問い合わせ対応AIなどの試作や評価に使えます。
使うには
Hugging Faceからダウンロードできます。主な対象は、銀行や保険会社、その開発を担うスタートアップなどです。一般の利用者が何か手続きをする必要はありません。
本ページはプロモーションを含みます
日本の金融向け合成ペルソナ900万件が、CC BY 4.0で無料公開され商用利用もできる
画像:Hugging Face(公式発表より)
なるほど
要約版:専門用語を控えて説明しています
データは公的な統計をもとに作った合成ペルソナ(架空の人物像)です。年齢や職業に加え、世帯の資産、金融リテラシー、お金への不安なども含まれます。
実在する個人の記録ではないため、顧客データを用意しなくても、問い合わせ対応AIなどの試作や評価に使えます。
Hugging Faceからダウンロードできます。主な対象は、銀行や保険会社、その開発を担うスタートアップなどです。一般の利用者が何か手続きをする必要はありません。
日本の銀行や保険会社、その開発を担うスタートアップやシステムインテグレーターは、実際の顧客データを使わずに金融AIを試せるようになります。一般の利用者が手続きをする必要はなく、今の金融サービスが変わるわけでもありません。
Nemotron-Personas-Finance-Japanは、日本の人口分布や家計の状況を再現した架空の人物像(ペルソナ)のデータセットです。AIの動作確認や評価のために使います。
Hugging Face公式ブログによると、NVIDIAとElithが公開しました。ライセンスはCC BY 4.0で、商用・非商用を問わず使えます。
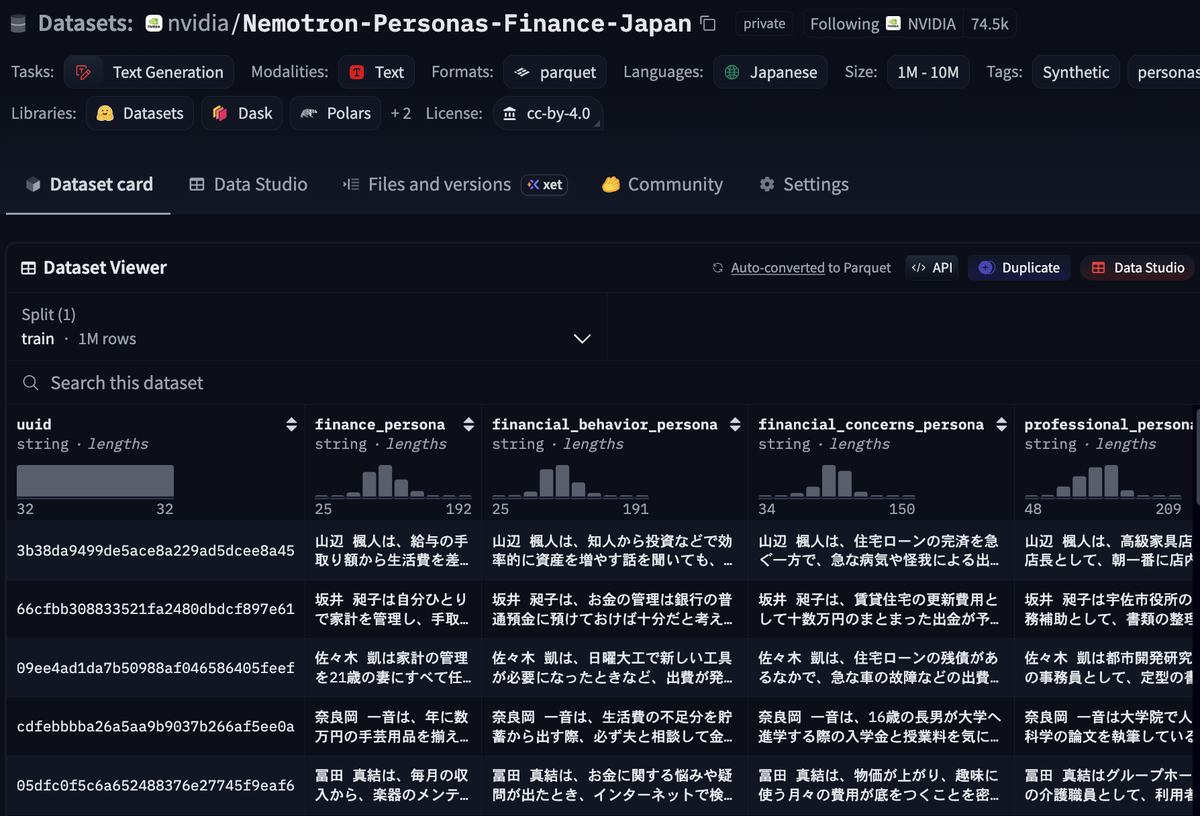
データは100万レコードで、1レコードに9人分のペルソナが入っています。合計では900万件です。文章は自然な日本語で書かれています。
1レコードの50項目は、次の内訳です。
総トークン数(AIが文字を数える単位)は約15億で、うち約7億5,000万がペルソナ関連です。固有の名前は約95万件、職種カテゴリーは1,600以上あります。
職業、スポーツ、芸術、旅行、料理、金融、金融行動、金銭面の不安など、幅広いタイプを含みます。文化的背景、キャリア目標、世帯・親・経済面の背景、お金に対する考え方、今後の資金計画も自然言語で記述されています。
Hugging Faceのデータセットのページでは、たとえば次のような記述が確認できます。
(Hugging Faceのデータセットのページ、11/10確認)
元になったのは、オープンソースのNemotron-Personas-Japanです。今回の拡張版は、日本の公的統計と、家計の財務状況や金融リテラシーに関するデータを組み合わせています。ブログは、この組み合わせの100万件規模のオープンなデータセットとしては「私たちの知る限り」初めてだとしています。
加えた観点は次の5つです。
すべてのペルソナは合成されたもので、実在の個人をモデルにしていません。名前は実際の日本の命名規則に従っています。
規模も項目も、従来のNemotron-Personas-Japanより増えました。
従来版→900万件50%増
22→5028増
ブログは、これにより日本語プロジェクトで、訓練やテストに使える人口層をより細かく分けて使えるとしています。
データはHugging Faceから、次のコードで読み込めます。
from datasets import load_dataset
ds = load_dataset("nvidia/Nemotron-Personas-Finance-Japan")
生成にはNVIDIAの合成データ生成用フレームワーク、NeMo Data Designerを使っています。統計に基づく生成のための確率的グラフィカルモデルNeMo SDG-PGMs(Apache-2.0)と、日本語の文章生成用のgemma-4-31B-it(Apache-2.0)も使われています。
Nemotron-Personasのコレクションは、ユーザーシミュレーションのフレームワークNeMo User Simと連携できるよう設計されています。
想定される用途は次のとおりです。
データの開発には、損害保険ジャパン、東京海上ホールディングス、福岡銀行、みずほフィナンシャルグループ、明治安田生命保険相互会社、金融データ活用推進協会(FDUA)の知見やフィードバックが参考にされています。
同じ日に公開されたNemotron-PII-Japanには、ラベル付きの個人情報を含む日本語の合成ビジネス文書が10万件入っています。PIIは個人を特定できる情報のことです。
ブログは、Finance-Japanで顧客を模擬し、PII-Japanで個人情報の保護ができているかをテストする使い方を挙げています。サイソクは、データの概要を別の記事でも報じています(日本の金融AI向け合成ペルソナ900万件が無料公開)。
判断ガイド
状況ごとのおすすめと理由です。どれを選ぶかは、ご自身の状況で決めてください。
不安Q&A
すべてのペルソナは完全に合成されたもので、実在する個人をモデルにしていません。人口統計や家計の財務状況は公的統計や公開調査データに基づき、名前は日本の命名規則に従っています。
出典・huggingface.co今できること一般の利用者が手続きをする必要はないと書かれているため、今すぐ何かを変える必要はありません。
ブログによると、本データは実際の顧客データを使わずに利用でき、一般の利用者が手続きをする必要はなく、今の金融サービスが変わるわけでもないとされています。
出典・huggingface.co今できることこの発表で利用者が行う手続きは書かれていないため、この記事の範囲では対応は不要です。
CC BY 4.0のもとで公開され、商用・非商用を問わず利用できます。データセットページからライセンス条項の文言を確認できます。
出典・huggingface.co今できること自社製品に組み込む前に、ライセンス条項を読んで表示の方法を決めておきましょう。
出典・huggingface.co
各ペルソナの品質を測る評価結果の数字は、ブログではまだ示されていません。まず少量を読み込み、想定顧客層と分布が合うかを確かめる方法が示されています。
出典・huggingface.co今できること100万行のデータを数件開いて、想定する顧客像と合うかを自社で確認しましょう。
Hugging Faceのdatasetsライブラリで、nvidia/Nemotron-Personas-Finance-Japanを指定して読み込めます。データは100万行の1つの区分にまとまっています(Hugging Faceのデータセットのページ、11/10確認)。
GitHubには、Nemotron-Personas-JapanのペルソナにAzure OpenAIのバッチAPIでアンケートを実施するC#ライブラリがあります。自由記述、Yes/No、選択式の3形式に対応します(GitHubのプロジェクトページ、11/10確認)。
CC BY 4.0は、出典の表示などの条件を守れば商用でも使えるライセンスです。自社の製品に組み込む前に、ライセンス条項と表示の方法を確認する必要があります。
まず少量を読み込み、自社の想定顧客層とペルソナの分布が合うか、記述が業務シナリオに使えるかを見るとよいでしょう。
 同じ話題の記事提供中日本の
背景
金融業界は、厳格なプライバシー保護や規制への準拠から実データの利用に大きな制約があります。そのため、実際の顧客データを使わずに人口分布や資産状況を再現できる合成データが必要とされ、今回の公開につながりました。
出典・huggingface.coすぐにできること
Hugging Faceのnvidia/Nemotron-Personas-Finance-Japanを開き、100万行の中身を数件確認する
CC BY 4.0の条項を読み、自社製品に組み込むときの出典表記を決める
顧客向けAIのテストで確かめたい属性の条件を洗い出す
公式窓口
SMSやメールに書かれた連絡先ではなく、ここにある公式の窓口を使ってください。
Nemotron-Personas-Finance-Japan データセットページ(Hugging
Dataset Viewer で列と行を確認でき、Expand in Data Studio から広げて見られる。
公式ページを開く(huggingface.co)Creative Commons Attribution 4.0 International Lic
データセットページからこのライセンス条項へ移れる。
公式ページを開く(creativecommons.org)発表内容をもとにした一般的な情報です。導入や契約の判断は、公式情報を確かめたうえでご自身で行ってください。
実顧客データを使わず試作や評価をしたい開発チームは、Hugging Faceで中身を確認するとよいでしょう。
11/10時点の判定。発表内容をもとにAIで判定しています。最新の提供状況は公式情報をご確認ください。
前日に出た記事から、給付・税・料金・値上げなど暮らしとお金に関わる話を中心に選び、1本2行でまとめてメールで届けます。無料・いつでも解除できます。
主要企業の大きな発表だけ、1日4回まで。夜22時〜朝7時は鳴らしません。いつでも解除できます。
本記事は公式発表の文章をもとにAIが要約・解説して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元記事を読む制作方法と事実確認の手順は編集方針をご覧ください。誤りのご指摘はお問い合わせから受け付けています。